Premiera / Narzędzie
Nowy benchmark Supabase pokazuje, czego agenty nie doczytują
Supabase 31 lipca udostępnił Evals, otwarty benchmark, który uruchamia agenty AI na żywej bazie i sprawdza, jak stawiają schemat i reguły bezpieczeństwa, a nie tylko czy piszą poprawny kod. Powód jest konkretny: ponad 60% nowych baz zakłada u firmy narzędzie AI, a nie człowiek. Najciekawsze okazały się nawyki agentów, czyli ręczne migracje mimo deklaratywnego schematu i rozjazd w czytaniu dokumentacji, gdzie Codex zaglądał średnio do ośmiu stron na scenariusz, a Claude Code do dwóch. Test projektuje jednak sam Supabase, który na każdym agencie zarabia, więc nie jest neutralny.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
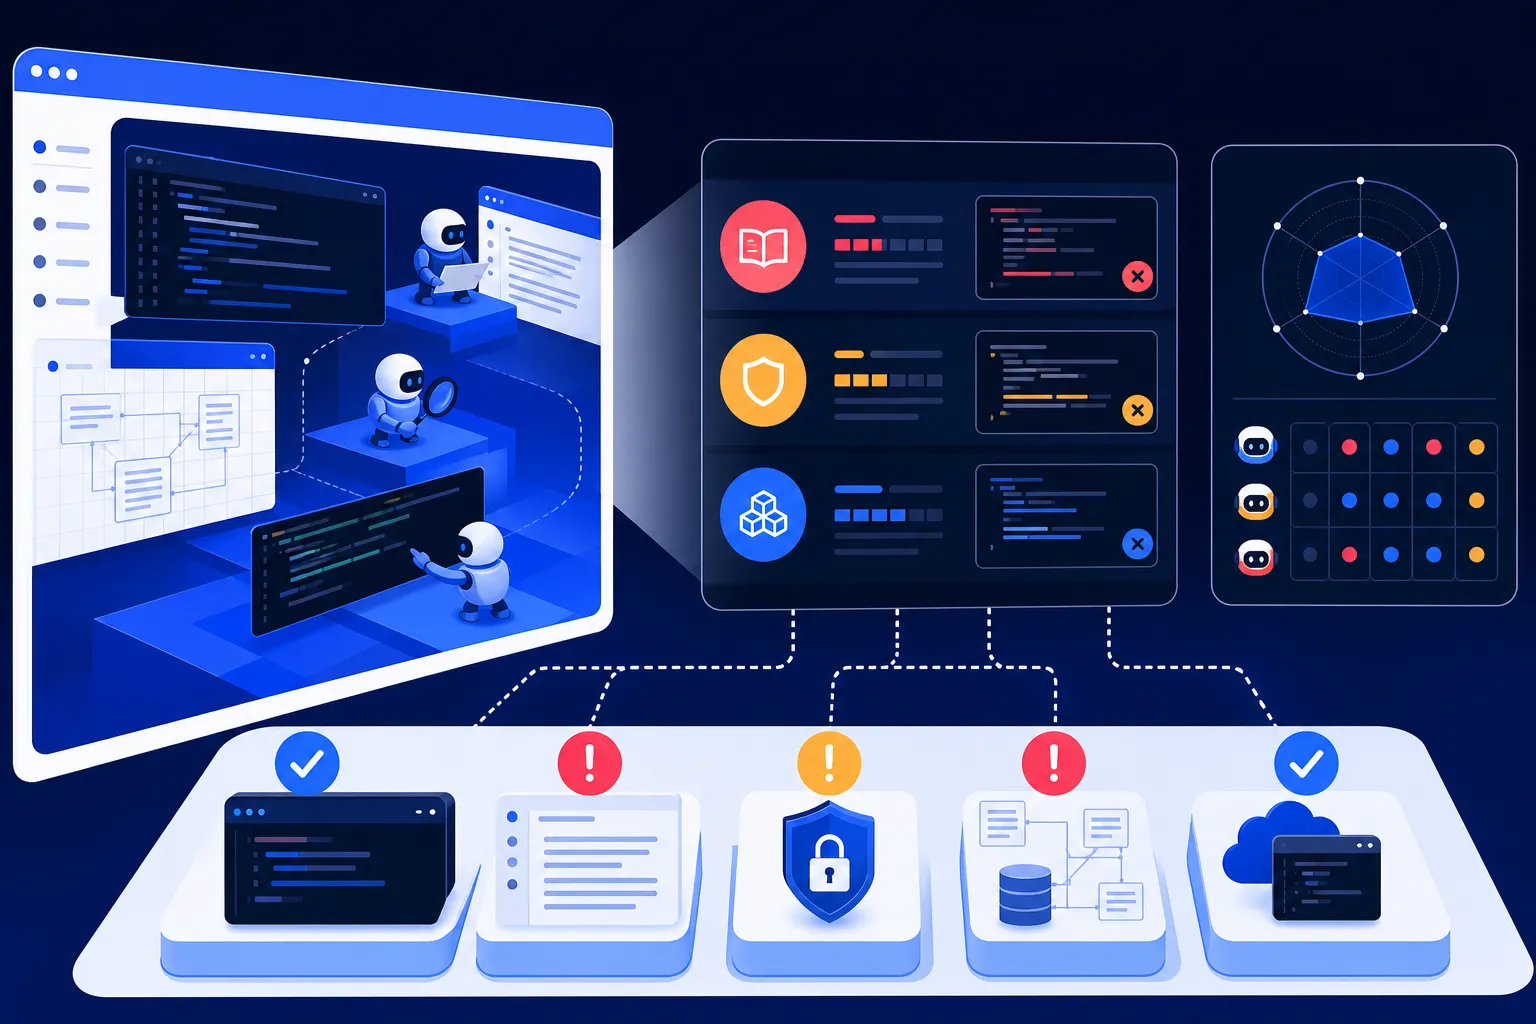
Agent dostaje projekt, w którym baza jest opisana deklaratywnie: cały docelowy kształt schematu leży w jednym pliku, a narzędzie samo dolicza, co trzeba w bazie zmienić. Agent i tak zabiera się za pisanie migracji ręcznie, kolejnymi poleceniami ALTER, jakby tego pliku w ogóle nie było. Dokładnie takie zachowanie wyłapał Supabase Evals, otwarty benchmark, który Supabase udostępnił 31 lipca i którym mierzy, jak dobrze agenty AI budują aplikacje na jego platformie.
Na Supabase deweloper stawia całe zaplecze aplikacji na Postgresie: bazę danych, obsługę logowania i reguły pilnujące, kto ma dostęp do których danych, a nad tym wszystkim API. Powód, dla którego firma w ogóle zbudowała taki benchmark, jest bardzo konkretny. W czerwcu podała, że ponad 60% nowych baz zakłada u niej nie człowiek klikający w panelu, tylko narzędzie AI działające w jego imieniu. Skoro agenty stały się głównym klientem, to od tego, czy potrafią poprawnie postawić schemat, funkcję i reguły bezpieczeństwa, zależy, czy deweloper zostanie na platformie, czy odbije się od niej po pierwszej wpadce.
Najmniej ciekawą rzeczą w całym Evals jest sama tabela. Czołowe modele zaliczają prawie wszystko: Claude Opus 5 i chiński Kimi K3 przeszły na etapie budowania każdy scenariusz bez żadnej dodatkowej pomocy, a słabsze doganiają je, gdy dogra im się wskazówki (Sonnet 5 skoczył z 78% na komplet). Liczy się dopiero drugi zapis: jak agent faktycznie zachowuje się przy prawdziwej robocie.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.