SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

92% na domowym teście, 36% na obcym: ile naprawdę zmienia agent od testów

Microsoftowy agent code-testing-generator, wydany na licencji MIT, najpierw czyta repozytorium, żeby wpasować testy w konwencje projektu, a na końcu sam psuje własny kod i sprawdza, czy test to wyłapie. Na wewnętrznym sprawdzianie Microsoftu zaliczył 92% i o 63% mniej porażek niż GitHub Copilot na tym samym modelu, ale cały zysk skupia się w ogólnikowych poleceniach typu "napisz testy". Na niezależnym benchmarku SWE Atlas wynik spada do 36,4% wobec 27,3% u Copilota. To nie przełom, tylko rusztowanie, które pilnuje, żeby testy w ogóle coś wykrywały.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  3 min  · 
92% na domowym teście, 36% na obcym: ile naprawdę zmienia agent od testów
Ilustrację przygotowała AI.

Najcichszy sposób, w jaki test potrafi zawieść, wygląda tak: kompiluje się, przechodzi u ciebie na maszynie i nigdy nie rusza w CI, bo nikt nie wpiął go w komendę, która testy uruchamia. Microsoft twierdzi, że jego agent do pisania testów jednostkowych, code-testing-generator, pilnuje dokładnie tego przypadku. Pisałem o nim tydzień temu, gdy firma wypuściła go na licencji MIT. Wracam, bo doszły dwie rzeczy, których wtedy nie było: niezależny test i głos z zewnątrz, który dość celnie nazywa, co to narzędzie naprawdę zmienia, a czego nie.

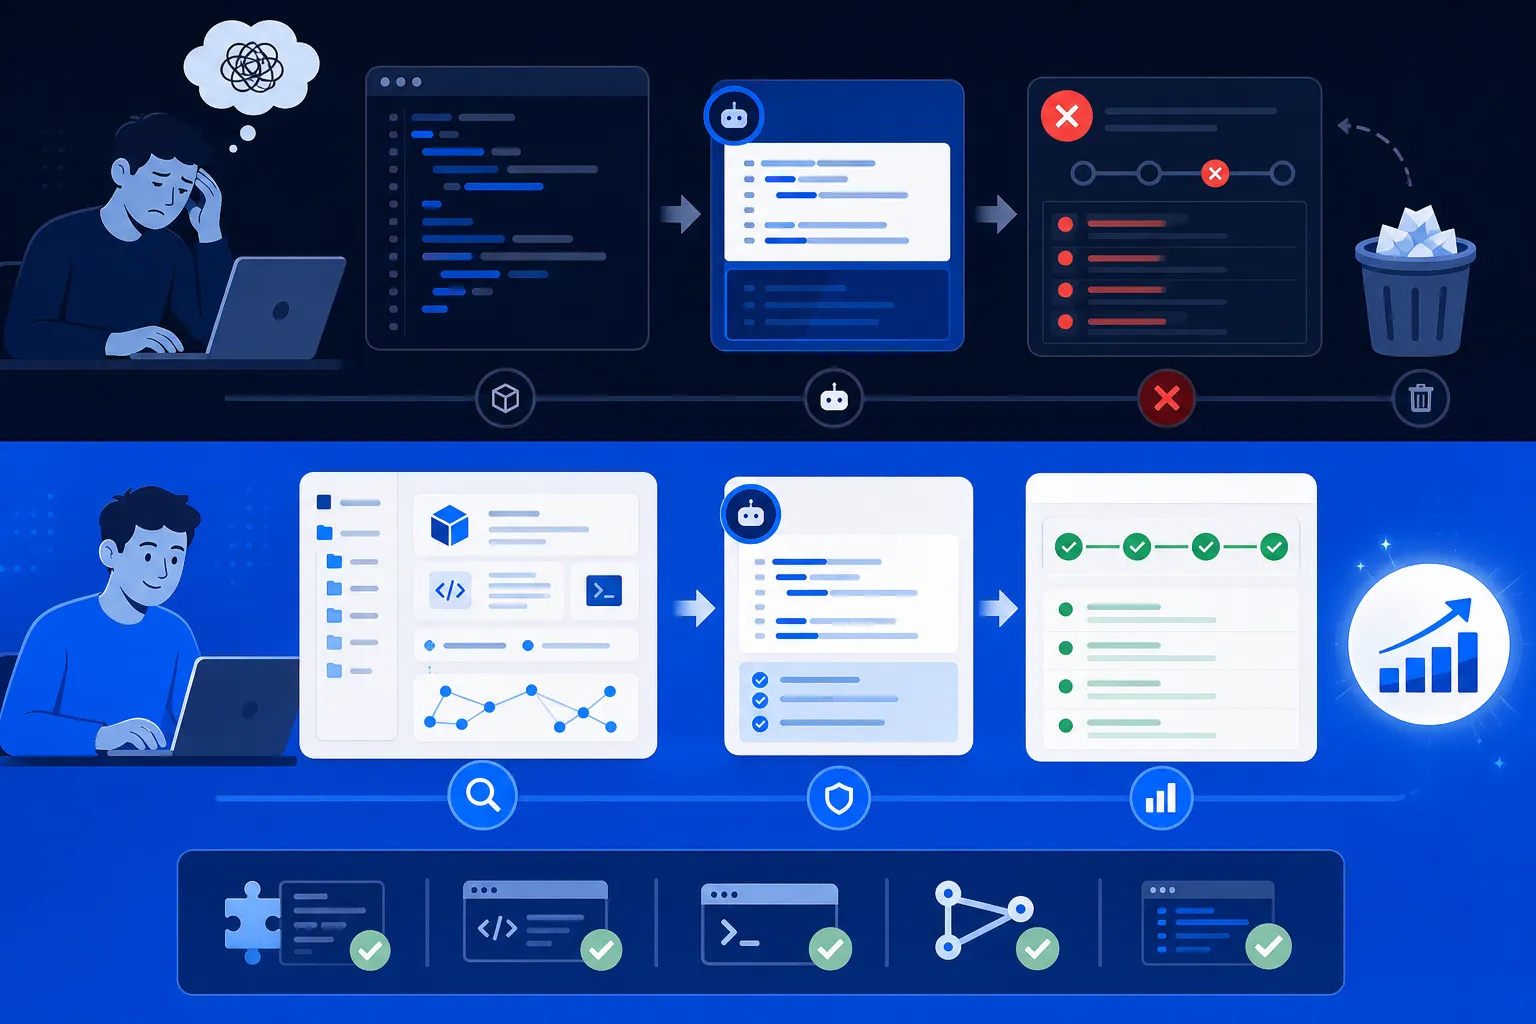
Sam pomysł jest prosty. Zamiast generować testy prosto z jednego polecenia, agent najpierw czyta repozytorium: wykrywa język, znajduje framework testowy, podgląda istniejące testy, żeby złapać konwencje projektu, i ustala prawdziwe komendy budowania oraz uruchamiania. Skalę pracy dobiera do zadania, bo pojedynczą metodę bierze od razu, a pokrycie całego podsystemu rozkłada na powtarzane rundy, aż dobije do wyznaczonego celu. Dopiero potem pisze testy, odpala je i sprawdza to, co napisał. Nie dotyka kodu produkcyjnego i omija testy, które biją do sieci, otwierają porty albo zależą od zegara, czyli te, które później losowo się wywalają.

Całe to rozeznanie nie jest ozdobą. Gołe polecenie "napisz testy" nie mówi, którego frameworka użyć, gdzie położyć pliki ani jakich asercji się trzymać, więc klasyczny asystent po prostu zgaduje, a jego testy często nie kompilują się albo nie przechodzą, dopóki ktoś ich ręcznie nie posprząta. Agent, który najpierw pozna projekt, wpasowuje się w istniejący kod, zamiast produkować ogólne przykłady oderwane od reszty.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Microsoft otwiera agenta, który czyta repozytorium, zanim napisze testy Premiera / Narzędzie

Microsoft otwiera agenta, który czyta repozytorium, zanim napisze testy

4 min

Microsoft udostępnił na licencji MIT agenta code-testing-generator, który zanim napisze testy jednostkowe, przeszukuje repozytorium, wykrywa język i framework oraz ustala prawdziwe komendy budowania. Na wewnętrznym benchmarku ze 152 zadań zaliczył 140 wobec 120 Copilota na tym samym modelu, czyli o 63% mniej porażek. Cały zysk skupia się w ogólnikowych poleceniach typu „napisz testy”, gdzie liczba porażek spadła z 30 do 10; przy szczegółowych promptach oba wypadły tak samo. To nie przełom, tylko porządne rusztowanie automatyzujące nudne rozeznanie pomijane przy jednej linijce polecenia.

25% na testach w C++: nowy benchmark pokazuje, gdzie agenty się sypią Premiera / Narzędzie

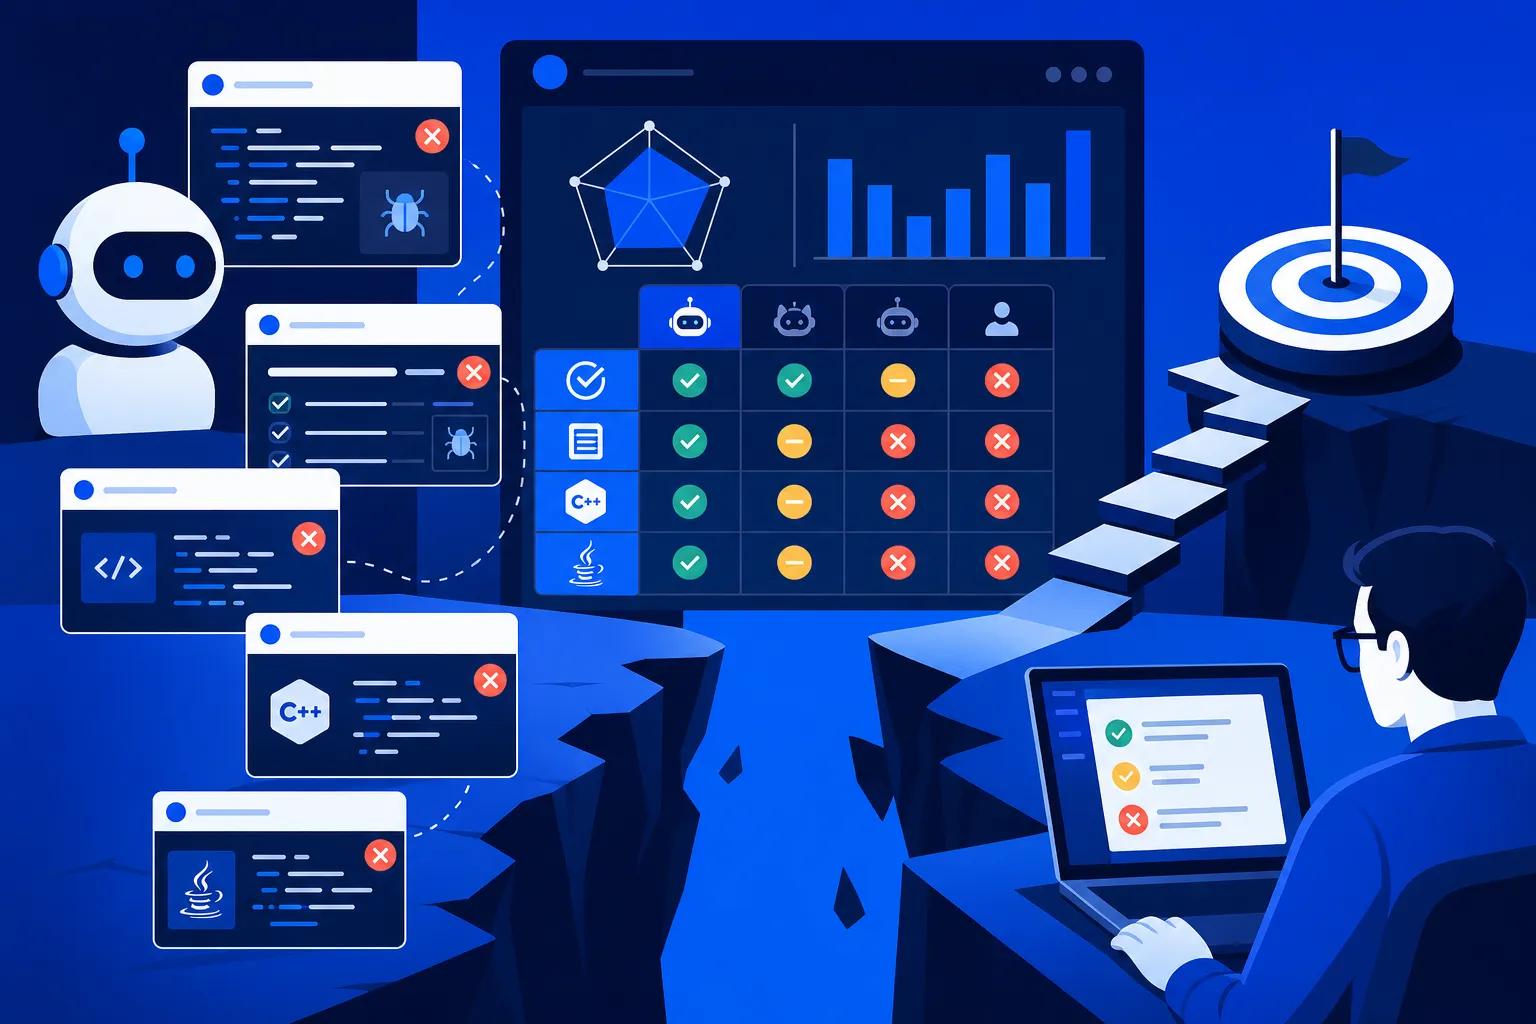
25% na testach w C++: nowy benchmark pokazuje, gdzie agenty się sypią

3 min

OmniCode, benchmark zespołu Atharvy Sonwane'a i Saikata Dutty przedstawiony na ACL 2026, sprawdza agenty programistyczne na 1794 zadaniach w Pythonie, Javie i C++, w czterech kategoriach: łatanie błędów, pisanie testów, poprawki z recenzji i porządkowanie stylu. Popularny SWE-Agent z modelem DeepSeek-V3.1 radzi sobie nieźle głównie z błędami w Pythonie, a na pisaniu testów w C++ wyciąga najwyżej 25%, i to w najlepszym przebiegu. Agenty są mocne tam, gdzie trenowano je najintensywniej, więc jeśli piszesz w Javie czy C++ albo oddajesz im testy, sprawdź je na własnym kodzie.

Microsoft otwiera dwa narzędzia, które sprawdzają, czy agent trzyma się reguł, zanim trafi na produkcję Premiera / Narzędzie

Microsoft otwiera dwa narzędzia, które sprawdzają, czy agent trzyma się reguł, zanim trafi na produkcję

5 min

Na Build 2026, 2 czerwca, Microsoft wypuścił na licencji MIT dwa narzędzia, które sprawdzają, czy agent trzyma się wyznaczonych mu reguł, zanim trafi na produkcję. ASSERT zamienia spisaną politykę czy prompt systemowy w działające testy i ocenia je modelem jako sędzią, który w wewnętrznych testach zgadzał się z ludźmi w 80-90% przypadków. ACS wpina twarde kontrole w pięciu punktach cyklu życia agenta, opisane w przenośnym pliku YAML, z wtyczkami do LangChain, CrewAI czy Anthropic Agents SDK. Microsoft daje wspólny język, ale nie zdejmuje z nikogo odpowiedzialności, gdy agent się pomyli.