SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Microsoft otwiera agenta, który czyta repozytorium, zanim napisze testy

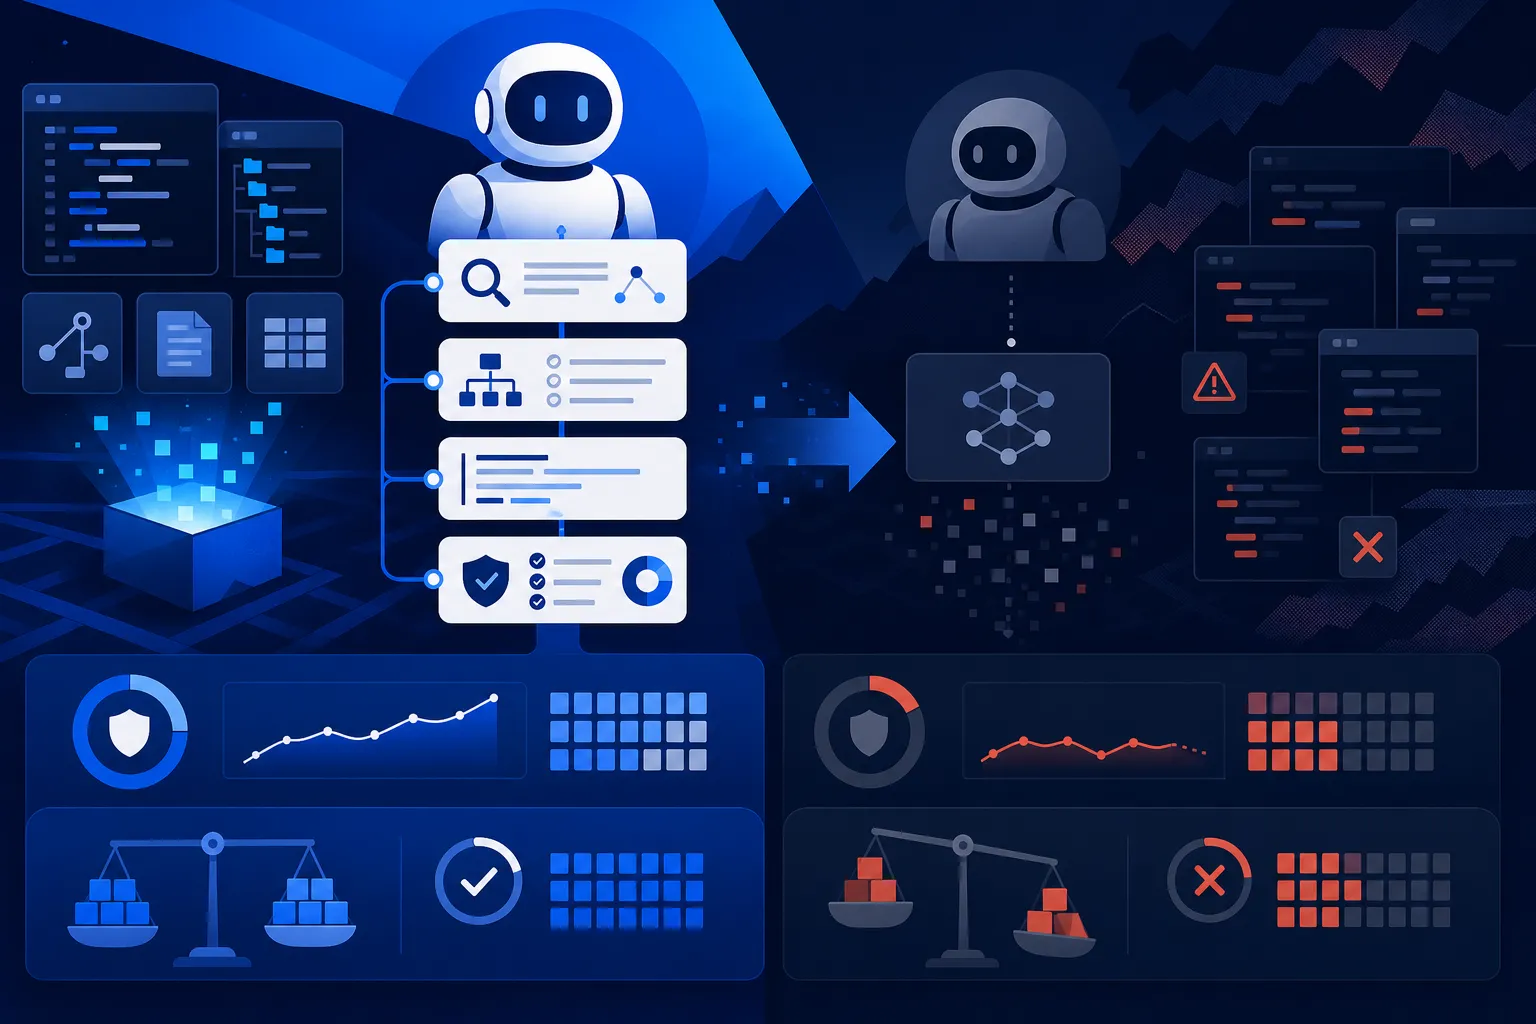
Microsoft udostępnił na licencji MIT agenta code-testing-generator, który zanim napisze testy jednostkowe, przeszukuje repozytorium, wykrywa język i framework oraz ustala prawdziwe komendy budowania. Na wewnętrznym benchmarku ze 152 zadań zaliczył 140 wobec 120 Copilota na tym samym modelu, czyli o 63% mniej porażek. Cały zysk skupia się w ogólnikowych poleceniach typu „napisz testy”, gdzie liczba porażek spadła z 30 do 10; przy szczegółowych promptach oba wypadły tak samo. To nie przełom, tylko porządne rusztowanie automatyzujące nudne rozeznanie pomijane przy jednej linijce polecenia.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Microsoft otwiera agenta, który czyta repozytorium, zanim napisze testy
Ilustrację przygotowała AI.

"Napisz testy jednostkowe." Taka prośba do agenta programistycznego mieści się w jednej linijce, a zostawia kilka otwartych pytań, na które i tak ktoś musi odpowiedzieć: który fragment kodu wymaga testów, jakiego frameworku testowego używa projekt, gdzie te testy mają trafić i jak build ma je potem znaleźć. Zwykły asystent po prostu zgaduje. Microsoft postawił na to, żeby agent najpierw sam sobie odpowiedział na te pytania, czytając repozytorium, zanim cokolwiek napisze.

Zespół .NET wypuścił code-testing-generator 31 lipca, jako agenta open-source do generowania testów jednostkowych, na licencji MIT w repozytorium dotnet/skills. Jest wielojęzyczny, z osobnymi wskazówkami dla .NET, Pythona, TypeScriptu, Javy, Go, Rusta i kilku innych języków, i działa od ręki w GitHub Copilot CLI, a w VS Code przez wsparcie wtyczek, które jest jeszcze w wersji zapoznawczej. To nie usługa w chmurze, tylko definicja agenta wpięta w narzędzie, którego już używasz, dzięki czemu kod nie opuszcza twojej maszyny. Sednem jest prosta zmiana filozofii i właśnie z niej bierze się największa różnica tam, gdzie prompt jest najbardziej ogólnikowy.

Najpierw rozeznanie, dopiero potem kod

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

92% na domowym teście, 36% na obcym: ile naprawdę zmienia agent od testów Premiera / Narzędzie

92% na domowym teście, 36% na obcym: ile naprawdę zmienia agent od testów

3 min

Microsoftowy agent code-testing-generator, wydany na licencji MIT, najpierw czyta repozytorium, żeby wpasować testy w konwencje projektu, a na końcu sam psuje własny kod i sprawdza, czy test to wyłapie. Na wewnętrznym sprawdzianie Microsoftu zaliczył 92% i o 63% mniej porażek niż GitHub Copilot na tym samym modelu, ale cały zysk skupia się w ogólnikowych poleceniach typu "napisz testy". Na niezależnym benchmarku SWE Atlas wynik spada do 36,4% wobec 27,3% u Copilota. To nie przełom, tylko rusztowanie, które pilnuje, żeby testy w ogóle coś wykrywały.

Microsoft otwiera dwa narzędzia, które sprawdzają, czy agent trzyma się reguł, zanim trafi na produkcję Premiera / Narzędzie

Microsoft otwiera dwa narzędzia, które sprawdzają, czy agent trzyma się reguł, zanim trafi na produkcję

5 min

Na Build 2026, 2 czerwca, Microsoft wypuścił na licencji MIT dwa narzędzia, które sprawdzają, czy agent trzyma się wyznaczonych mu reguł, zanim trafi na produkcję. ASSERT zamienia spisaną politykę czy prompt systemowy w działające testy i ocenia je modelem jako sędzią, który w wewnętrznych testach zgadzał się z ludźmi w 80-90% przypadków. ACS wpina twarde kontrole w pięciu punktach cyklu życia agenta, opisane w przenośnym pliku YAML, z wtyczkami do LangChain, CrewAI czy Anthropic Agents SDK. Microsoft daje wspólny język, ale nie zdejmuje z nikogo odpowiedzialności, gdy agent się pomyli.

Microsoft pozwala AI napisać test tylko raz, resztę robi już zwykły skrypt Premiera / Narzędzie

Microsoft pozwala AI napisać test tylko raz, resztę robi już zwykły skrypt

3 min

Zespół Commerce Platforms w Microsofcie obszedł konflikt między probabilistyczną naturą AI a wymogiem, by test zgodności za każdym razem przebiegał identycznie: agent tylko raz układa przypadki testowe z istniejącej dokumentacji, człowiek je zatwierdza, a wynik zostaje zamrożony w deterministyczny skrypt, którego AI już nie dotyka. Drugi agent podważa to, co stworzył pierwszy, zanim cokolwiek zostanie zatwierdzone. Cotygodniowe testy regresji przy migracji Global Trade Services na SAP S/4HANA spadły z trzech dni do niespełna godziny, choć liczby pochodzą wyłącznie z firmowego bloga Microsoftu.