Poradnik / Praktyka
Zestaw testów agenta potrafi wysłać prawdziwy przelew
Braintrust tłumaczy, dlaczego test jednostkowy odrzuca poprawny przebieg agenta tylko za to, że sprawdził regulamin przed zamówieniem, i w miejsce asercji wstawia funkcję oceniającą cały zapis pracy w skali od 0 do 1, puszczaną kilka razy na to samo zgłoszenie. Zestaw wpięty w prawdziwe API płatnicze wysyłałby przy tym prawdziwe przelewy, więc usługi trzeba podstawić jako atrapy. Zapamiętałbym stąd liczbę kroków jako sygnał regresji, bo zapala się, zanim wynik zdąży się popsuć. Gorzej, że bramka w CI blokuje merge na ocenie modelu w roli sędziego, którego zgodności z ludźmi nikt nie podaje.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 4 min ·
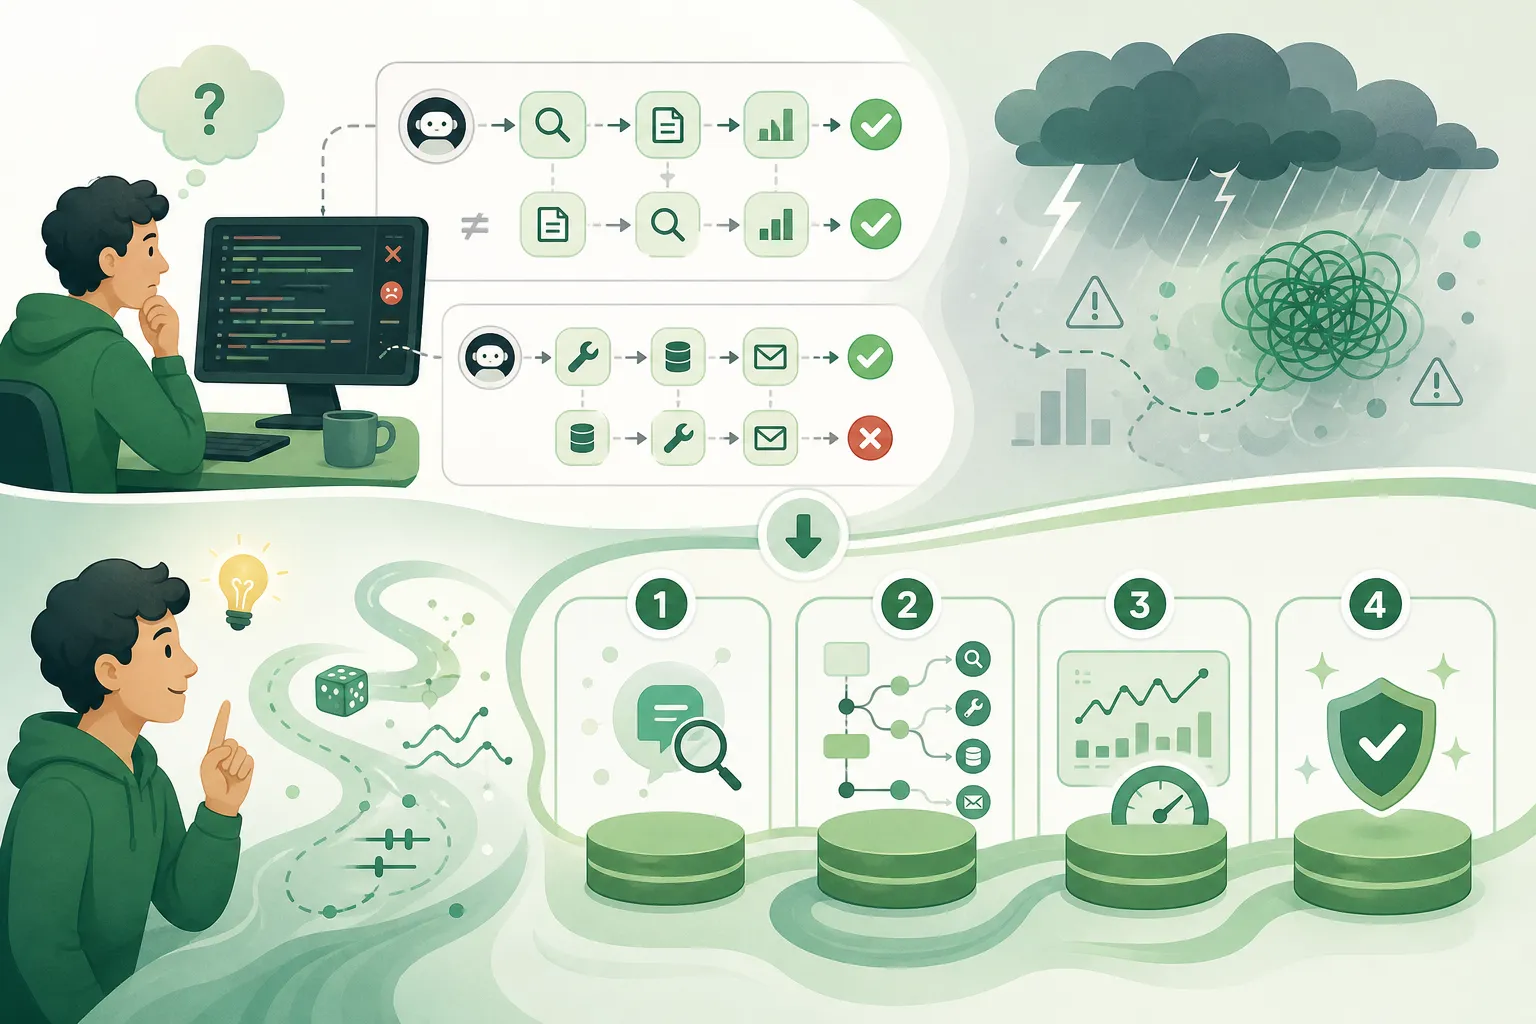
Model językowy wpięty w prawdziwą bazę zamówień i w prawdziwe API płatnicze dostaje zgłoszenie: klient chce zwrotu za spóźnioną paczkę. W pierwszym uruchomieniu agent sprawdza najpierw zamówienie, potem regulamin zwrotów, a dopiero na końcu oddaje pieniądze. W drugim zaczyna od regulaminu i zamówienie sprawdza zaraz po nim. Oba przebiegi są poprawne, bo wymagane kontrole odbyły się przed przelewem, a stan końcowy wyszedł identyczny.
Klasyczny test jednostkowy mimo to odrzuci drugi przebieg, bo asercję napisano pod kolejność z pierwszego, przy założeniu, że to samo wejście da dokładnie to samo wyjście. Asercja na treść ostatniej wiadomości do klienta wywróci się jeszcze łatwiej, bo model za każdym razem dobiera trochę inne słowa.
Ten sam przykład ciągnie się przez cały przewodnik po testowaniu agentów, który opublikował Braintrust, firma sprzedająca platformę do oceniania modeli. Czytam go jako dobrą diagnozę z doklejonym cennikiem i to właśnie diagnoza jest tu warta czasu.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.