Premiera / Narzędzie
Agent Memory rusza w prywatnej becie: pięć poleceń dla modelu zamiast surowego SQL-a
Cloudflare 17 kwietnia wpuścił do prywatnej bety Agent Memory, usługę ratującą pamięć agenta w momencie, gdy okno kontekstowe się zapełnia i harness ucina historię. Zamiast surowego dostępu do bazy wektorowej model dostaje pięć operacji, w tym `recall`, który pod spodem odpala pięć równoległych kanałów wyszukiwania i zwraca gotowe zdanie syntezy. Czarną robotę robi tańszy Llama 4 Scout, większy Nemotron 3 wchodzi tylko do finalnej syntezy. Pamięć jako wąska usługa, nie baza do obsługi przez model, ma sens, choć porównania z własnym Postgresem z embeddingami jeszcze nie ma.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
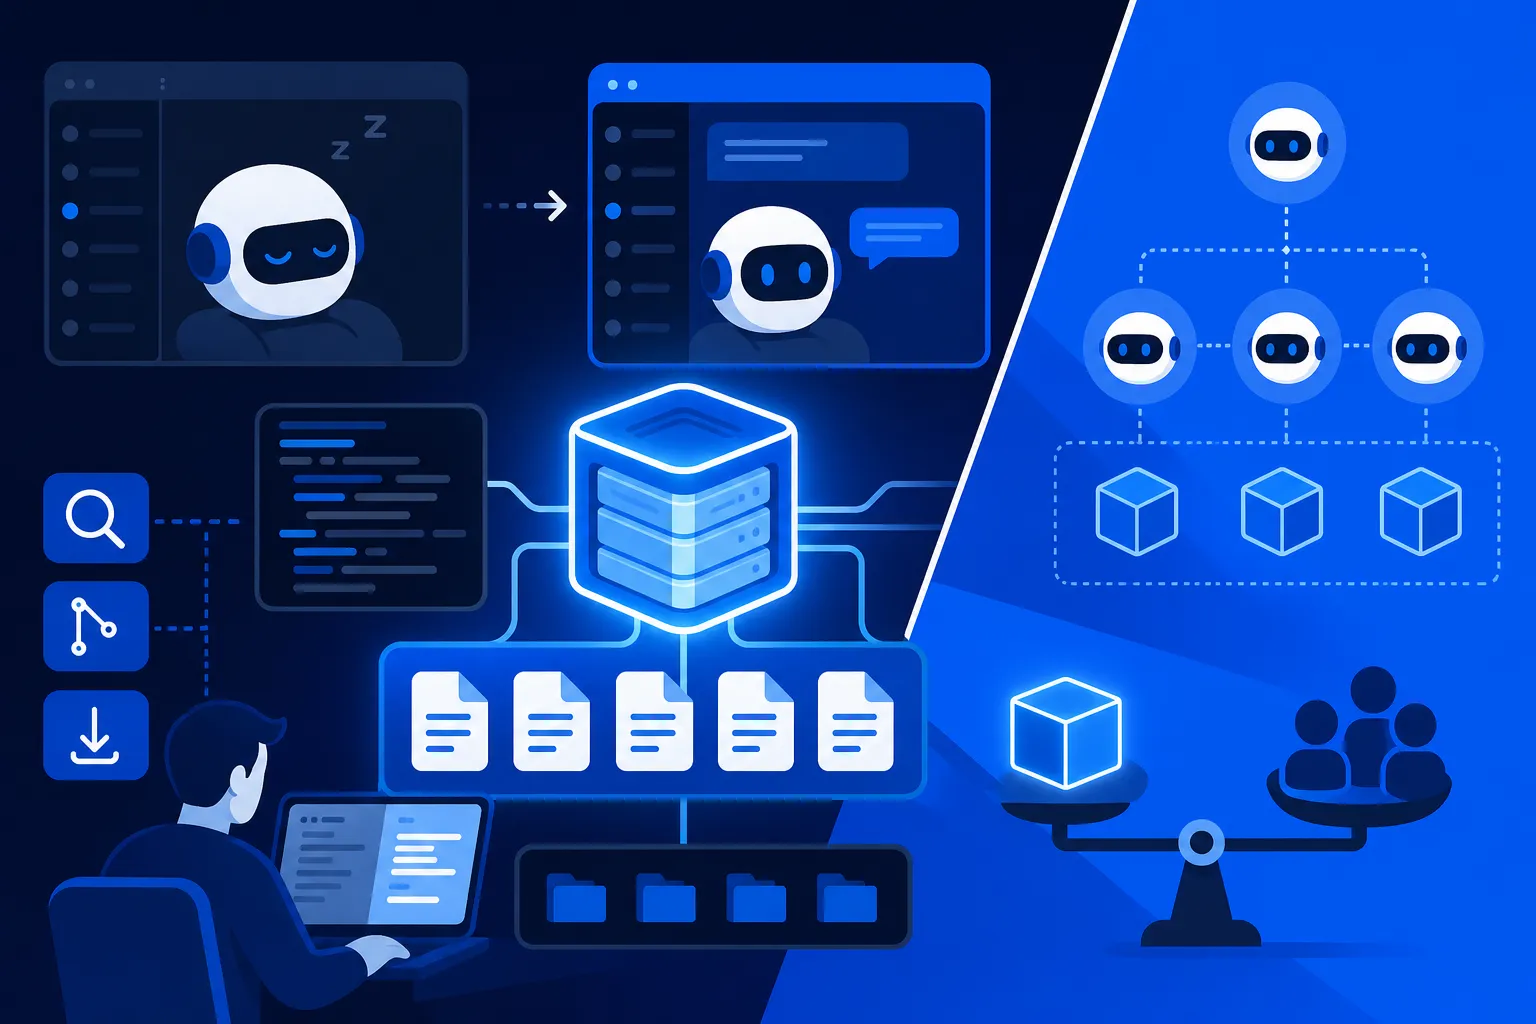
Agent po trzech godzinach rozmowy z deweloperem trafia na ścianę. Okno kontekstowe się zapełnia, harness skraca historię i razem z nią wylatują wszystkie ustalenia tej sesji: że projekt używa pnpm zamiast npm, że limit zapytań do API zwiększono po incydencie z 10 kwietnia, że ciemny motyw ma być włączony domyślnie. Następne uruchomienie zaczyna się od zera. Cloudflare 17 kwietnia wpuścił do prywatnej bety usługę, która ma ten moment uratować bez wyrzucania wszystkiego, czego agent się nauczył.
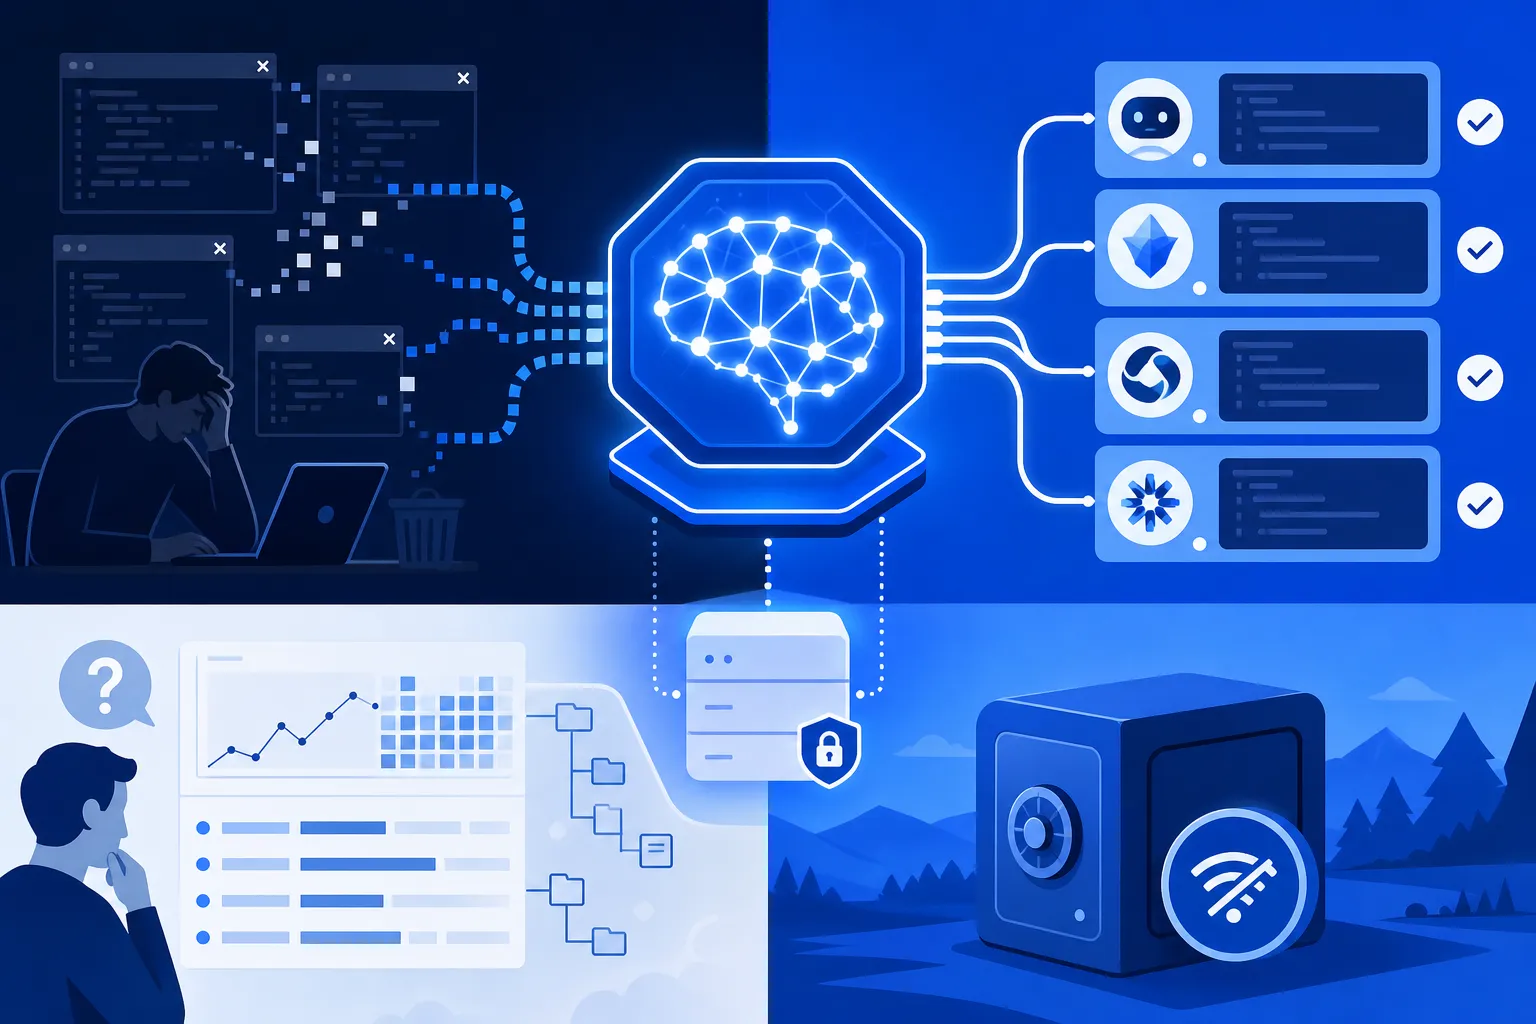
Nazywa się Agent Memory i robi coś, co dotąd agenci musieli sobie składać sami: wyciąga fakty i polecenia z rozmowy, klasyfikuje je do czterech kategorii, deduplikuje względem tego, co już jest zapisane, i trzyma w odizolowanym profilu. Model nie dostaje surowego dostępu do bazy. Dostaje pięć prostych operacji. Operacja recall ukrywa pod sobą całą wyszukiwarkę: model pyta, a w odpowiedzi dostaje gotowe zdanie syntezy, bo pod spodem odpaliła się cała kolejka kanałów. Cztery pozostałe są dużo prostsze: pełny zapis rozmowy przy kompakcji kontekstu, ręczne zapamiętanie czegoś istotnego, lista wszystkiego, kasowanie wybranego. Już ten układ mi się podoba: pamięć ma być usługą, nie surową bazą do obsługi przez model.
Cloudflare otwarcie pisze, dlaczego nie dał modelowi surowego SQL-a do bazy wektorowej, tylko wąską listę operacji: główny agent nie powinien palić kontekstu na strategię przechowywania. Jeśli model sam projektuje zapytania i decyduje, gdzie i co zapisać, to spala tokeny na metapracę zamiast na samo zadanie. Lepiej, żeby ktoś inny wyciągał fakty z transkryptu, a model żeby wołał recall("Jakiego menedżera pakietów woli użytkownik?") i dostawał gotowe zdanie w odpowiedzi.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.