SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

OptMem daje agentom pamięć, która przeżywa koniec sesji

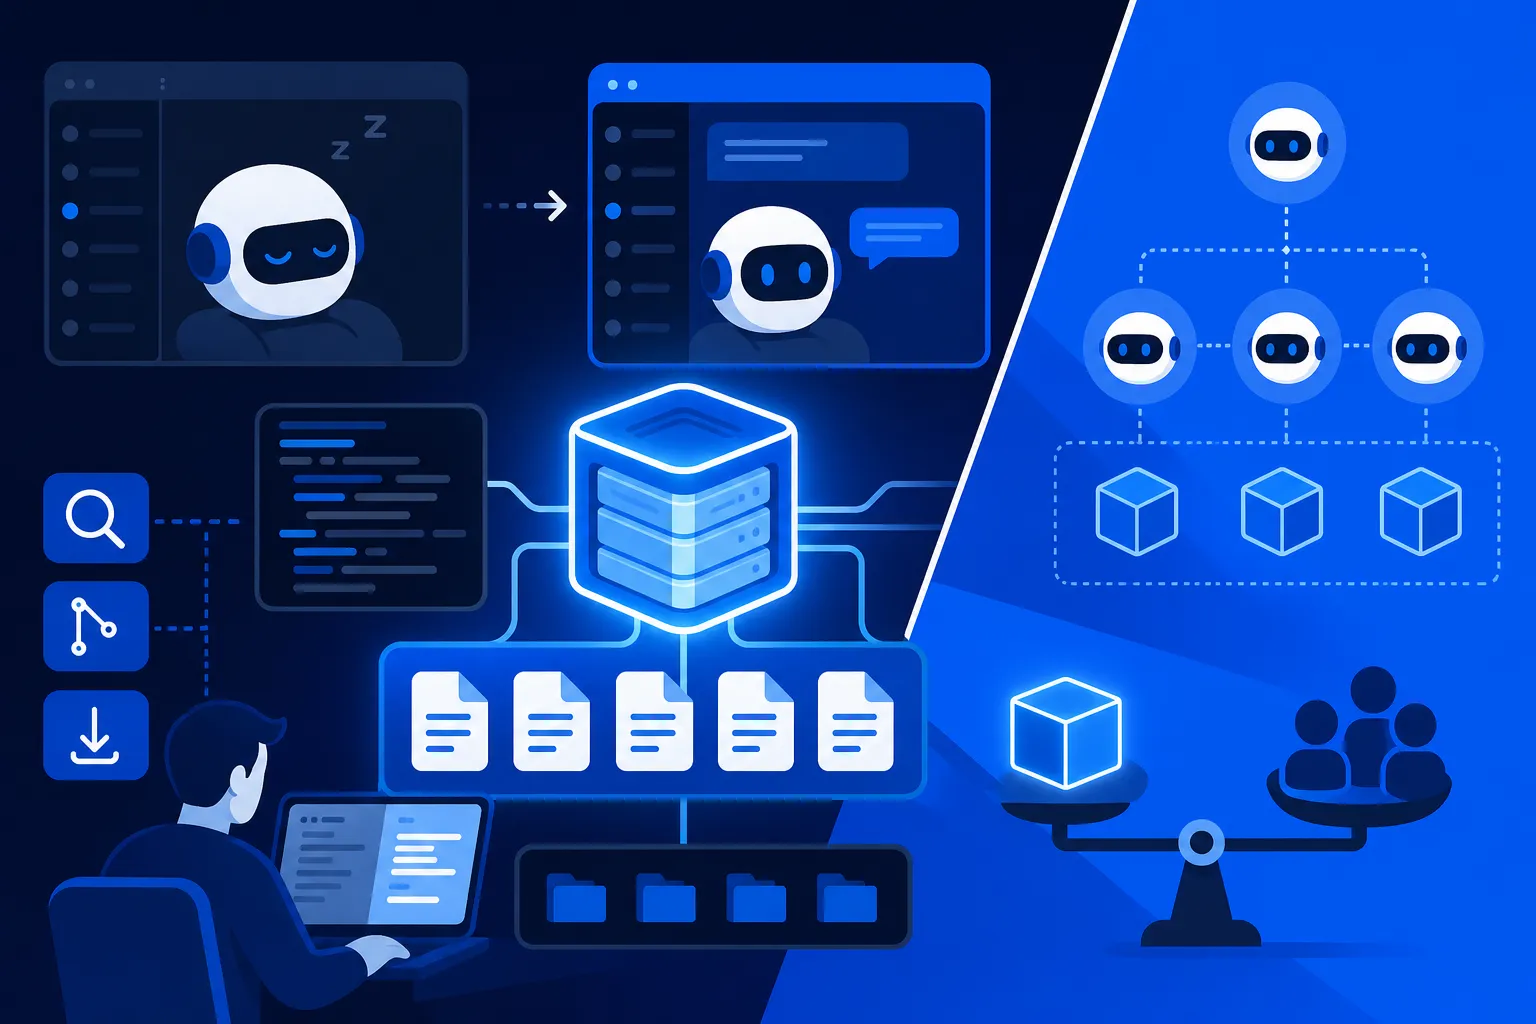
Agent do kodu zaczyna każdą sesję od zera, bo harness ucina starą historię, gdy zapełni się okno kontekstowe. OptMem Victora Taelina odpowiada na tę amnezję jednym plikiem Pythona bez zależności i promptem na 426 tokenów wklejanym do CLAUDE.md: notatki lądują w bezstratnym, wiecznie rosnącym dzienniku, nad którym drzewo binarne streszczeń trzyma odczyt na stałym budżecie około 16 tysięcy tokenów. Cały ciężar spada jednak na model, bo to on musi konsekwentnie zapisywać i sięgać po pamięć we właściwym momencie, czego żaden świeżo wydany projekt jeszcze nie udowodnił.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
OptMem daje agentom pamięć, która przeżywa koniec sesji
Ilustrację przygotowała AI.

Agent do kodu zaczyna każdą sesję od zera. Kiedy okno kontekstowe się zapełnia, harness ucina starą historię, więc przy następnym uruchomieniu model nie pamięta ani tego, co wspólnie ustaliliście, ani czego już próbował bez powodzenia. OptMem, które wypuścił Victor Taelin, ma na tę amnezję jeden pomysł: dopisać agentowi pamięć, która przeżywa koniec sesji, kompaktowanie kontekstu, a nawet zmianę modelu czy dostawcy.

Całość to jeden plik Pythona bez żadnych zależności i krótki prompt, który wkleja się na samą górę pliku z instrukcjami agenta, czyli CLAUDE.md albo AGENTS.md. Instalacja to dosłownie jedna linijka w terminalu, a wklejany blok liczy 426 tokenów, więc nie zjada zauważalnie kontekstu. Od strony agenta jest to zwykłe narzędzie wywoływane z linii poleceń, dlatego działa z dowolnym harnessem, czy to Claude Code, czy Codex, czy goła powłoka.

Jak stały budżet czytania mieści nieograniczoną historię

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Pamięć agenta w plikach Markdown, które przejrzysz grepem Premiera / Narzędzie

Pamięć agenta w plikach Markdown, które przejrzysz grepem

5 min

agent-memory od tigerless-labs trzyma całą pamięć agenta do kodu w zwykłych plikach Markdown, a leżący obok indeks SQLite wolno skasować i odtworzyć jednym poleceniem, więc notatki przejrzysz grepem i wrzucisz do gita. Stara notatka o npm test nie znika, kiedy projekt przechodzi na pnpm, tylko zostaje oznaczona jako nieaktualna, a osobny przebieg w tle scala zapisy i zapomina te bez wartości, przy czym każde skasowanie idzie do zatwierdzenia przez człowieka. W teście LongMemEval-S biblioteka wyciąga 52,9% poprawnych odpowiedzi wobec 35,8% dla MemCore.

Jeden plik Pythona zamiast bazy wektorowej: mind próbuje dać agentom pamięć Premiera / Narzędzie

Jeden plik Pythona zamiast bazy wektorowej: mind próbuje dać agentom pamięć

4 min

mind, jednoplikowe narzędzie Da7-Tech, próbuje dać agentom do kodu pamięć między sesjami bez embeddingów, bazy wektorowej czy zapytań do LLM: opiera się na wyszukiwaniu leksykalnym, grafie pojęć i ręcznym słowniku 83 mapowań, a nieużywane fakty gasną według krzywej Ebbinghausa. Autor podaje recall@1 równy 1,00 przy medianie 2,9 ms na grafie 1000 węzłów, choć sam przyznaje, że to tylko 20 zapytań na sztucznych danych. Największe pytanie nie dotyczy algorytmu, lecz tego, czy agent w ogóle zechce sięgnąć do pamięci wszytej w pliki CLAUDE.md i AGENTS.md.

Agent Memory rusza w prywatnej becie: pięć poleceń dla modelu zamiast surowego SQL-a Premiera / Narzędzie

Agent Memory rusza w prywatnej becie: pięć poleceń dla modelu zamiast surowego SQL-a

4 min

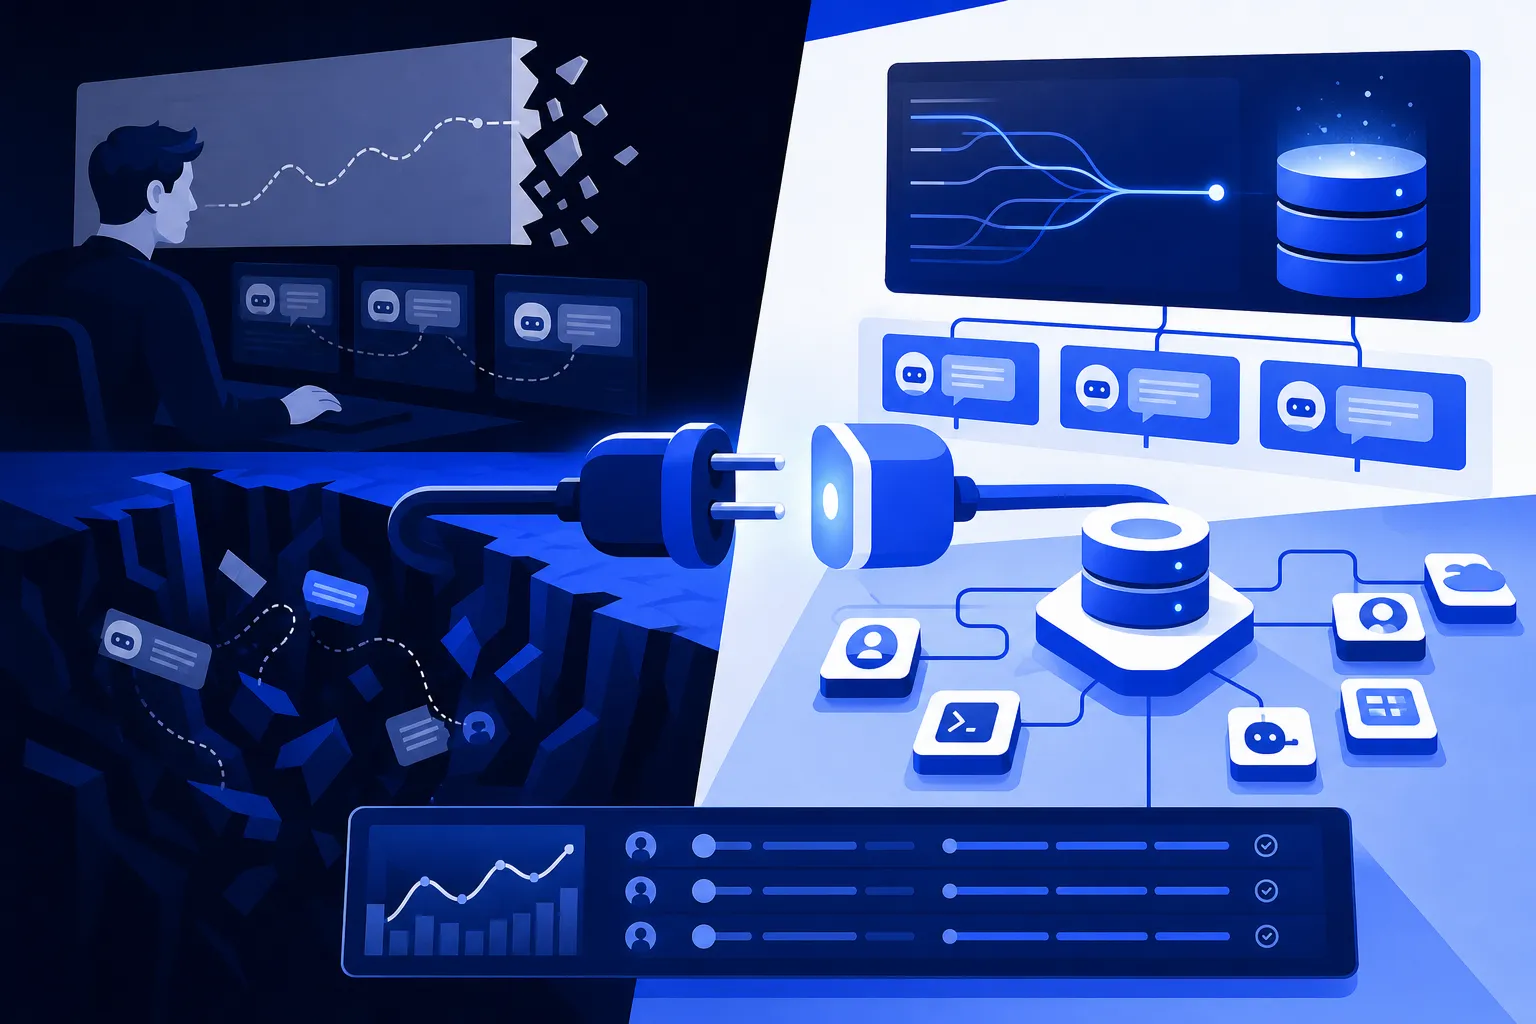
Cloudflare 17 kwietnia wpuścił do prywatnej bety Agent Memory, usługę ratującą pamięć agenta w momencie, gdy okno kontekstowe się zapełnia i harness ucina historię. Zamiast surowego dostępu do bazy wektorowej model dostaje pięć operacji, w tym `recall`, który pod spodem odpala pięć równoległych kanałów wyszukiwania i zwraca gotowe zdanie syntezy. Czarną robotę robi tańszy Llama 4 Scout, większy Nemotron 3 wchodzi tylko do finalnej syntezy. Pamięć jako wąska usługa, nie baza do obsługi przez model, ma sens, choć porównania z własnym Postgresem z embeddingami jeszcze nie ma.