Bezpieczeństwo
Anthropic blokuje destylację Claude'a, a za pomyłki filtra płaci klient
Anthropic stawia trzy bariery przeciw destylacji Claude'a, czyli uczeniu tańszych modeli konkurencji na jego rozumowaniu, które daje w SWE-bench Verified 80,4% wobec 71,8% przy samych streszczeniach. Konta API założone od 31 sierpnia 2026 nie mogą edytować wcześniejszych tur rozmowy, a zapytania do najnowszych modeli sprawdza dwustopniowy klasyfikator. Od 24 września klient płaci też za zablokowane zapytania, więc przy deklarowanym progu 0,1% fałszywych alarmów agent z tysiącami wywołań dziennie zapłaci za kilka odmów, dlatego liczyłbym je we własnych logach.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Bezpieczeństwo · 4 min ·
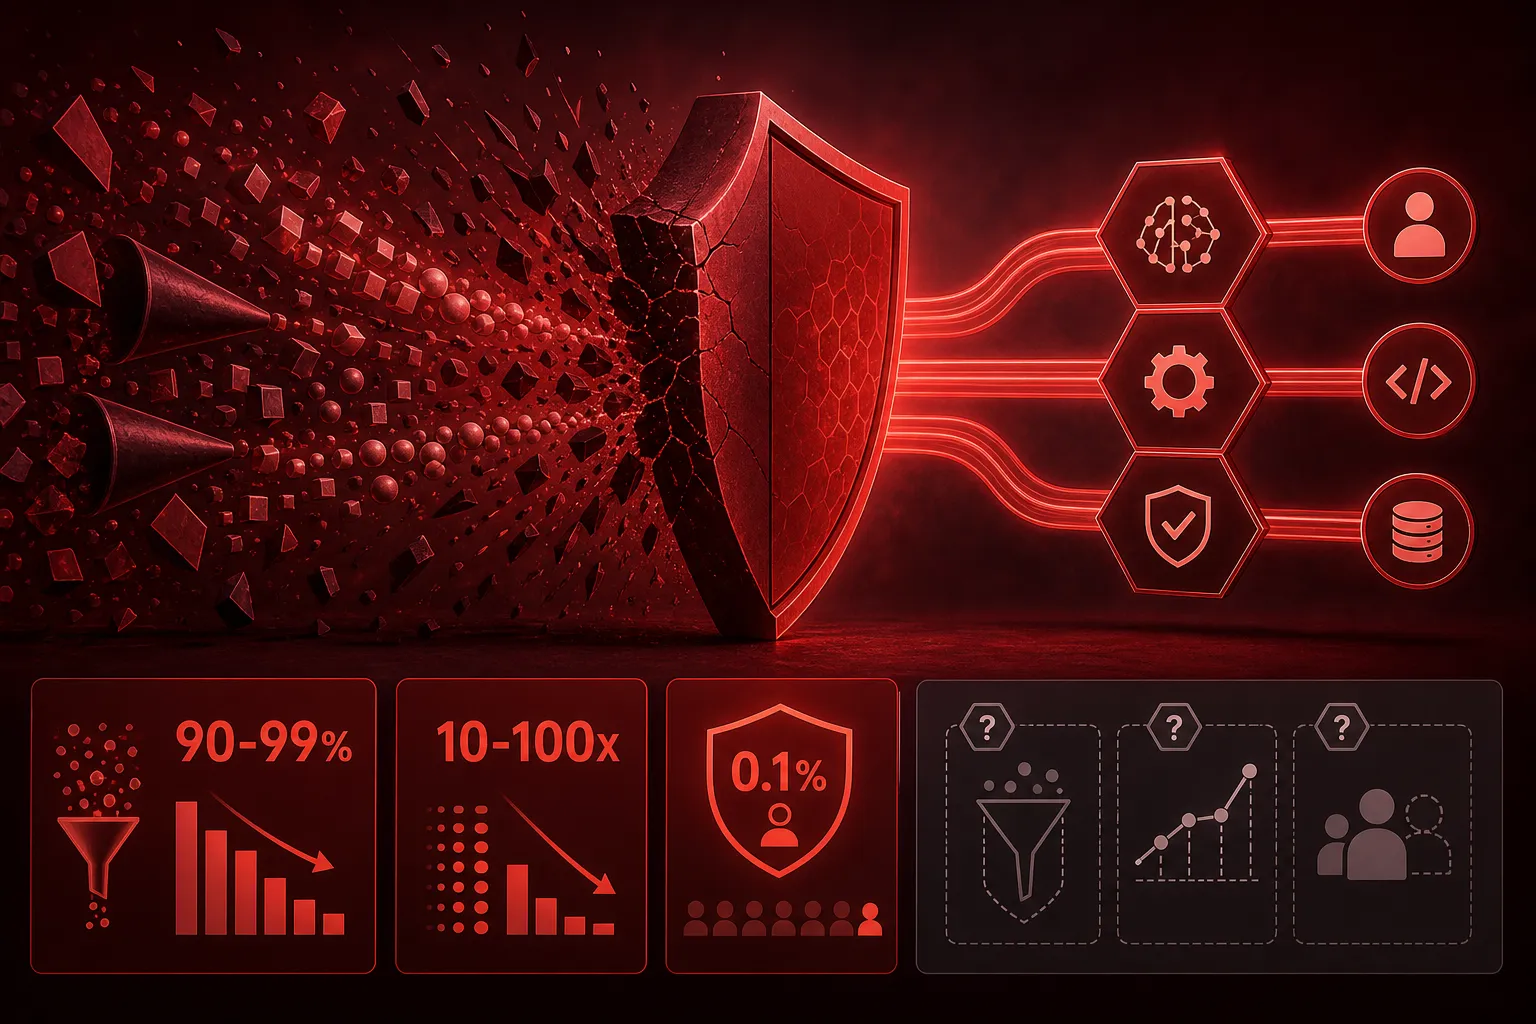
Anthropic opisał na swoim blogu badawczym, jak broni Claude'a przed destylacją: konkurencyjne laboratoria masowo zbierają jego odpowiedzi i uczą na nich własne, tańsze modele (Anthropic). To przede wszystkim sprawa Anthropica. Dla kogoś, kto po prostu woła API Claude'a, ważniejsze jest co innego: dwie z tych zmian dotykają także uczciwych klientów, a jedną z nich, opłatę za zablokowane zapytania, firma uzasadnia niskim odsetkiem fałszywych alarmów.
Łupem jest tok rozumowania
Ktoś wysyła do dużego modelu miliony zapytań, zbiera odpowiedzi i trenuje na nich mniejszy model, aż ten zacznie naśladować większego: tak wygląda destylacja. Najcenniejsza nie jest sama odpowiedź, tylko rozumowanie, które Claude rozpisuje przed nią, bo pokazuje uczniowi, jak dojść do wyniku. Dlatego Anthropic od dawna pokazuje użytkownikom tylko streszczenie tego rozumowania, a na poparcie tej decyzji podaje porównanie (Anthropic). Wstępnie wytrenowany Claude douczony na pełnych zapisach rozumowania modelu Opus 4.8 rozwiązał 80,4% zadań w SWE-bench Verified, teście, w którym model naprawia prawdziwe błędy z repozytoriów open-source. Douczony na samych streszczeniach zszedł do 71,8%.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.