Premiera / Narzędzie
Benchmark Google mierzy teraz, ile pracy zostaje po agencie
Android Bench 2.0, nowy test Google dla agentów piszących aplikacje na Androida, obok pełnych zaliczeń pokazuje wskaźnik ukończenia, czyli to, jaką część pracy agent wykonał dobrze. GPT-6 Astra w Codeksie kończy 82,2% pracy, ale w całości zalicza tylko 28% przebiegów, a Claude Fable 5.1 w Claude Code ma 82,4% i 22,7%. Resztę stanowią błędy widoczne dopiero w działającej aplikacji, jak odtwarzacz grający w tle czy stan tracony po obróceniu telefonu, dlatego przegląd kodu warto przesunąć ze stylu na zachowanie aplikacji.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
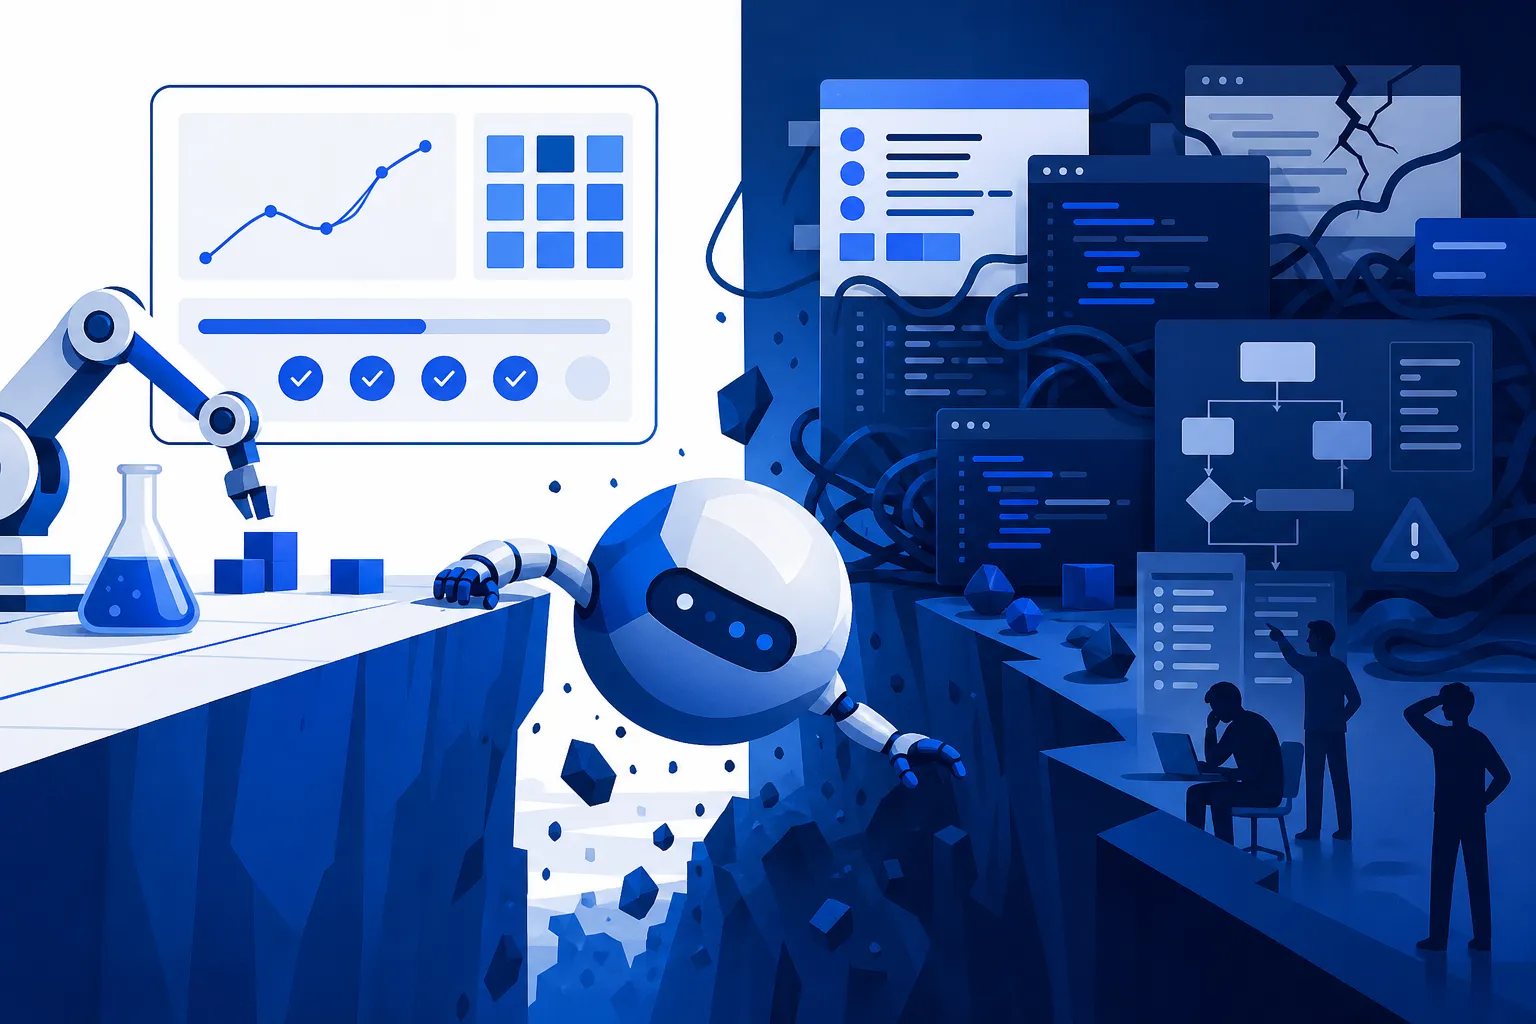
W jednym z zadań nowego testu Google agent AI miał dopisać odtwarzanie wideo do aplikacji z wiadomościami i z daleka wszystko wyglądało na skończone. Dopiero gdy odtwarzacz zjechał poza ekran, wyszło, że nie zwalnia zasobów i dalej gra w tle, choć nikt go już nie ogląda. Ten przebieg opisał serwis XenoSpectrum w analizie Android Bench 2.0, benchmarku, którym Google sprawdza, jak modele AI radzą sobie z prawdziwą pracą nad aplikacjami na Androida. Tydzień temu pisałem o tym, że czołówka spadła w nim z ponad 90% do 28%. Dziś bardziej interesuje mnie druga liczba z tej samej tabeli, bo to ona mówi, ile pracy zostaje dla człowieka.
Dla porządku przypomnę punkt wyjścia. Pierwsza wersja benchmarku mierzyła drobne poprawki w istniejących repozytoriach, a typowa zmiana miała według analizy serwisu technologicznego XenoSpectrum 32 linie w jednym lub dwóch plikach. Nowa wersja zawiera 30 zadań, nad którymi inżynier siedziałby kilka dni albo tydzień: budowę aplikacji od zera, migracje bibliotek sięgające 8200 linii w 294 plikach i przenoszenie aplikacji z Fluttera czy React Native na natywnego Androida. Każdy system dostaje pięć podejść do każdego zadania.
Prawie gotowe to nie to samo co gotowe
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.