Bezpieczeństwo
Bezpieczeństwa agenta nie da się napisać w promptcie
Zespół AI Red Team w NVIDII przez sześć miesięcy łamał agenty programistyczne i za każdym razem wracały te same cztery słabości: brak kontroli dostępu do samego agenta, narzędzia uruchamiające dowolny kod, otwarty ruch wychodzący i sekrety w zasięgu agenta otwartym tekstem. Ważniejszy od listy jest wniosek: bezpieczeństwa nie da się napisać w prompcie, bo strażnik pilnujący modelu jest tym samym rodzajem modelu, więc równie łatwo go zmanipulować socjotechniką albo powolnym gotowaniem żaby. Zostaje traktować model jak niezaufanego użytkownika i otoczyć go twardymi barierami poza promptem.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Bezpieczeństwo · 5 min ·
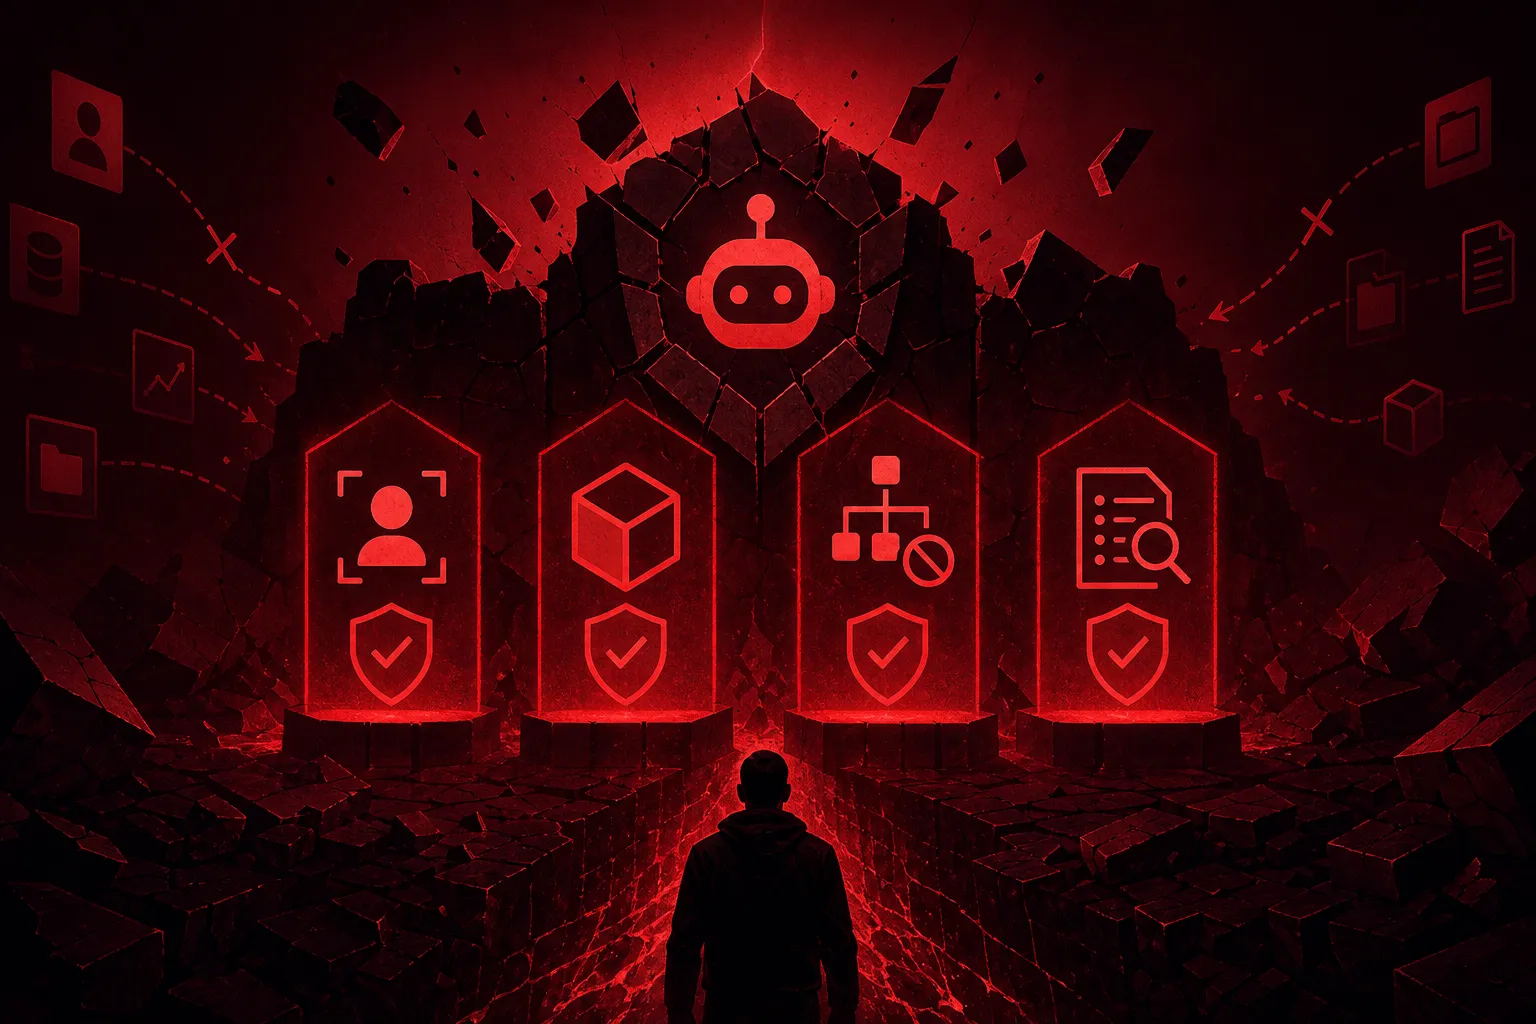
Agent, który sam czyta zgłoszenie błędu, pisze poprawkę, uruchamia testy i odsyła ją człowiekowi do przeglądu, brzmi jak wymarzony współpracownik. Żeby jednak to robił, musi dostać żywe narzędzia i dostęp do firmowych danych, a w tym momencie przestaje być asystentem i staje się uprzywilejowanym oprogramowaniem z powierzchnią ataku, której nikt do końca nie rozumie. Przez ostatnie sześć miesięcy zespół AI Red Team w NVIDII testował takie agenty, od prostych narzędzi do programowania po autonomiczne asystenty działające bez przerwy, i za każdym razem, gdy dało się któregoś złamać, wracały te same cztery słabości: brak kontroli dostępu do samego agenta, narzędzia pozwalające uruchomić dowolny kod, brak blokady połączeń wychodzących i poufne dane leżące w jego zasięgu otwartym tekstem.
Najważniejsze w tym raporcie jest jednak, moim zdaniem, nie sama lista dziur, tylko wspólny wniosek pod spodem: bezpieczeństwa agenta nie da się napisać w prompcie. To zmienia sposób, w jaki trzeba projektować takie systemy, i waży więcej niż kolejna lista dobrych praktyk.
Prompt nie jest zabezpieczeniem
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.