SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Sto zadań z bezpieczeństwa, żaden model powyżej połowy

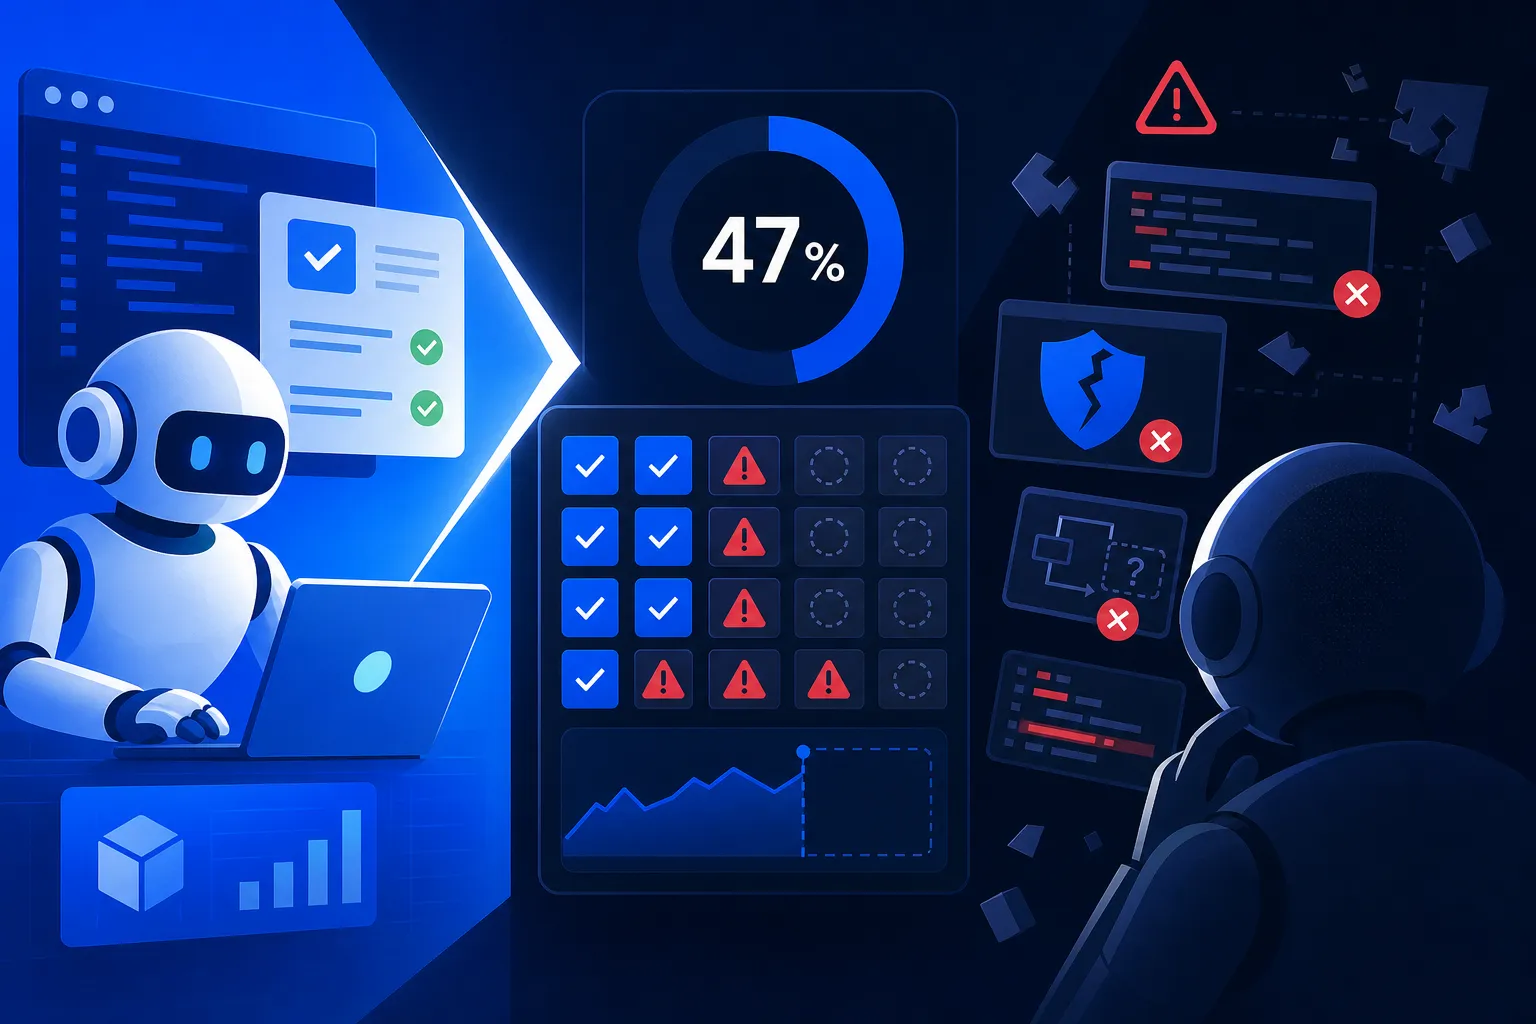
Collinear AI pokazało 2 września CWE-bench: sto zadań, w których agent ma załatać prawdziwą podatność w cudzym kodzie, a najlepszy wynik to 47% dla Claude Fable 5, przy 18 zadaniach, których nie rozwiązał żaden model. Punkt jest tylko za pełne załatanie, więc agent, który zamknął dwie ścieżki z trzech, dostaje zero. Same błędy modele znajdują sprawnie, sypią się dopiero na poprawce: ufają zabezpieczeniu, które sprawdza plik odciskiem z tego samego serwera, zatrzymują się krok przed miejscem, w którym token powstaje, albo łatają tak szeroko, że psują zwykłą funkcję.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  5 min  · 
Sto zadań z bezpieczeństwa, żaden model powyżej połowy
Ilustrację przygotowała AI.

Token dostępu do aplikacji da się unieważnić na trzy sposoby: użytkownik się wylogowuje, administrator kasuje token ręcznie albo ktoś usuwa całe konto, do którego ten token należał. Agent AI dostał ten kod i polecenie, żeby zamknąć dziurę, przez którą unieważnianie nie działa. Dziurę znalazł. Poprawił dwie ścieżki z trzech i dostał za to zero punktów, bo trzecia dalej wypuszczała w świat ważny token.

To jedno ze 100 zadań w CWE-bench, zestawie testów, który firma Collinear AI pokazała 2 września. Zamiast sprawdzać, czy agent dopisze nową funkcję, CWE-bench patrzy, czy załata podatność w cudzym, prawdziwym kodzie, i to w 54 rodzajach błędów bezpieczeństwa, łącznie z tymi, które branża od lat uznaje za najgroźniejsze w aplikacjach webowych. Najlepszy wynik na premierowej liście to 47% dla Claude Fable 5 przy maksymalnym poziomie rozumowania. Osiemnastu zadań ze stu nie rozwiązał żaden z przetestowanych modeli.

Collinear tłumaczy to asymetrią, która brzmi banalnie, dopóki nie przełoży się jej na punkty: atakującemu wystarczy jedno niezałatane miejsce, a obrońca musi mieć rację wszędzie. Zgadzam się i dlatego procent z tego testu znaczy coś innego niż procent ze SWE-bench. Tam agent, który zrobił cztery zadania z pięciu, jest w czterech piątych przydatny, a tutaj agent, który załatał cztery miejsca z pięciu, nie załatał podatności wcale.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Endor Labs potwierdza lukę z LSCBench: Claude Code z Fable 5.1 pisze bezpieczny kod w 37,4% zadań
Analiza / Opinia

Endor Labs potwierdza lukę z LSCBench: Claude Code z Fable 5.1 pisze bezpieczny kod w 37,4% zadań

4 min

Luka między kodem, który działa, a kodem bezpiecznym przeszła dwa sprawdziany. Cole Halton przeliczył ranking LSCBench z 2700 zapisów pracy agentów i niemal wszystko się zgodziło, a przy okazji wyszło, że Claude Fable 5 zabezpieczył tę samą podatność we wszystkich trzech wariantach zadania tylko w 12% przypadków. Agent Security League od Endor Labs pokazuje to samo na innych zadaniach, bo prowadzący Claude Code z Fable 5.1 zalicza 87,2% testów funkcjonalnych, ale tylko 37,4% testów bezpieczeństwa. Zamiast czekać na lepszy model, lepiej dopisać do CI testy odtwarzające atak.

LSCBench: najlepszy agent pisze kod działający i bezpieczny w 25% zadań
Bezpieczeństwo

LSCBench: najlepszy agent pisze kod działający i bezpieczny w 25% zadań

5 min

W LSCBench, benchmarku badaczy z NUS i Alibaby, sześć czołowych agentów zalicza od 73,6% do 91,3% zadań funkcjonalnie, ale najlepszy, Claude Fable 5, pisze kod działający i zarazem bezpieczny tylko w 25,1% przypadków. Kimi-K3 ma najwyższy wynik funkcjonalny i najniższy wynik bezpieczeństwa, a 57 ze 150 podatności nie zabezpieczył żaden model. Dopisek o bezpieczeństwie podniósł GPT-5.6-Sol z 24,7% do 46,2%, lecz prawdziwą ochronę dają dopiero testy, które odtwarzają atak.

FrontierCS 2: Claude Opus 5.5 zalicza 58% prób, a 16 zadań badawczych nie przeszedł żaden agent
Analiza / Opinia

FrontierCS 2: Claude Opus 5.5 zalicza 58% prób, a 16 zadań badawczych nie przeszedł żaden agent

3 min

W FrontierCS 2, nowym benchmarku badaczy z MIT i Stanforda, agent dostaje kod z prawdziwej pracy naukowej, z którego wycięto jej właściwy wkład, a ostateczną ocenę wystawia ukryty zestaw testów. Najlepszy był Claude Opus 5.5, którego poprawki zaliczyły 58% prób, ale na 16 z 48 zadań nie poradził sobie żaden z 12 agentów. Zadanie przechodzi tylko wtedy, gdy spełnione są wszystkie metryki, więc lepsza średnia nie wystarcza. Agentowi warto więc oddawać tylko takie zadania, których wynik umiemy sami sprawdzić.