Analiza / Opinia
Claude Code, OpenCode i mini-SWE-agent na tych samych modelach: wynik ten sam, rachunek do trzech razy wyższy
Badacze z Uniwersytetu Shandong uruchomili te same modele w Claude Code, OpenCode i mini-SWE-agent na blisko 500 zadaniach z SWE-bench Verified i wyszło, że harness nie podnosi skuteczności ponad zwykły rozrzut między próbami, za to potrafi potroić koszt zadania. Claude Code wysyła na start ponad 16,5 tysiąca tokenów stałego kontekstu, a mini-SWE-agent nieco ponad 800, i ten narzut rośnie z każdym krokiem. Zanim zapłacisz za cięższy harness, warto dwa razy puścić własną konfigurację i zobaczyć, o ile wynik waha się sam z siebie.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Analiza / Opinia · 5 min ·
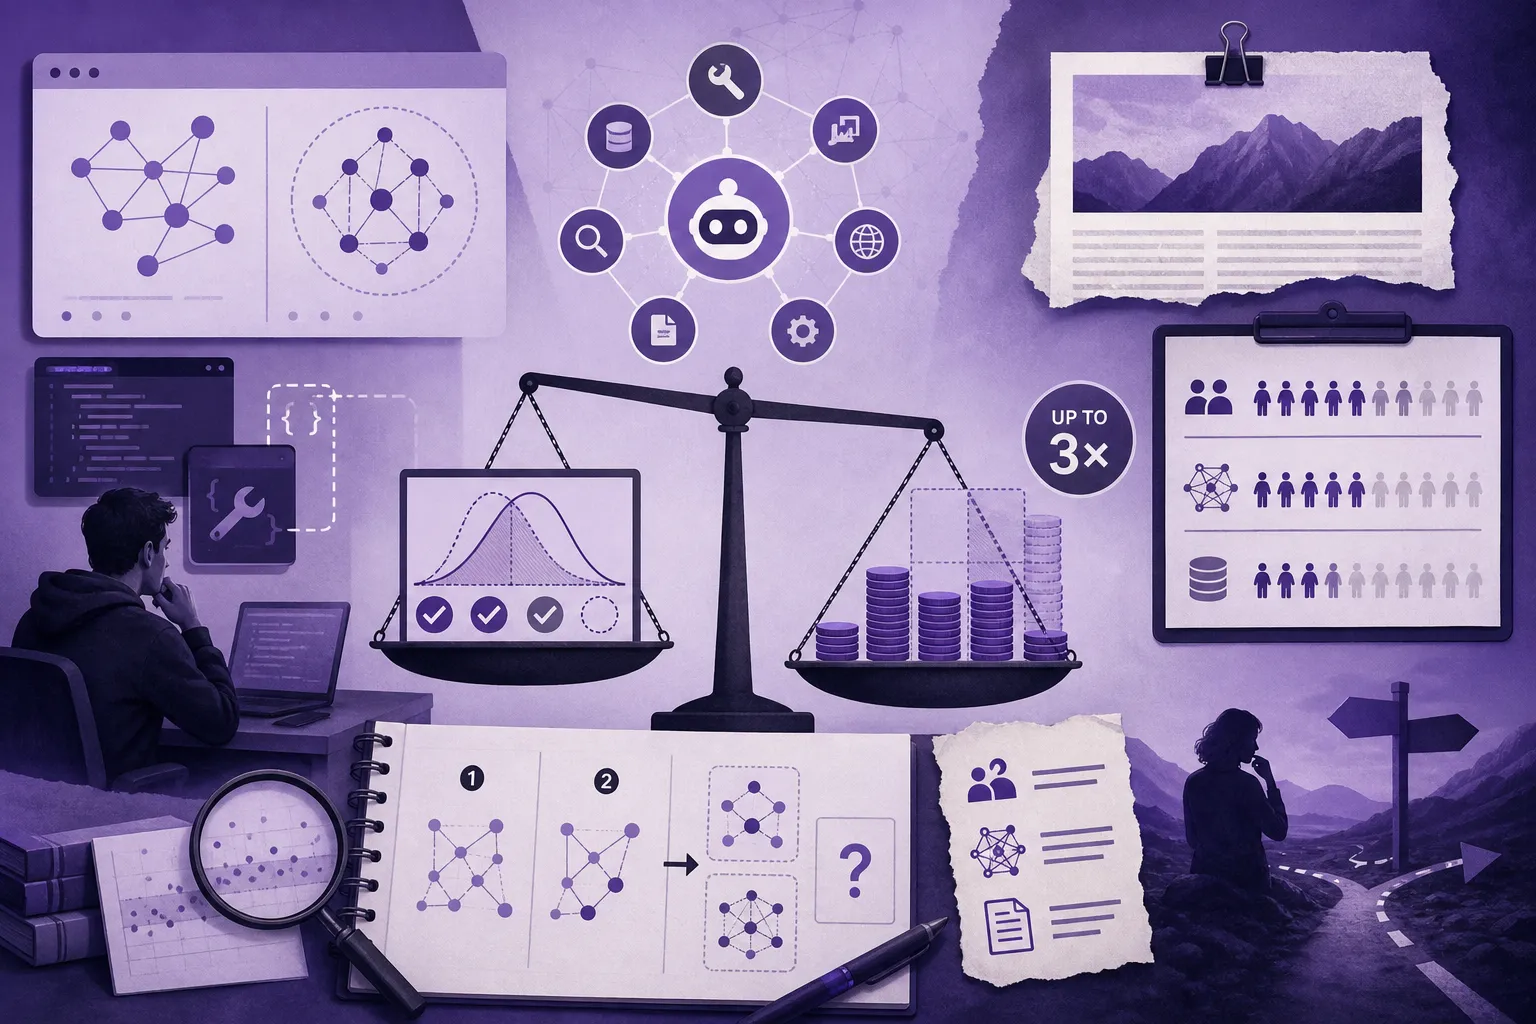
Badacze z Uniwersytetu Shandong wzięli kilka modeli, uruchomili każdy w trzech różnych harnessach i puścili je na blisko 500 zadań z SWE-bench Verified: prawdziwych błędów z otwartych repozytoriów, które agent ma samodzielnie naprawić. Harness to cała warstwa wokół modelu: prompt systemowy, narzędzia, którymi agent może działać, i reguły decydujące, co z długiej rozmowy zostaje w pamięci. Wynik, opisany przez VentureBeat na podstawie pracy opublikowanej na arXiv, jest niewygodny dla każdego, kto wybiera agenta po tabelkach producentów: skuteczność wyszła w praktyce taka sama, a koszt jednego zadania różnił się nawet trzykrotnie.
Czytam to przede wszystkim jako ostrzeżenie przed tym, jak sam ustawiam swojego agenta, a dopiero potem przed marketingiem. Jeśli mój agent przy każdym kroku odsyła modelowi kilkanaście tysięcy tokenów instrukcji, to płacę za nie zawsze, niezależnie od tego, czy dzięki nim rozwiązuje choć jedno zadanie więcej.
Trzy harnessy, te same modele
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.