SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Z 30% do 95,5% na tym samym benchmarku, bez ruszania wag modelu

Prime Intellect opublikował 24 sierpnia raport, z którego wynika, że wymiana samego harnessu podnosi wynik na ARC-AGI-3 z 30% do 95,5%, przy nietkniętych wagach modelu. Prime Agent trzyma przez cały bieg jedną sesję IPythona, więc model filtruje własny dziennik pracy kodem zamiast przepychać go przez okno kontekstowe, a zapisane notatki i umiejętności przechodzą do następnego uruchomienia. Skłaniam się ku tezie autorów, że wcześniejsze pomiary mówiły głównie o cudzych harnessach, ale liczba jest ich własna i nikt jej niezależnie nie powtórzył.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Z 30% do 95,5% na tym samym benchmarku, bez ruszania wag modelu
Ilustrację przygotowała AI.

Wybierasz model, obudowujesz go własnym harnessem, puszczasz na benchmark i dostajesz wynik, po którym stwierdzasz, że model jeszcze nie daje rady. Prime Intellect, firma od rozproszonego trenowania modeli, opublikowała 24 sierpnia na arXiv raport techniczny, z którego wynika, że mierzyłeś wtedy głównie własny harness: te same zadania z ARC-AGI-3, harness Prime Agent zamiast dotychczasowego, a wynik idzie z 30% do 95,5% za jednym podejściem, bez powtórek.

ARC-AGI-3 sprawdza co innego niż zwykły benchmark do kodu. Agent trafia tam do zadania, którego nie widział w trenowaniu, i musi sam, krok po kroku, dojść do jego reguł, zamiast odtworzyć wyuczony wzorzec. Harness decyduje przy tym, co model widzi w danym kroku, jakich narzędzi może w tym zadaniu użyć i ile zdąży zrobić, zanim skończy mu się okno kontekstowe. Autorzy wyciągają z tego prostą tezę: kiepski harness zwala własne awarie na konto modelu.

Kontekst jako dane, które można pociąć kodem

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Co, jeśli lepszy agent nie potrzebuje większego modelu, tylko lepszego harnessu?
Premiera / Narzędzie

Co, jeśli lepszy agent nie potrzebuje większego modelu, tylko lepszego harnessu?

3 min

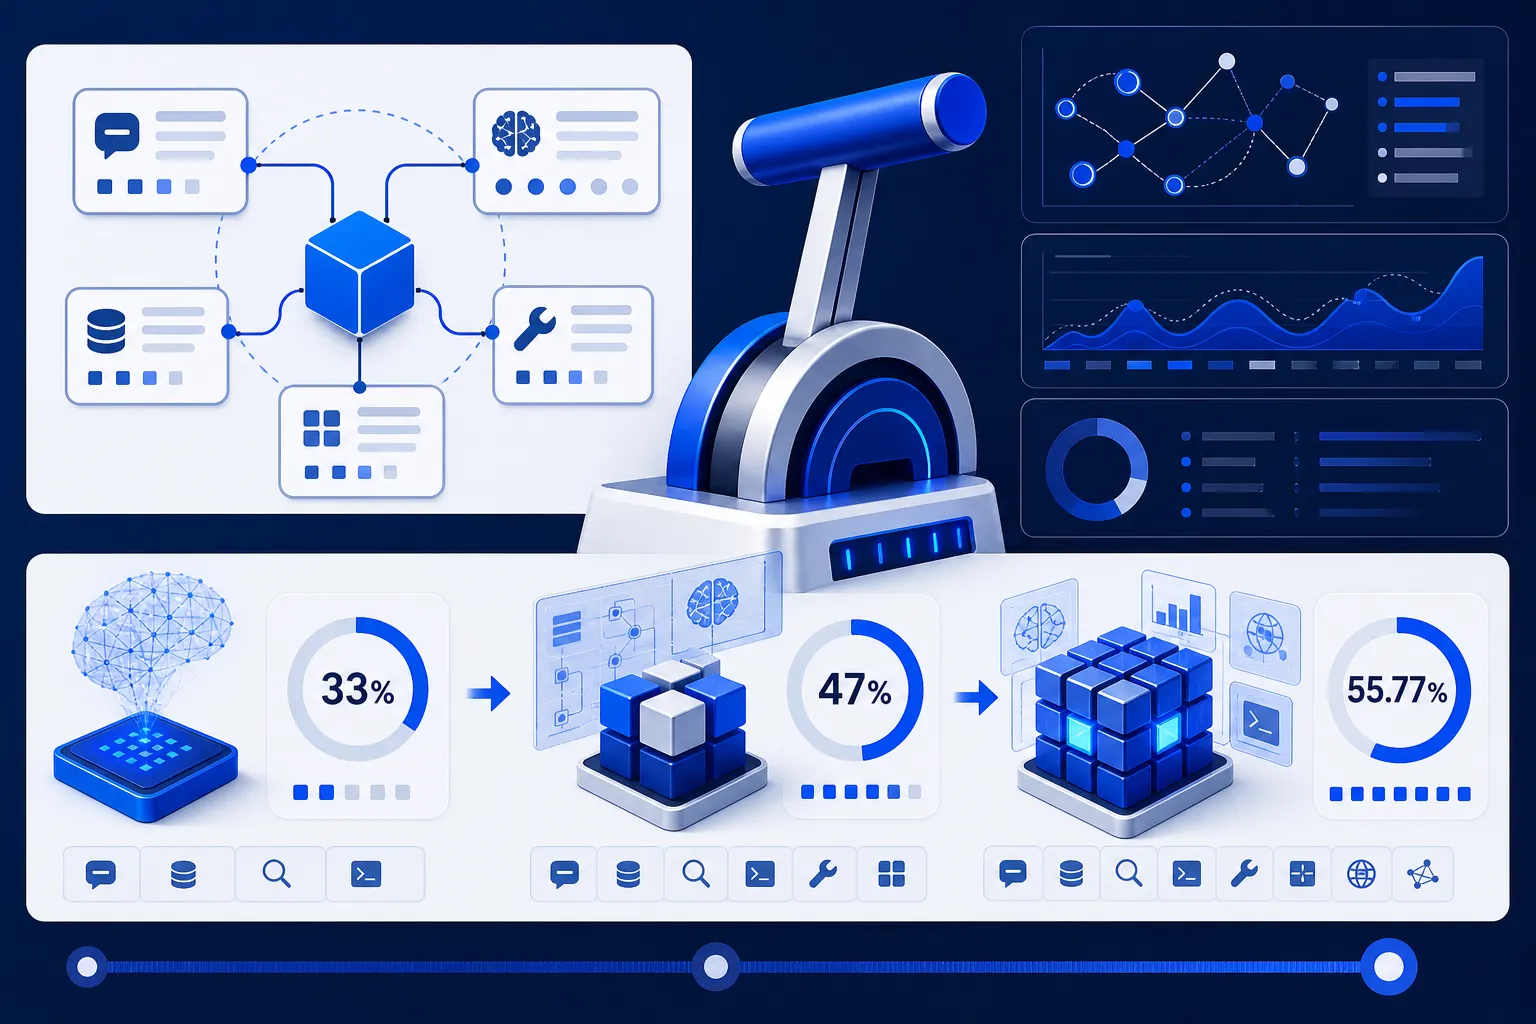
HarnessX, otwarty framework Darwin Agent na licencji MIT, traktuje harness — warstwę wokół modelu, która decyduje o narzędziach, pamięci i kontekście — jako wymienny klocek, ulepszany osobno od samych wag. Na Qwenie 3.5 9B sama przebudowa harnessu podnosi wynik na GAIA z 33,97% do 41,67%, a douczenie modelu RL-em dociąga go do 55,77%; ten sam schemat na GPT-5 idzie z 62% do 84%. Skłaniam się ku tezie, że architektura agenta to dźwignia, po którą sięga się za rzadko, ale liczby podał sam autor na jednym benchmarku, w wersji 0.1.0 beta, i wciąż czekają na niezależne powtórzenie.

Claude Code, OpenCode i mini-SWE-agent na tych samych modelach: wynik ten sam, rachunek do trzech razy wyższy
Analiza / Opinia

Claude Code, OpenCode i mini-SWE-agent na tych samych modelach: wynik ten sam, rachunek do trzech razy wyższy

5 min

Badacze z Uniwersytetu Shandong uruchomili te same modele w Claude Code, OpenCode i mini-SWE-agent na blisko 500 zadaniach z SWE-bench Verified i wyszło, że harness nie podnosi skuteczności ponad zwykły rozrzut między próbami, za to potrafi potroić koszt zadania. Claude Code wysyła na start ponad 16,5 tysiąca tokenów stałego kontekstu, a mini-SWE-agent nieco ponad 800, i ten narzut rośnie z każdym krokiem. Zanim zapłacisz za cięższy harness, warto dwa razy puścić własną konfigurację i zobaczyć, o ile wynik waha się sam z siebie.

Self-Harness: agent czyta własne logi i sam łata swoje opakowanie
Analiza / Opinia

Self-Harness: agent czyta własne logi i sam łata swoje opakowanie

4 min

Self-Harness, opisany w pracy z arXiv z 8 czerwca, każe agentowi czytać własne logi z awarii i samodzielnie przepisywać reguły swojego opakowania w pętli: znajdź słabość, załataj, przepuść zmianę przez testy regresji. Na Terminal-Bench-2.0 największy skok zaliczył najsłabszy model, Qwen3.5, który z 23,8% doszedł do 38,1%, podczas gdy mocniejsze MiniMax M2.5 i GLM-5 podniosły się słabiej. Wygląda to więc na sposób, żeby tańszy albo hostowany lokalnie model podciągnąć do poziomu, na którym w ogóle nadaje się do roboty, choć zostaje pytanie, kto potem czyta reguły, które napisał model.