SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Jak pozbyć się pętli, która czyści JSON po modelu

Outlines, biblioteka open-source firmy .txt, wymusza strukturę odpowiedzi modelu już w trakcie generacji: na każdym kroku wykreśla z listy możliwych tokenów te, które złamałyby zadany schemat, więc niepoprawny JSON nie ma jak powstać, a warstwa czyszczenia po fakcie znika. Piszący kod podaje tylko prompt i zwykły typ Pythona, od Literal po model Pydantic. Twarda gwarancja działa jednak wyłącznie na modelach uruchamianych lokalnie, bo przy zamkniętym API o format dba mechanizm dostawcy. Metoda z publikacji z 2023 roku pilnuje kształtu, nie prawdy.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Jak pozbyć się pętli, która czyści JSON po modelu
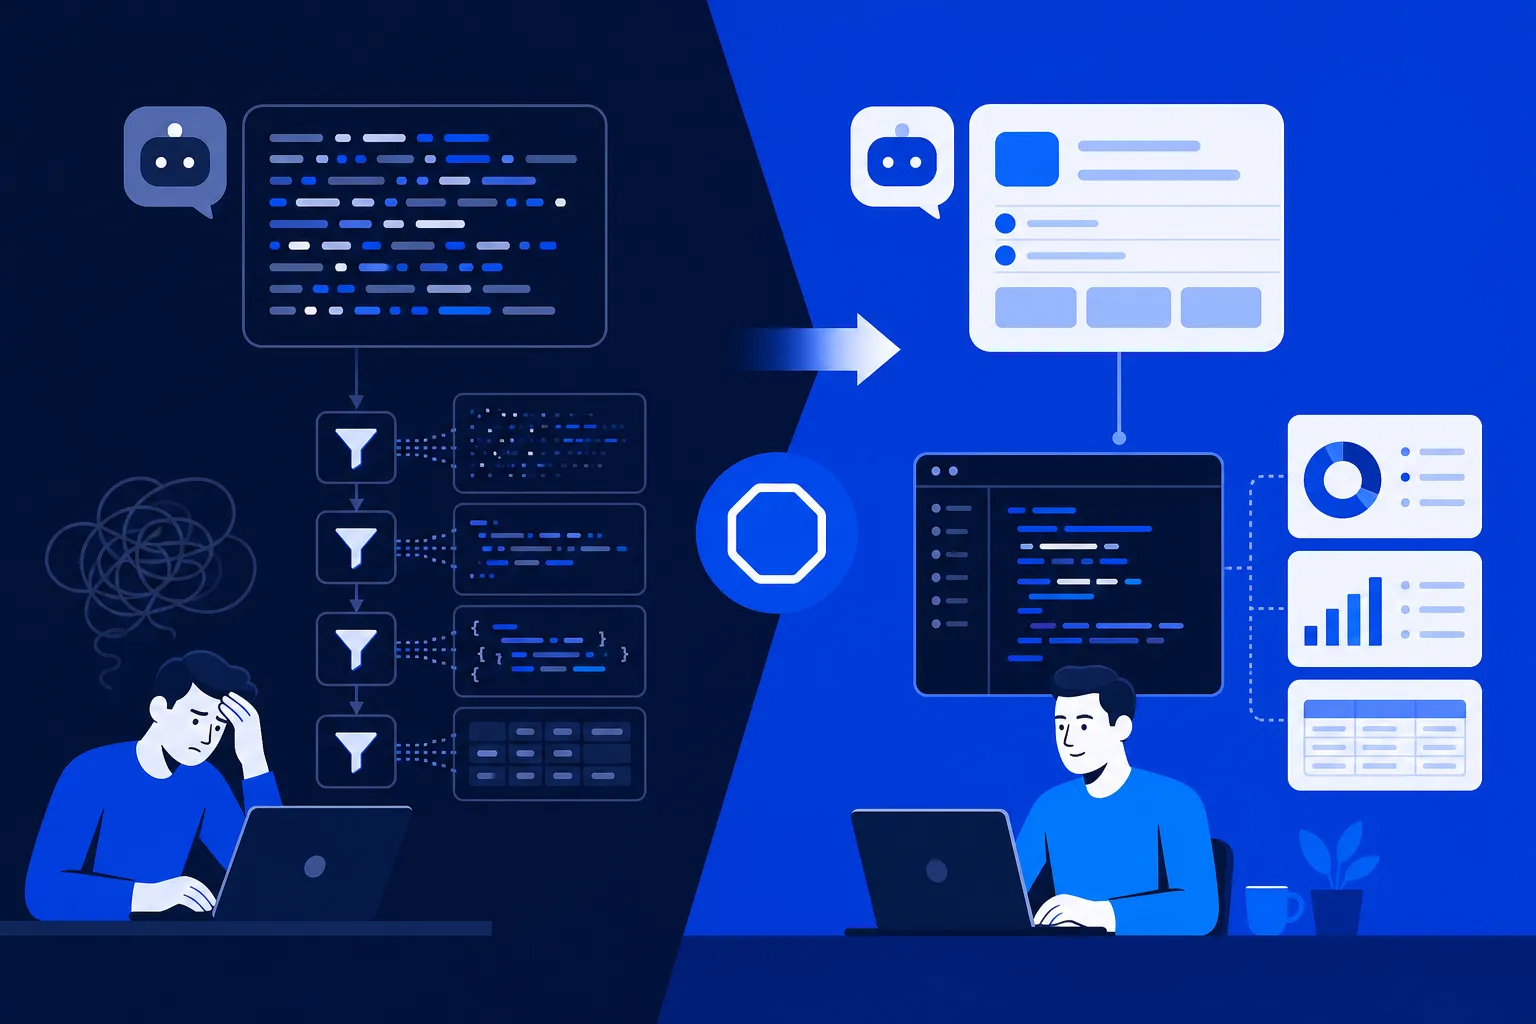
Ilustrację przygotowała AI.

Znasz to uczucie: prosisz model o JSON, dostajesz coś, co wygląda prawie dobrze, i zaczyna się sprzątanie. Zabłąkany przecinek na końcu listy, zdanie wstępu owinięte wokół właściwej odpowiedzi, a do tego pole, którego miało nie zabraknąć, a jednak go nie ma. Więc dopisujesz pętlę, która ponawia zapytanie, wyrażenie regularne, które wyłuskuje właściwe nawiasy klamrowe, i blok try/except na moment, gdy i to zawiedzie. Ta warstwa czyszczenia po fakcie potrafi urosnąć do połowy kodu, który w ogóle dotyka modelu, i nie jest to kod o twoim produkcie. To kod o tym, że model bywa nieprzewidywalny.

Outlines, biblioteka open-source firmy .txt, podchodzi do tego z drugiej strony. Zamiast poprawiać zły wynik po generacji, nie pozwala mu w ogóle powstać. Pomysł mi się podoba, choć z jednym zastrzeżeniem, do którego wrócę: twarda gwarancja działa węziej, niż obiecuje opis.

Model nie dostaje szansy, żeby zwrócić coś niepoprawnego

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Cztery dźwignie niezawodności, które zniknęły w drodze z modelu do API
Analiza / Opinia

Cztery dźwignie niezawodności, które zniknęły w drodze z modelu do API

4 min

Anthropic, OpenAI i Google po cichu zabrały cztery dźwignie niezawodności, które w lokalnym modelu z otwartymi wagami masz za darmo: prefill odpowiedzi, logprobs, pełen ślad rozumowania i ograniczone dekodowanie poza JSON-em. Claude stracił prefill wraz z modelami po 4.6, OpenAI odciął logprobs dla GPT-5, a ślad myślenia wszyscy trzej pokazują tylko w streszczeniu. To wybór polityczny podyktowany ryzykiem destylacji, nie ograniczenie inżynierskie; jeśli zamknięte API nie dorobią rozbudowanego endpointu, ruch wymuszą modele otwarte jak DeepSeek R1.

Wtyczka, która układa twoją historię w wątki, a model dokłada etykiety na końcu
Poradnik / Praktyka

Wtyczka, która układa twoją historię w wątki, a model dokłada etykiety na końcu

4 min

openloops, otwartoźródłowa wtyczka do Chrome'a z poradnika FreeCodeCampu autorstwa Shola Jegede, skanuje historię przeglądania i grupuje ją w wątki intencji, licząc podobieństwo domen i słów miarą Jaccarda. Cały rdzeń działa lokalnie w IndexedDB, bez jednego wywołania sieci, a Claude (model Haiku) tylko opcjonalnie dokłada tytuły i następne kroki. Pouczający jest moment, w którym pierwsza wersja po cichu się wywaliła: przy 30 wątkach odpowiedź uderzyła w limit max_tokens i urwała JSON. Lekcja brzmi tak, że model wpina się jako wycinalny dodatek, nie jako centrum produktu.

Sto procent poprawnego JSON-a, zero zgodności ze schematem
Poradnik / Praktyka

Sto procent poprawnego JSON-a, zero zgodności ze schematem

5 min

Prototyp Microsoftu zamieniający dziennik zmiany operatora przemysłowego na ustrukturyzowany JSON zdał test poprawności składniowej w 100%, a test zgodności ze schematem oblał na zero, bo model po cichu gubił całe wymagane sekcje. Zamiast poprawiać prompt, zespół przeszedł pole po polu i odkrył, że ponad połowa wartości już jest na wejściu, więc powinien je przepisać kod, nie model. Po rozdzieleniu pól deterministycznych od wymagających interpretacji zgodność wzrosła z zera do 47%, a metoda dociągnęła ją do 100% i utrzymała się nawet po podmianie modelu bazowego.