Poradnik / Praktyka
Sto procent poprawnego JSON-a, zero zgodności ze schematem
Prototyp Microsoftu zamieniający dziennik zmiany operatora przemysłowego na ustrukturyzowany JSON zdał test poprawności składniowej w 100%, a test zgodności ze schematem oblał na zero, bo model po cichu gubił całe wymagane sekcje. Zamiast poprawiać prompt, zespół przeszedł pole po polu i odkrył, że ponad połowa wartości już jest na wejściu, więc powinien je przepisać kod, nie model. Po rozdzieleniu pól deterministycznych od wymagających interpretacji zgodność wzrosła z zera do 47%, a metoda dociągnęła ją do 100% i utrzymała się nawet po podmianie modelu bazowego.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Poradnik / Praktyka · 5 min ·
Zespół z Microsoftu zbudował prototyp, który zamienia dziennik zmiany operatora przemysłowego na uporządkowane podsumowanie dla kolejnej zmiany, pulpitu zgodności i audytu. Działający pokaz powstał w kilka dni, a JSON na wyjściu parsował się za każdym razem. Potem puścili na to swój zestaw testów, który sprawdzał dwie różne rzeczy naraz: czy plik da się w ogóle wczytać i czy naprawdę zawiera wszystko, co miał zawierać. Wynik powinien spędzać sen z powiek każdemu, kto buduje coś na LLM-ach: pierwszy test zdał w 100%, drugi oblał na zero.
Te dwie liczby brzmią sprzecznie tylko dopóki nie rozdzieli się tego, co każda z nich mierzy. JSON poprawny składniowo to taki, który da się wczytać, każdy nawias się domyka, wartości mają właściwe typy, i to właśnie zdawał za każdym razem. Zgodność ze schematem to coś zupełnie innego: czy w dokumencie naprawdę są wszystkie wymagane sekcje, wypełnione treścią. I tu prototyp oblewał na zero. Model po cichu gubił całe sekcje. Nie dlatego, że nic się na zmianie nie wydarzyło, tylko dlatego, że zapomniał je wstawić. Pracownik schodzący na nową zmianę otwierał podsumowanie i nie znajdował w nim ani zdarzeń, ani zadań do dokończenia, ani spodziewanych warunków, choć w dzienniku to wszystko było.
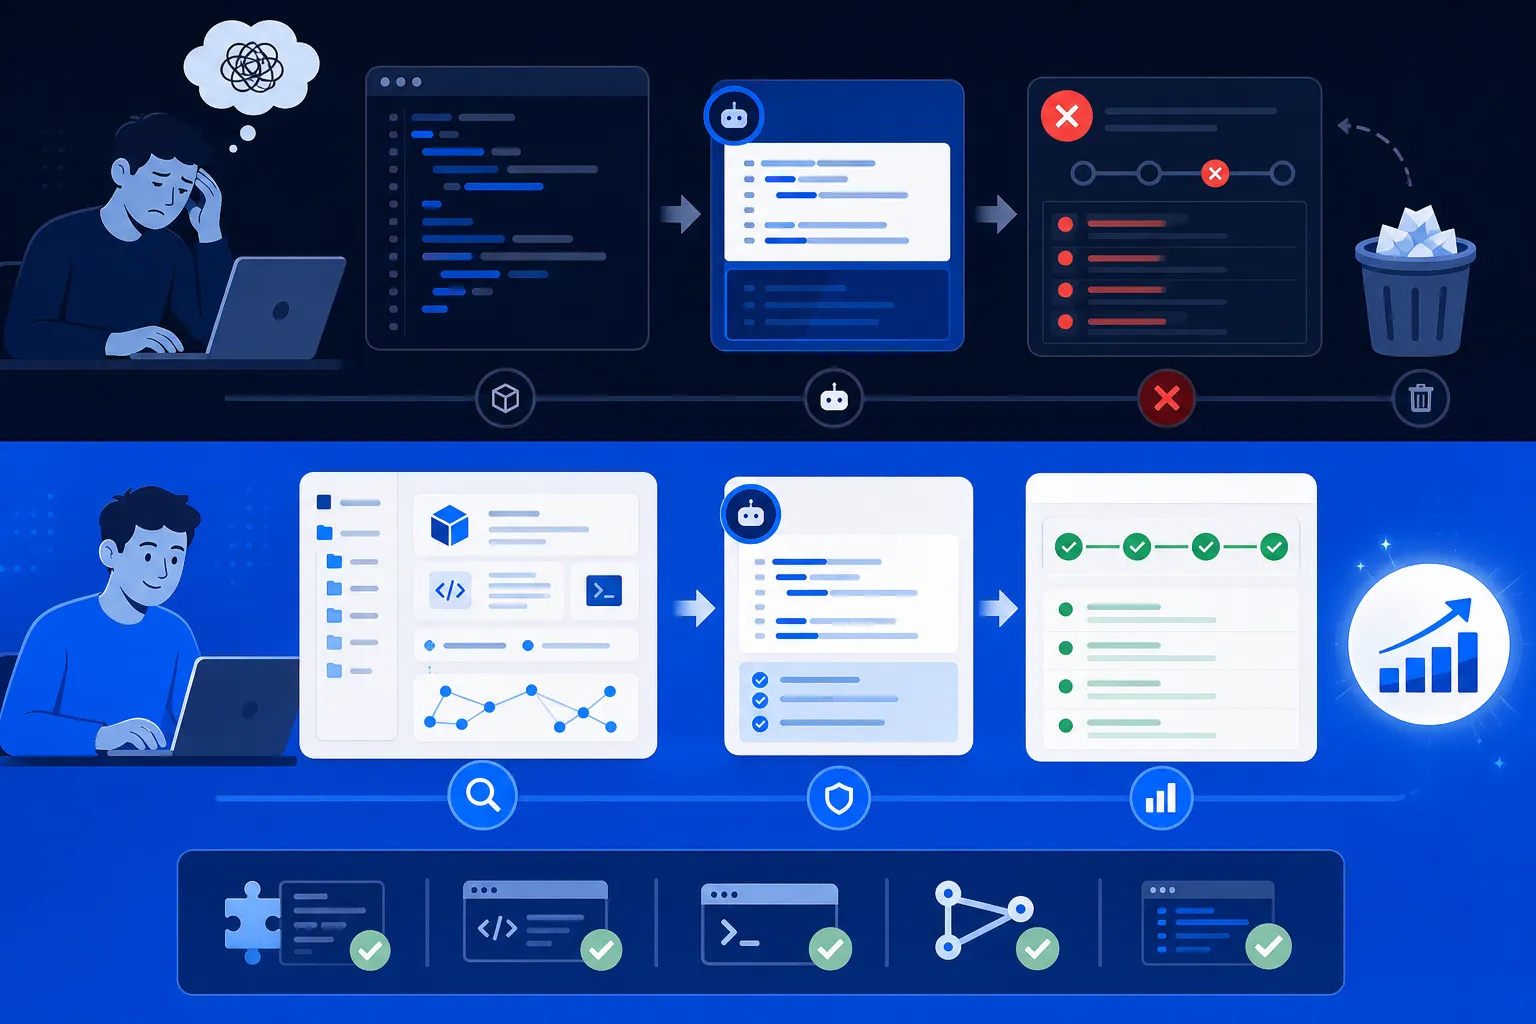
Pierwsze podejście było tym najbardziej naturalnym: jeden prompt dostaje cały dziennik i ma wypluć cały dokument JSON. Model czyta, decyduje i generuje wszystko naraz, a przy okazji część rzeczy mu się ulatnia. Wymagane sekcje pojawiały się w jednych wynikach i znikały w innych bez żadnego wzorca, który dałoby się wskazać palcem i naprawić.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.