Premiera / Narzędzie
Jedno polecenie w terminalu mówi, który model ruszy na twoim sprzęcie
llmfit jednym poleceniem sprawdza, co masz w maszynie, i wypisuje tabelę modeli ocenionych na czterech osiach: czy się zmieszczą, jak szybko pójdą, jak dobre dają odpowiedzi i ile kontekstu uniosą. Liczy tylko te podsieci, które pracują przy każdym tokenie, więc Mixtral czy DeepSeek-V3 dostają werdykt "zmieści się" tam, gdzie kalkulator sumujący wszystkie wagi odsyła z kwitkiem. Własny pomiar tokenów na sekundę odsyłasz do projektu jako PR wprost z terminala, a polecenie llmfit info pokazuje, na jakich założeniach stoi każda liczba. Celności tych szacunków nikt niezależnie nie potwierdził.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
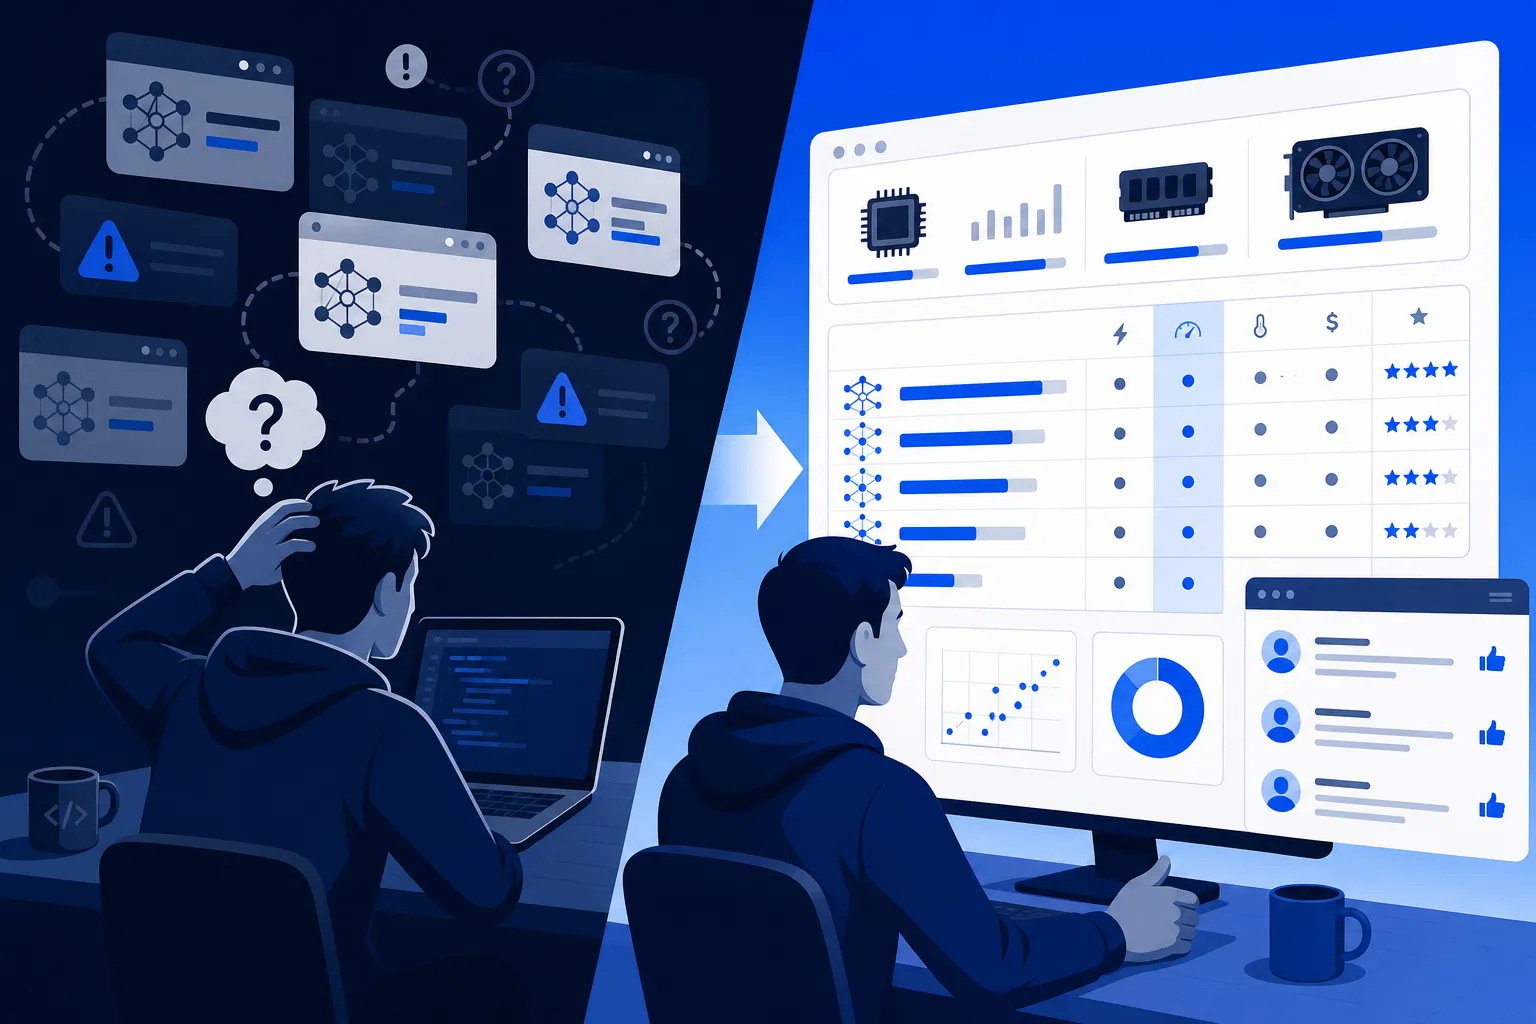
Pobranie modelu, który się nie mieści, boli dopiero na końcu. Na dysk leci 20 GB wag, Ollama wstaje, pierwsze zdanie odpowiedzi kapie po jednym tokenie na sekundę i w tym momencie okazuje się, że karta tego nie uniesie. llmfit odwraca tę kolejność, bo jedno polecenie w terminalu sprawdza, co masz w maszynie, i wypisuje tabelę modeli uszeregowanych według tego, jak pójdą na twoim sprzęcie. Przekonuje mnie przy tym nie sam ranking, tylko to, że llmfit nie udaje, że jego liczby są faktami: przy każdej pozycji widać, skąd dana liczba się wzięła i czy ktokolwiek zmierzył ją na prawdziwej maszynie.
Cztery oceny zamiast jednego "zmieści się"
Narzędzie samo wykrywa rdzenie procesora, pamięć operacyjną i karty graficzne razem z ich VRAM-em, a na Macach z Apple Silicon także pamięć dzieloną między procesor a układ graficzny. Potem przelicza każdy model ze swojego katalogu na czterech osiach naraz: czy się zmieści, jak szybko będzie generował tekst, jak dobre są jego odpowiedzi i ile kontekstu uniesie.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.