SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Karta modelu nie powie wam, co się stanie na telefonie

Liquid AI wypuściło Pipette, otwartą platformę mierzącą modele na telefonach, a nie na serwerowych kartach graficznych: ponad tysiąc pomiarów dla 30 modeli, między innymi na iPhonie 17 Pro i Galaxy S26 Ultra. Artificial Analysis zweryfikowało metodykę i pokazało rachunek za ten sam wynik: Nanbeige4.2-3B i LFM2.5-2.6B remisują na 63 punktach, tylko że pierwszy odpowiada w 21 sekund, a drugi w 8. Gdy każda odpowiedź dostaje minutę na iPhonie, Nanbeige spada do 18 punktów, a wygrywa LFM2.5-8B-A1B. Zestaw modeli dobierało jednak samo Liquid AI, więc czytam tę tablicę z zastrzeżeniem.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
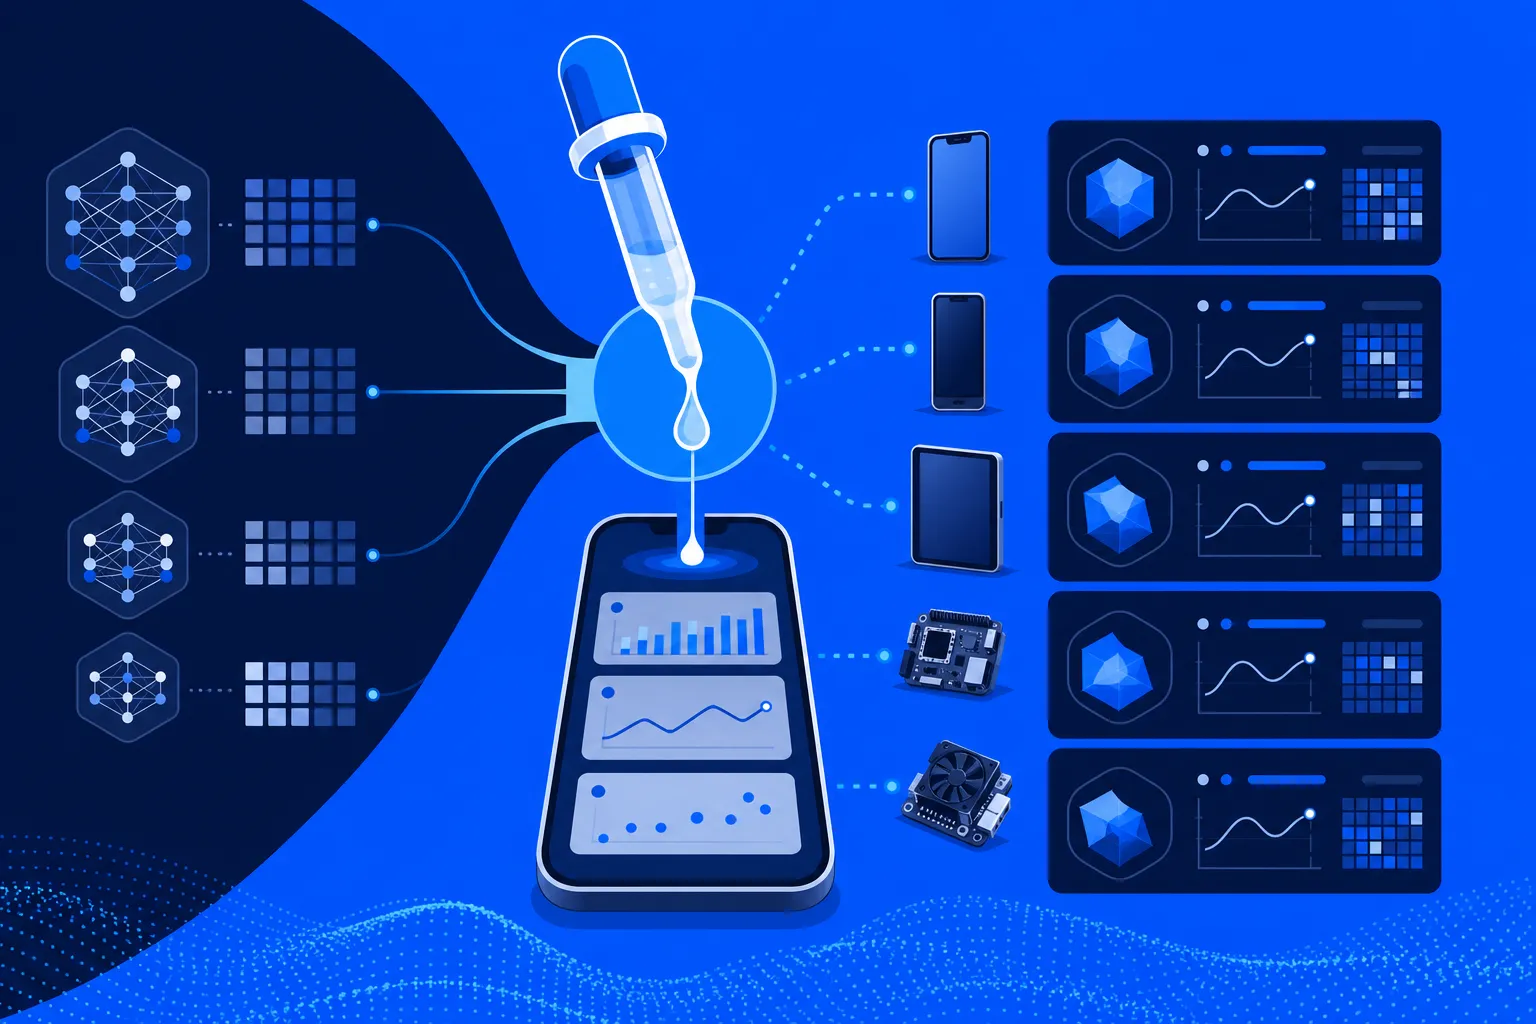
Karta modelu nie powie wam, co się stanie na telefonie
Ilustrację przygotowała AI.

Na Galaxy S26 Ultra stoją obok siebie dwa modele z rodziny Granite, którą rozwija IBM, oba po 350 milionów parametrów i oba ściśnięte do czterech bitów na wagę, w postaci, w jakiej telefon faktycznie ładuje model. Takie ściskanie nazywa się kwantyzacją i płaci się za nie kawałkiem dokładności. Gdy prompt rośnie z 256 do 4096 tokenów, Granite-4.0-H-350M zachowuje 78,4% swojej prędkości generowania, a niemal identycznie nazwany Granite-4.0-350M już tylko 33,8%. Nic w specyfikacji, którą IBM publikuje razem z modelem, tego nie zapowiada.

Liquid AI wypuściło Pipette, otwartą platformę do mierzenia modeli na sprzęcie, na którym naprawdę mają działać. Liczby, które laboratoria podają przy premierze, powstają na serwerowych kartach graficznych i w pełnej precyzji, więc opisują model w laboratorium, a nie to, co z niego zostaje po skwantyzowaniu do czterech bitów i wpuszczeniu na grzejący się procesor telefonu. Pipette mierzy tę drugą sytuację i publikuje ponad tysiąc pomiarów: każdy model w kilku kwantyzacjach, na kilku silnikach i urządzeniach, przy różnych długościach kontekstu. Na razie w bazie jest ponad 30 modeli, mierzonych na MacBooku Pro, iPhonie 17 Pro i Galaxy S26 Ultra.

Kod, który te pomiary wykonuje, wyszedł na licencji Apache 2.0, razem z gotowymi aplikacjami na iOS i Androida, więc własny telefon każdy może zmierzyć sam. Ważniejsza od kodu jest metodyka: każdy pomiar to pięć powtórzeń liczonych dopiero po odrzuceniu rozgrzewki, a przed każdym z nich Pipette sprawdza temperaturę i obciążenie urządzenia. Telefon, który zdążył się rozgrzać, sam zwalnia, żeby się nie przegrzać, i taki wynik do bazy nie trafia.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Jedno polecenie w terminalu mówi, który model ruszy na twoim sprzęcie
Premiera / Narzędzie

Jedno polecenie w terminalu mówi, który model ruszy na twoim sprzęcie

4 min

llmfit jednym poleceniem sprawdza, co masz w maszynie, i wypisuje tabelę modeli ocenionych na czterech osiach: czy się zmieszczą, jak szybko pójdą, jak dobre dają odpowiedzi i ile kontekstu uniosą. Liczy tylko te podsieci, które pracują przy każdym tokenie, więc Mixtral czy DeepSeek-V3 dostają werdykt "zmieści się" tam, gdzie kalkulator sumujący wszystkie wagi odsyła z kwitkiem. Własny pomiar tokenów na sekundę odsyłasz do projektu jako PR wprost z terminala, a polecenie llmfit info pokazuje, na jakich założeniach stoi każda liczba. Celności tych szacunków nikt niezależnie nie potwierdził.

Liquid AI zmieścił agenta w 2,5 GB i puścił go bez chmury
Model / Badania

Liquid AI zmieścił agenta w 2,5 GB i puścił go bez chmury

4 min

Liquid AI wypuściło 4 sierpnia LFM2.5-2.6B, model o 2,6 miliarda parametrów, który mieści się w niecałych 2,5 GB i działa lokalnie na laptopie, telefonie czy Raspberry Pi, bez ani jednego zapytania do chmury. Kluczowa jest metoda: model dotrenowano wprost w harnessie agenta i nagradzano za faktyczny wynik, dzięki czemu na teście ToolSandbox wyprzedził trzykrotnie większego Qwen3.5-9B, choć na BFCLv4 już przegrywa. Skoro nie płacisz za tokeny do API, każde uruchomienie kosztuje zero, a firma otwarcie przyznaje, że do trudniejszych zadań programistycznych lepszy bywa większy model.

Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?
Poradnik / Praktyka

Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?

3 min

NVIDIA rozegrała na Kaggle konkurs, w którym ponad 5000 uczestników dostało ten sam model Nemotron-3-Nano-30B, mogło doszkalać tylko adapter LoRA i musiało zmieścić rozumowanie w sztywnym budżecie tokenów bez internetu. Z pięciu wniosków wraca jeden: model uczy się tak dobrze, jak dobrze da się sprawdzić każdy krok jego rozumowania, bo prawidłowa odpowiedź potrafi ukrywać zepsutą drogę, a jedna uśredniona liczba zamiata pod dywan słabości w konkretnych zadaniach. To podsumowanie NVIDIA, promujące jej model i karty Blackwell, ale kto dostraja własny model, dostaje gotową listę do sprawdzenia.