SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Kiedy poprawka promptu naprawdę coś daje? Claude Code dostał narzędzie, które to mierzy

Claude Code dostał w skillu claude-api dwie komendy: build-eval buduje zestaw testów z prawdziwych rozmów i zgłoszeń, a hillclimb poprawia aplikację krok po kroku i cofa każdą zmianę, która nie pomaga na odłożonej, niewidzianej puli przypadków. Na 44 zgłoszeniach do obsługi klienta wynik na zakrytej puli wzrósł z około 11 do prawie 13 na 14 przy jednej piątej kosztu, choć oszczędność przyniosła głównie przesiadka na Sonnet 5. Najcenniejsze jest jednak to, że narzędzie umie przyznać, że poprawka nic nie dała, i wskazać zepsuty test.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Kiedy poprawka promptu naprawdę coś daje? Claude Code dostał narzędzie, które to mierzy
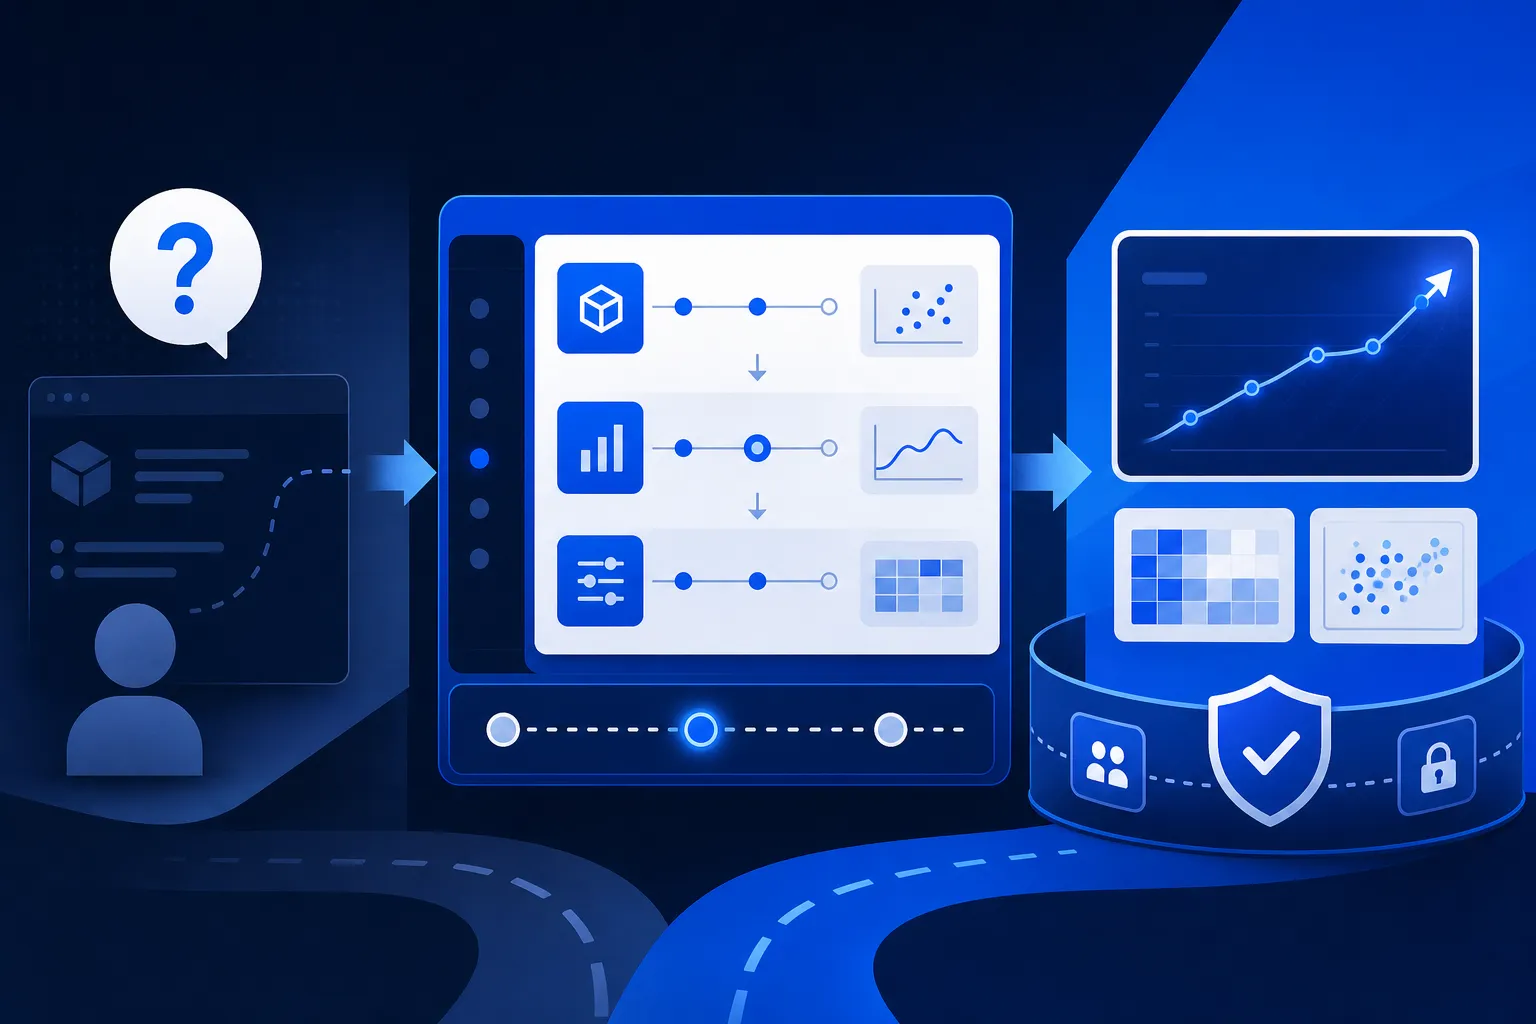
Ilustrację przygotowała AI.

Druga poprawka promptu wyglądała obiecująco. Claude dopisał dwa wzorcowe przykłady do promptu aplikacji, która rozdziela przychodzące maile między kolejki działów, i wynik na przypadkach, nad którymi pracował, poszedł w górę. Mimo to zmiana została wycofana. Część przykładów od początku odłożono na bok i Claude nigdy ich nie oglądał, właśnie po to, żeby sprawdzić, czy poprawka działa poza materiałem, na którym powstała. Na tej odłożonej puli nie poprawiło się nic. Tę scenę Anthropic pokazuje jako ilustrację nowej komendy /claude-api hillclimb w Claude Code i moim zdaniem to wycofanie jest w całej zapowiedzi ważniejsze niż sama poprawa wyniku.

Obie nowości trafiły do skilla claude-api, czyli pakietu instrukcji, który Claude Code wczytuje, kiedy piszesz kod korzystający z API Claude'a. Pierwsza komenda, /claude-api build-eval, buduje w repozytorium zestaw testów sprawdzających, jak twoja aplikacja z modelem w środku radzi sobie z prawdziwymi zadaniami. Druga poprawia aplikację krok po kroku i zostawia zmianę tylko wtedy, gdy wynik naprawdę rośnie. Opisał je zespół Claude Devs na swoim blogu. To moje jedyne źródło i pochodzi od producenta, a opisane w nim przykłady powstały na jego własnych zestawach testów, więc liczby z niego traktuję jako deklarację, nie niezależny pomiar.

Test, któremu można uwierzyć

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Dwa nawyki ze starych promptów, które na Opus 5 psują wynik Poradnik / Praktyka

Dwa nawyki ze starych promptów, które na Opus 5 psują wynik

4 min

Przewodnik Anthropica po promptowaniu Claude Opus 5 zapewnia, że prompty pisane pod Opusa 4.8 działają bez zmian, ale w dwóch miejscach stary nawyk po cichu psuje wynik. Bot recenzujący pull requesty, któremu kazano być zachowawczym, zgłasza mniej także prawdziwych błędów, więc lepiej prosić o wszystkie znaleziska i odsiewać je w osobnym, widocznym kroku. Prośba o wypisanie toku rozumowania może z kolei skończyć się odmową z kategorią reasoning_extraction i wywrócić automat, dlatego zamiast niej lepiej prosić o krótkie podsumowanie wykonanych kroków.

Claude Reflect zauważa, kiedy pytasz Claude'a o to samo, i proponuje z tego komendę Premiera / Narzędzie

Claude Reflect zauważa, kiedy pytasz Claude'a o to samo, i proponuje z tego komendę

3 min

Claude Reflect, wtyczka Bayrama Annakova, łapie hookami powtarzane w prompcie korekty ("nie, użyj venv") i po commicie proponuje przez `/reflect` dopisać je do `CLAUDE.md` oraz `AGENTS.md`. Detekcja jest hybrydowa: regex łapie wzorce angielskie od ręki, a semantyczny filtr modelu dorzuca korekty po polsku czy hiszpańsku z pewnością 0,60–0,95. Druga komenda, `/reflect-skills`, przegląda 14 dni sesji i z powtarzających się próśb generuje gotowe komendy w `.claude/commands/` z guardrails. Demo jednego dewelopera, 160 testów, brak danych o adopcji.

Co zmienić we własnych narzędziach do kodu przed przejściem na Opus 5? Poradnik / Praktyka

Co zmienić we własnych narzędziach do kodu przed przejściem na Opus 5?

4 min

Kto podpina Claude Opus 5 pod własne narzędzia do kodu, powinien przejrzeć stare prompty, bo model czyta je dosłownie: recenzent z poleceniem "zgłaszaj tylko poważne błędy" zacznie przemilczać realne problemy, więc lepiej zbierać wszystkie uwagi i odsiewać je osobnym przebiegiem. Poziom effort ustawiony na low lub medium daje według Anthropica dobre wyniki za ułamek tokenów, a wyłączone myślenie potrafi po cichu zamienić wywołanie narzędzia w zwykły tekst. Dlatego myślenie lepiej zostawić włączone i sprawdzać w logach, czy narzędzia naprawdę zadziałały.