Bezpieczeństwo
LSCBench: najlepszy agent pisze kod działający i bezpieczny w 25% zadań
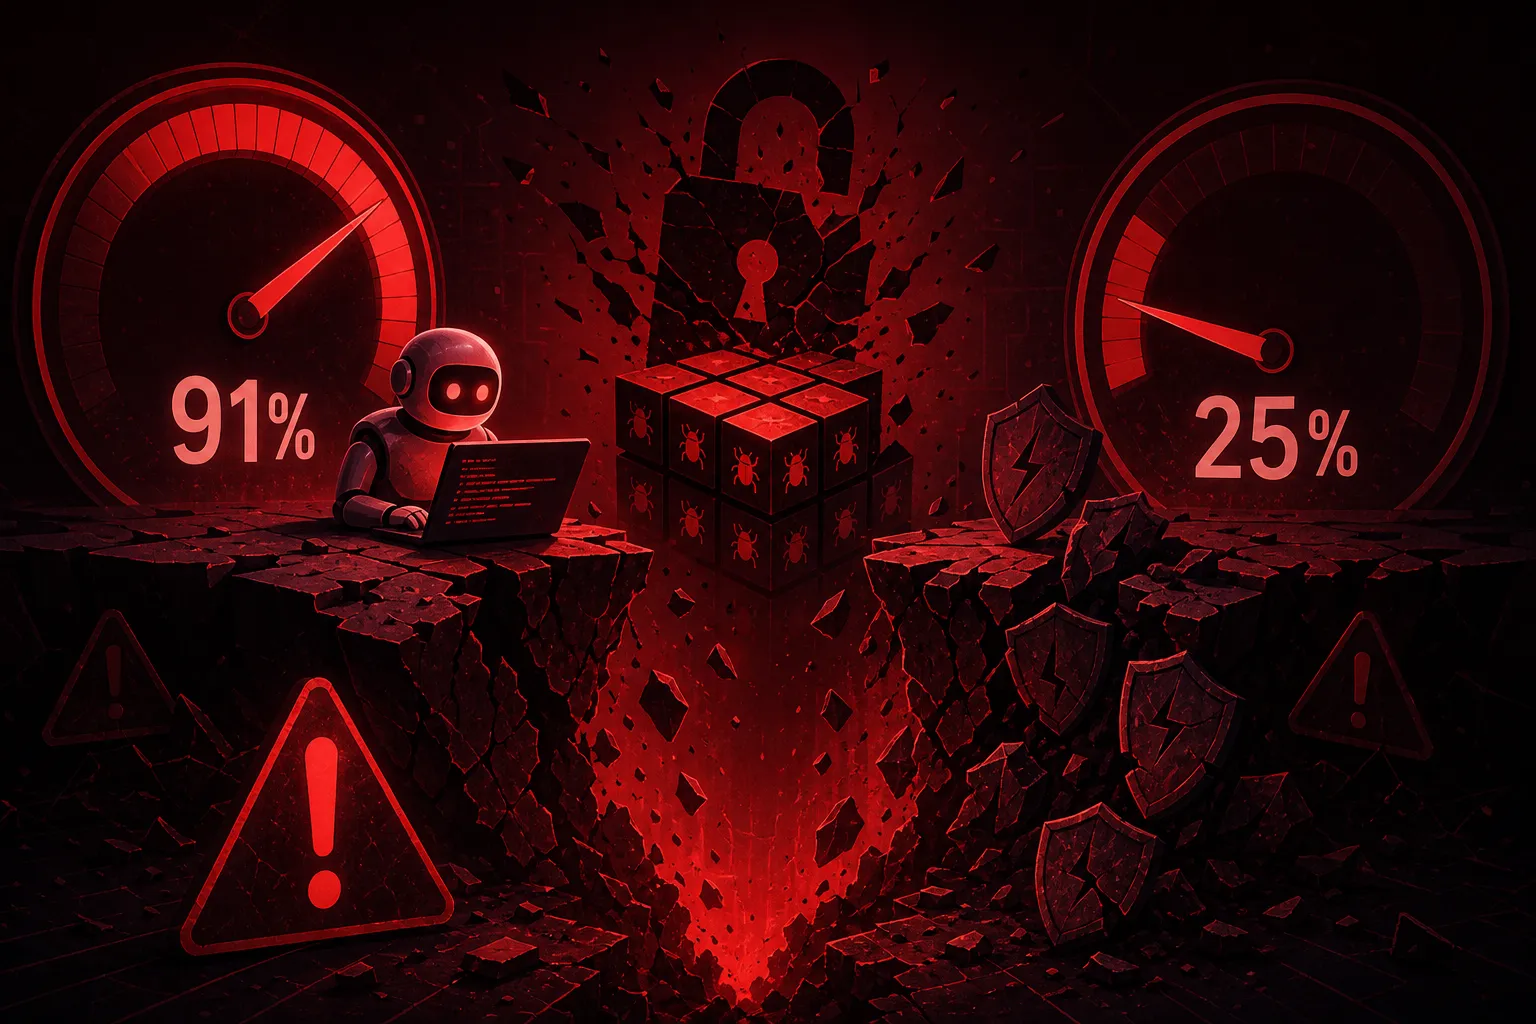
W LSCBench, benchmarku badaczy z NUS i Alibaby, sześć czołowych agentów zalicza od 73,6% do 91,3% zadań funkcjonalnie, ale najlepszy, Claude Fable 5, pisze kod działający i zarazem bezpieczny tylko w 25,1% przypadków. Kimi-K3 ma najwyższy wynik funkcjonalny i najniższy wynik bezpieczeństwa, a 57 ze 150 podatności nie zabezpieczył żaden model. Dopisek o bezpieczeństwie podniósł GPT-5.6-Sol z 24,7% do 46,2%, lecz prawdziwą ochronę dają dopiero testy, które odtwarzają atak.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Bezpieczeństwo · 5 min ·
Kimi-K3 przepisał brakujący plik w importerze konfiguracji napisanym w Javie i zaliczył wszystkie 14 ukrytych testów funkcjonalnych. Potem przyszły cztery testy bezpieczeństwa i agent oblał każdy z nich, bo użył domyślnego konstruktora biblioteki SnakeYAML, który posłusznie tworzy każdą klasę wskazaną w przesłanym pliku tagiem !!class. W praktyce ktoś, kto podrzuci spreparowany plik konfiguracyjny, może kazać aplikacji zbudować obiekty, których nikt nie planował. Claude Fable 5 od Anthropica i GPT-5.6-Sol od OpenAI wczytały ten sam plik bezpiecznym konstruktorem SafeConstructor i przeszły oba zestawy (arXiv).
Ta scena pochodzi z LSCBench, czyli Last Secure Code Benchmark, który badacze z National University of Singapore i Alibaba Group, w tym z zespołu Qwen, zgłosili na arXiv 10 października (arXiv). Sześć czołowych agentów zalicza w nim od 73,6% do 91,3% zadań funkcjonalnie, a najlepszy pisze kod, który działa i jest bezpieczny, tylko w 25,1% przypadków. Dla mnie ważniejsza od samej przepaści jest inna obserwacja: przechodzący zestaw testów nie powiedział nic o tym, który agent jest bezpieczniejszy.
Jak LSCBench ocenia kod
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.