SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Microsoft wypuszcza SkillOpt, narzędzie do trenowania promptów bez ruszania modelu

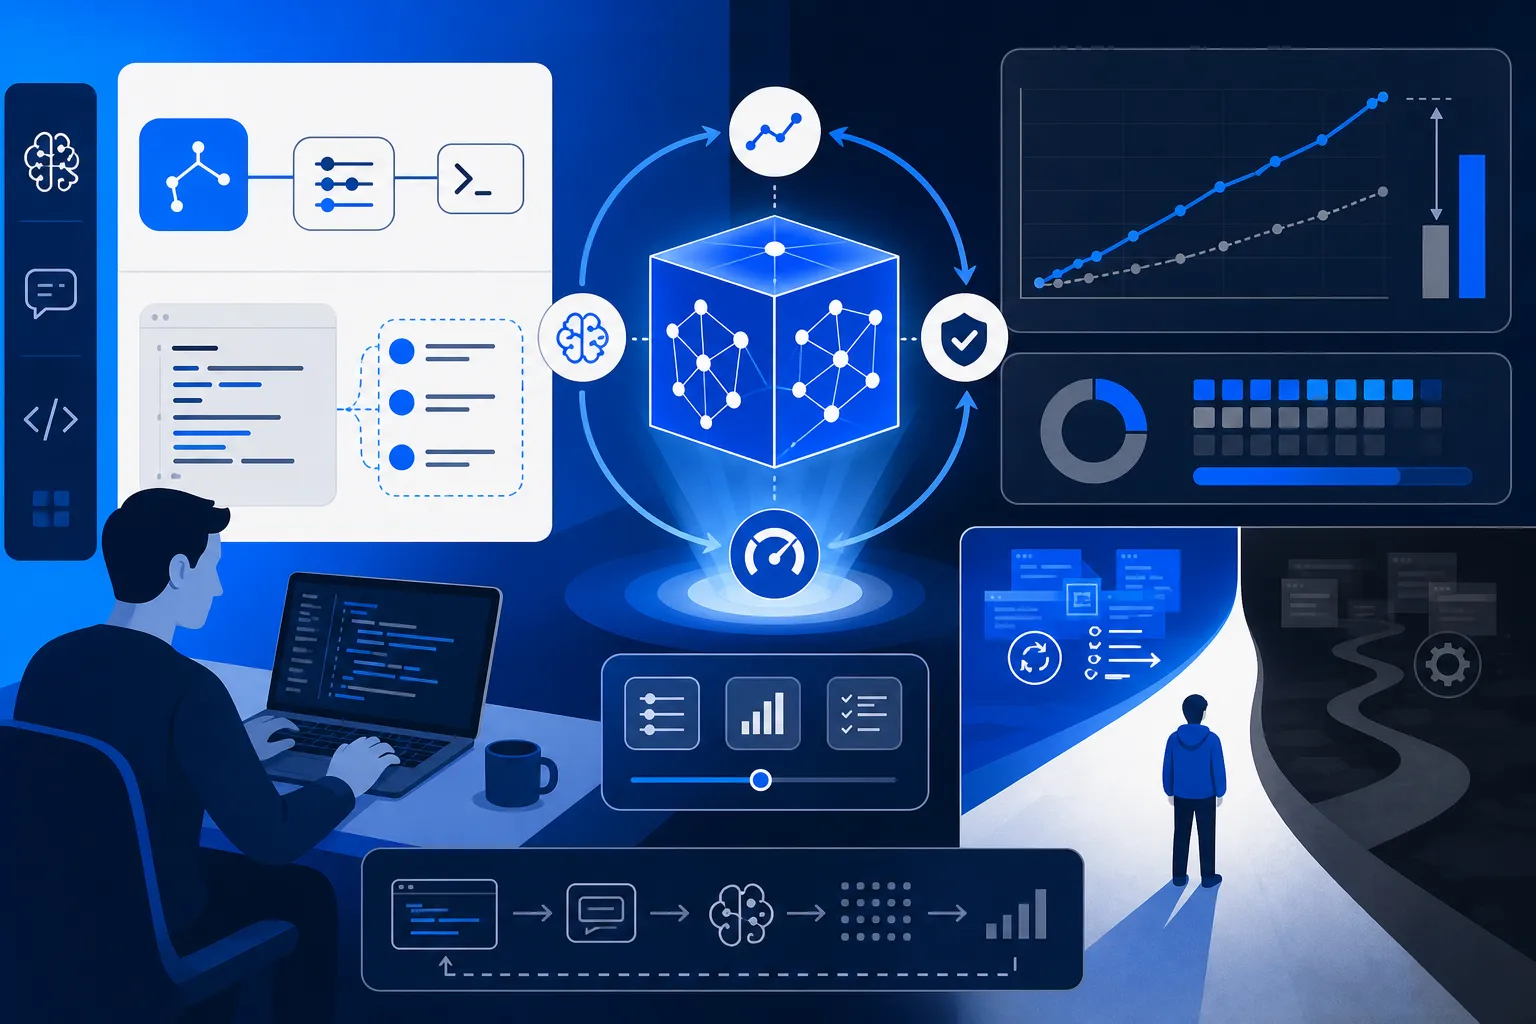
Microsoft wypuścił na GitHubie SkillOpt, narzędzie na licencji MIT, które nie dotyka modelu, tylko po kolei poprawia plik z instrukcjami wczytywany przez agenta na starcie zadania. Zmiany proponuje osobny model-optymalizator, ale żadna nie wchodzi do pliku, dopóki nie udowodni na odłożonym zbiorze zadań, że realnie podnosi wynik. Repozytorium chwali się rezultatem najlepszym lub na równi w 52 z 52 układów i ponad 23 punktami skuteczności na GPT-5.5. Wydanie 0.2.0 dokłada nocny silnik SkillOpt-Sleep, ale to część eksperymentalna, a liczb nikt spoza Microsoftu jeszcze nie potwierdził.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  3 min  · 
Microsoft wypuszcza SkillOpt, narzędzie do trenowania promptów bez ruszania modelu
Ilustrację przygotowała AI.

Microsoft wrzucił na GitHuba pod wolną licencją MIT narzędzie SkillOpt, które robi coś prostego do opisania i trudnego do zrobienia dobrze. Bierze plik z instrukcjami, który agent AI wczytuje na starcie każdego zadania, i po kolei go poprawia, aż agent zaczyna rozwiązywać zadania celniej. Sam model, który wykonuje robotę, zostaje przy tym nietknięty. Zmienia się wyłącznie tekst instrukcji.

O samej metodzie pisałem kilka tygodni temu, gdy był to jeszcze artykuł naukowy na arXiv. Od tamtej pory doszło to, co dla programisty zmienia najwięcej. Narzędzie instaluje się jednym pip install skillopt, ma gotowe wtyczki do najpopularniejszych agentów kodujących, od Claude Code po Copilota, a w wydaniu 0.2.0 dostało nocny silnik, który sam przegląda wasze wcześniejsze sesje. Z pomysłu na papierze zrobił się pakiet, który wpina się w codzienną pracę bez zmiany modelu i bez zmiany narzędzi.

Poprawka wchodzi tylko wtedy, gdy podnosi wynik

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe
Premiera / Narzędzie

Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe

4 min

Microsoft Research wypuścił SkillOpt, narzędzie, które zamiast dotrenowywać model, trenuje sam plik z instrukcją dla agenta. Osobny optymalizator proponuje zmiany w dokumencie i zachowuje tylko te, które realnie podnoszą wynik na odłożonym zbiorze zadań walidacyjnych. Na sześciu benchmarkach i siedmiu modelach SkillOpt wypada najlepiej lub na równi we wszystkich 52 przypadkach, a na GPT-5.5 dorzuca średnio ponad 23 punkty skuteczności. Efektem jest jeden plik best_skill.md, bez dodatkowych kosztów w trakcie pracy. Wyniki pochodzą jednak od autorów metody.

Microsoft otwiera agenta, który czyta repozytorium, zanim napisze testy
Premiera / Narzędzie

Microsoft otwiera agenta, który czyta repozytorium, zanim napisze testy

4 min

Microsoft udostępnił na licencji MIT agenta code-testing-generator, który zanim napisze testy jednostkowe, przeszukuje repozytorium, wykrywa język i framework oraz ustala prawdziwe komendy budowania. Na wewnętrznym benchmarku ze 152 zadań zaliczył 140 wobec 120 Copilota na tym samym modelu, czyli o 63% mniej porażek. Cały zysk skupia się w ogólnikowych poleceniach typu „napisz testy”, gdzie liczba porażek spadła z 30 do 10; przy szczegółowych promptach oba wypadły tak samo. To nie przełom, tylko porządne rusztowanie automatyzujące nudne rozeznanie pomijane przy jednej linijce polecenia.

Trzy frameworki, które każą maszynie pisać własne prompty i skille
Premiera / Narzędzie

Trzy frameworki, które każą maszynie pisać własne prompty i skille

5 min

Trzy czerwcowe projekty open-source, GEPA, EvoSkill i Self-Harness, oddają maszynie to, co dotąd pisał inżynier: prompt, umiejętności agenta i reguły jego działania. Pętla ewolucyjna sama generuje warianty, ocenia je i zachowuje najlepsze, obiecując kilkudziesięcioprocentowy skok skuteczności bez dotykania wag modelu; GEPA podbił GPT-4.1 Mini na zadaniach AIME z 46,6% do 56,6% przy 100 do 500 prób zamiast tysięcy. Działa to jednak tylko tam, gdzie wynik da się tanio i jednoznacznie zmierzyć, więc nowa rola człowieka to napisać dobrą miarę, a nie cyzelować pojedyncze zdanie.