Premiera / Narzędzie
Trzy frameworki, które każą maszynie pisać własne prompty i skille
Trzy czerwcowe projekty open-source, GEPA, EvoSkill i Self-Harness, oddają maszynie to, co dotąd pisał inżynier: prompt, umiejętności agenta i reguły jego działania. Pętla ewolucyjna sama generuje warianty, ocenia je i zachowuje najlepsze, obiecując kilkudziesięcioprocentowy skok skuteczności bez dotykania wag modelu; GEPA podbił GPT-4.1 Mini na zadaniach AIME z 46,6% do 56,6% przy 100 do 500 prób zamiast tysięcy. Działa to jednak tylko tam, gdzie wynik da się tanio i jednoznacznie zmierzyć, więc nowa rola człowieka to napisać dobrą miarę, a nie cyzelować pojedyncze zdanie.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 5 min ·
Przez ostatni rok prompt do agenta poprawiał się tak samo, jak debuguje się każdy uparcie psujący się kod: patrzysz, gdzie pada, zmieniasz jedno zdanie w instrukcji, odpalasz jeszcze raz i masz nadzieję, że tym razem przejdzie. To robota na czucie, oparta na kilku zauważonych wpadkach. W czerwcu wyszły trzy projekty open-source, które tę robotę próbują oddać samej maszynie: GEPA, EvoSkill i Self-Harness. Każdy z nich bierze pętlę ewolucyjną, w której wariant się zmienia, dostaje ocenę i przeżywa albo ginie, i puszcza ją na to, co dotąd pisał człowiek: na prompt, na zestaw umiejętności agenta, na same reguły, według których agent działa. Wszystkie trzy obiecują kilkudziesięcioprocentowy skok skuteczności bez dotykania wag modelu. I wszystkie trzy działają naprawdę dobrze tylko tam, gdzie umiesz tanio i jednoznacznie zmierzyć, czy agent zrobił zadanie dobrze. Tam, gdzie tej miary nie ma, pętla nie ma czego optymalizować, i to jest linia, po której będę je oceniał.
Zacznę od GEPA, bo to on wyznacza wzorzec. Klasyczny optymalizator promptów wie, że dany wariant zawiódł, ale nie wie dlaczego, więc próbuje na ślepo kolejnych wersji. GEPA odwraca to: po każdej próbie zapisuje pełny ślad wykonania, czyli komunikaty błędów, logi rozumowania, wyjście profilera, a potem oddaje ten ślad drugiemu modelowi, żeby przeczytał go jak diagnosta i wprost opisał, co poszło nie tak. Dopiero z tej diagnozy powstaje nowa wersja promptu. Twórcy nazywają tę zwrotną informację z ewaluatora odpowiednikiem gradientu, tyle że zapisanym słowami zamiast liczbami, i to jest sedno pomysłu: model dostaje konkretny trop, na którym ma się poprawić, bo uczy się na zdaniu "zgubiłeś warunek z treści zadania", a nie na samym sygnale "źle". Wyniki, które GEPA pokazuje, robią wrażenie głównie dlatego, że dochodzi do nich za grosze: według dokumentacji projektu potrzebuje 100 do 500 prób tam, gdzie uczenie ze wzmocnieniem zżera ich od kilku do kilkudziesięciu tysięcy. Sam efekt też widać, bo na konkursowym zbiorze zadań matematycznych AIME GPT-4.1 Mini podbił z 46,6% do 56,6% bez tknięcia wag modelu. Tobi Lutke, prezes Shopify, napisał wprost, że GEPA jest "mocno niedoceniany" w świecie inżynierii kontekstu, a sam projekt chwali się ponad pięćdziesięcioma wdrożeniami produkcyjnymi.
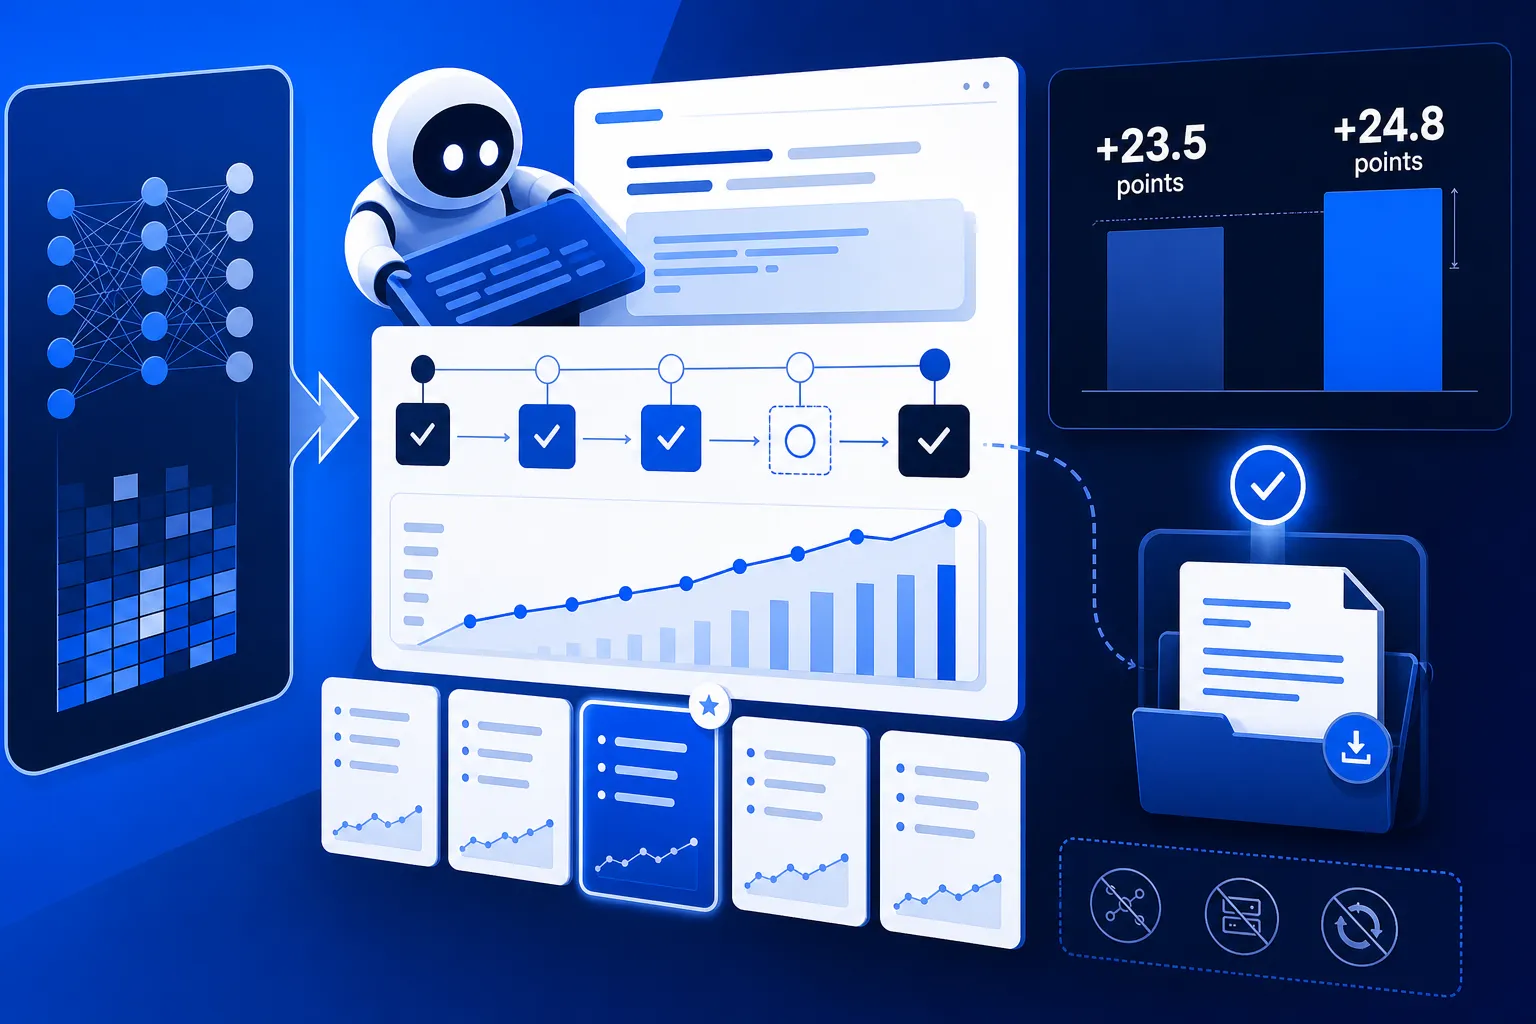
EvoSkill, zbudowany przez Sentient Labs, bierze ten sam mechanizm i rozciąga go z jednego promptu na całego agenta. Zamiast poprawiać jedną instrukcję w miejscu, proponuje naraz kilka nowych umiejętności i zmian w prompcie, sprawdza każdy wariant na odłożonych danych i z każdej iteracji robi osobny, kompletny program agenta. Najciekawszy jest sposób, w jaki je przechowuje: każdy wariant ląduje na własnym branchu gita, program/iter-skill-2 obok program/iter-skill-3, a do następnej rundy przechodzą tylko te najlepsze, których nie da się poprawić na jednym froncie bez psucia wyniku na innym. Człowiek patrzy w trakcie na żywą tabelkę, gdzie skuteczność rośnie z 42% do 51,3% i wariant dostaje gwiazdkę "nowy najlepszy" albo etykietę "odrzucony". Wypracowane umiejętności to zwykłe foldery z instrukcją i skryptami pomocniczymi, które wchodzą do Claude Code, Codex, Goose czy OpenHands. Pisałem w kwietniu o Agent Skills Addy'ego Osmaniego z Google'a, gdzie te foldery z procesami i z opisem typowych wpadek agenta pisał ręcznie żywy inżynier; EvoSkill to ta sama półka z umiejętnościami, tyle że zapełniana przez maszynę z analizy własnych porażek.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.