SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Mistral Large 4 do pobrania: bilion parametrów, osiem kart graficznych i tańsze API

29 października Mistral udostępnił na Hugging Face wagi modelu Large 4, który ma bilion parametrów, ale przy każdym tokenie używa około 52 miliardów. Wersja FP8 waży około 1,1 TB i wymaga serwera z ośmioma kartami graficznymi. W niezależnych testach model ustępuje chińskim GLM-5.3 i DeepSeek V4.1 Flash, za to zużywa o 47% mniej tokenów, a API potaniało mniej więcej o połowę. Dla większości zespołów będzie więc tanim API, a nie modelem na własny serwer.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  5 min  · 
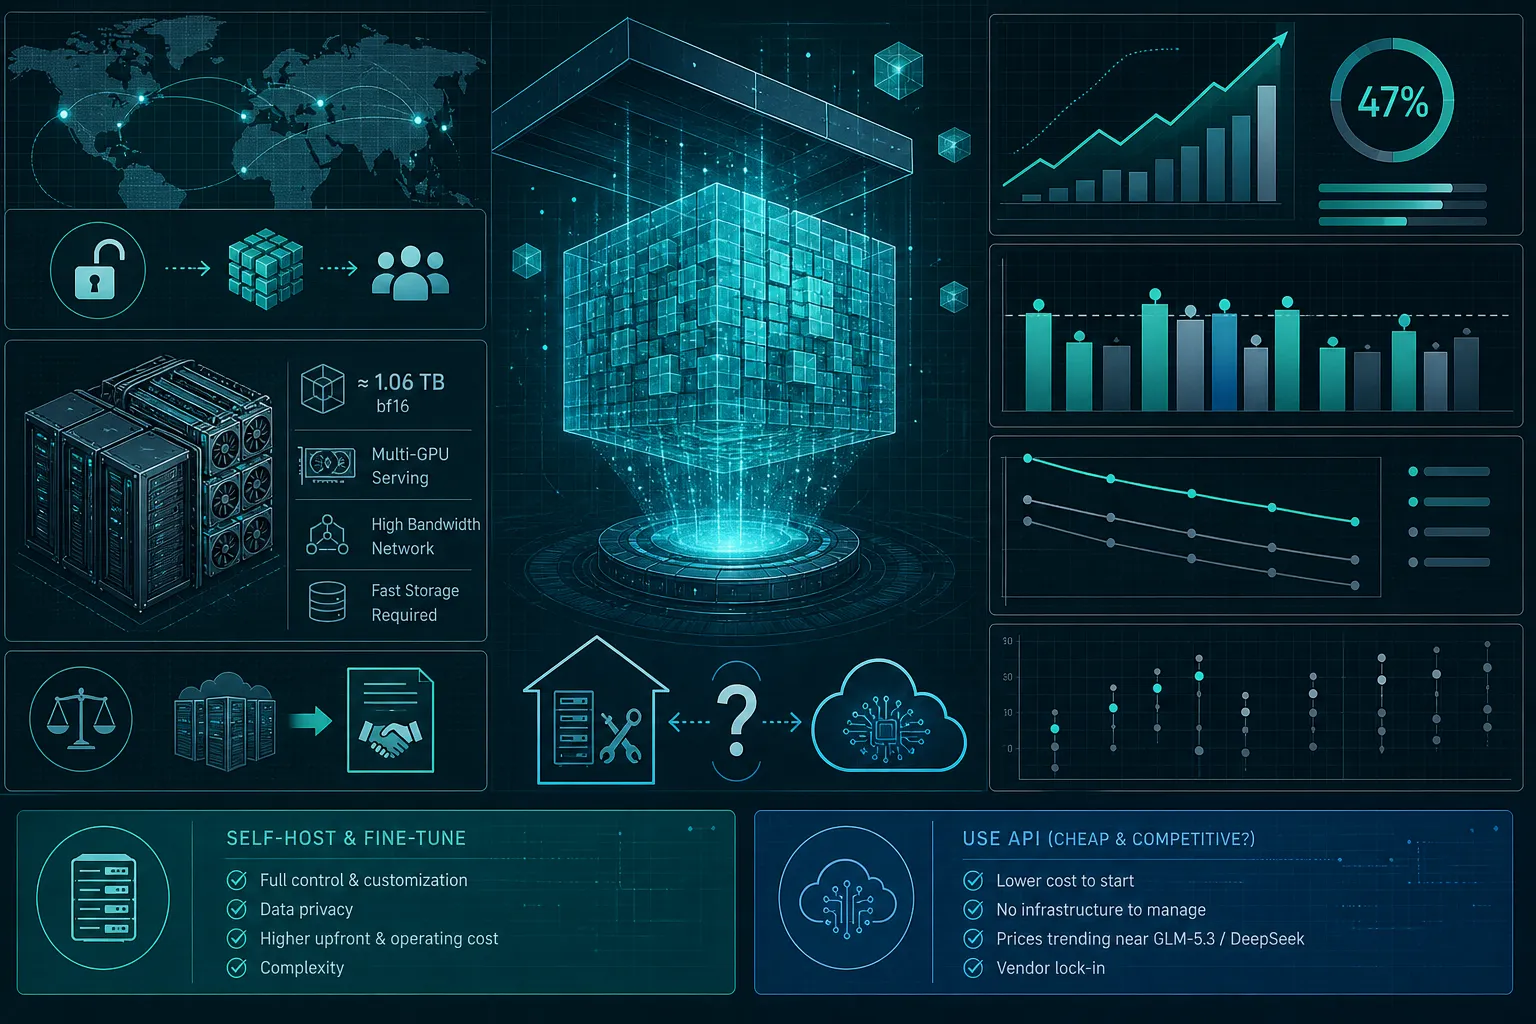
Mistral Large 4 do pobrania: bilion parametrów, osiem kart graficznych i tańsze API
Ilustrację przygotowała AI.

Przy podglądzie z 6 października Mistral zapowiadał, że udostępni wagi modelu Large 4 do pobrania, i dotrzymał słowa: 29 października trafiły one na Hugging Face, a razem z nimi licencja i nowy cennik API, według Artificial Analysis niższy mniej więcej o połowę. Gdy pisałem o podglądzie, model działał tylko przez API Mistrala, więc zostawiłem otwarte pytanie, czy opłaci się go stawiać na własnym serwerze, i radziłem odłożyć decyzję do dnia, w którym będzie można go pobrać i przeczytać warunki. Ten dzień przyszedł, a moja odpowiedź brzmi tak: dla większości zespołów Large 4 będzie tanim API, a nie modelem na własny serwer.

Bilion parametrów trzeba gdzieś zmieścić

Przy każdym tokenie Large 4 wybiera cztery ze 128 wyspecjalizowanych bloków, tak zwanych ekspertów, więc z biliona parametrów pracuje naraz około 52 miliardów (karta modelu). Obliczeń jest tyle, co w średnim modelu, ale w pamięci kart graficznych muszą leżeć wszystkie bloki. Wersja w formacie FP8, czyli z wagami zapisanymi w obniżonej precyzji, żeby zajmowały mniej pamięci, waży około 1,1 TB (Latent Space), a polecenie, którym Mistral każe uruchamiać model w bibliotece vLLM, rozkłada go na osiem kart w jednym serwerze. Firma sama dopisuje na karcie modelu, że jeśli lokalne uruchomienie działa słabo, lepiej skorzystać z jej API.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Mistral Large 4: otwarty model, którego jeszcze nie da się pobrać
Model / Badania

Mistral Large 4: otwarty model, którego jeszcze nie da się pobrać

4 min

Mistral 6 października udostępnił podgląd modelu Large 4, który reklamuje jako najlepszy otwarty model na świecie, choć wagi mają trafić do pobrania dopiero do końca miesiąca, więc na razie działa wyłącznie przez API. Model ma bilion parametrów, z których przy każdym tokenie pracuje 52 miliardy, a w teście DeepSWE osiąga 61,7%, czyli mniej niż chiński GLM 5.3 z wynikiem 66,9%. Prowadzi za to w teście bezpieczeństwa CyberGym-E2E, w którym zamknięte modele odmawiają pracy, dlatego decyzję o budowaniu na nim odłożyłbym do dnia, w którym wagi i licencja będą naprawdę dostępne.

Tencent wypuszcza Hy4 preview na Apache 2.0 i sam sobie wystawia ocenę
Model / Badania

Tencent wypuszcza Hy4 preview na Apache 2.0 i sam sobie wystawia ocenę

4 min

Tencent wystawił wagi Hy4 preview na Hugging Face na licencji Apache 2.0: 770 miliardów parametrów, z czego przy jednym tokenie pracuje tylko 49 miliardów, co tnie koszt liczenia, ale nie zapotrzebowanie na pamięć, bo nawet po kwantyzacji do FP8 model rozkłada się na osiem kart. Jedyne porównanie z konkurencją to własny test w ciemno, w którym 163 wewnętrznych ekspertów dało Hy4 średnią 2,99 wobec 2,92 dla GLM 5.3, przy nieujawnionej skali i pełnych benchmarkach doklejonych jako obrazek JPG. Sam producent przyznaje przy tym, że model rozmyśla nad zadaniem dłużej, niż trzeba.

Model bezpieczeństwa Mistrala dorównuje rywalom prawie siedem razy większym
Model / Badania

Model bezpieczeństwa Mistrala dorównuje rywalom prawie siedem razy większym

3 min

Mistral wypuścił Shieldstral, model do moderacji treści o 3 miliardach parametrów, który mieści się w 16 GB pamięci karty i działa na jednym GPU na licencji Apache 2.0. Kryterium filtrowania podaje się jako zwykłe pytanie po angielsku, więc politykę zmienia się jednym zdaniem, bez trenowania od nowa. Według raportu samego producenta dostał 99,4% na HarmBench, przed 94,5% dwudziestomiliardowego GPT-OSS-Safeguard, będąc prawie siedem razy mniejszym od rywali. Przy wejściu spreparowanym pod obejście filtra skuteczność jednak spada.