Premiera / Narzędzie
Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki
Tejas Chopra prosił Claude'a o wskazanie awarii w logach, a jedno pytanie zjadło dwa okna kontekstowe i 287 dolarów miesięcznie, bo model raz za razem czytał całe logi, by wyłuskać trzy istotne linijki. Tak powstał Headroom, otwarta warstwa przycinająca kontekst, zanim ten doleci do modelu: wycina zbędne znaki z JSON-a (około 30% oszczędności), a oryginał chowa lokalnie na wypadek, gdyby model potrzebował pełnych danych. Chopra reklamuje 700 tysięcy dolarów oszczędności w pięć miesięcy, ale mocniejsza jest sama diagnoza: większość tego, czym karmimy modele, jest zbędna, a płacimy za wszystko.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
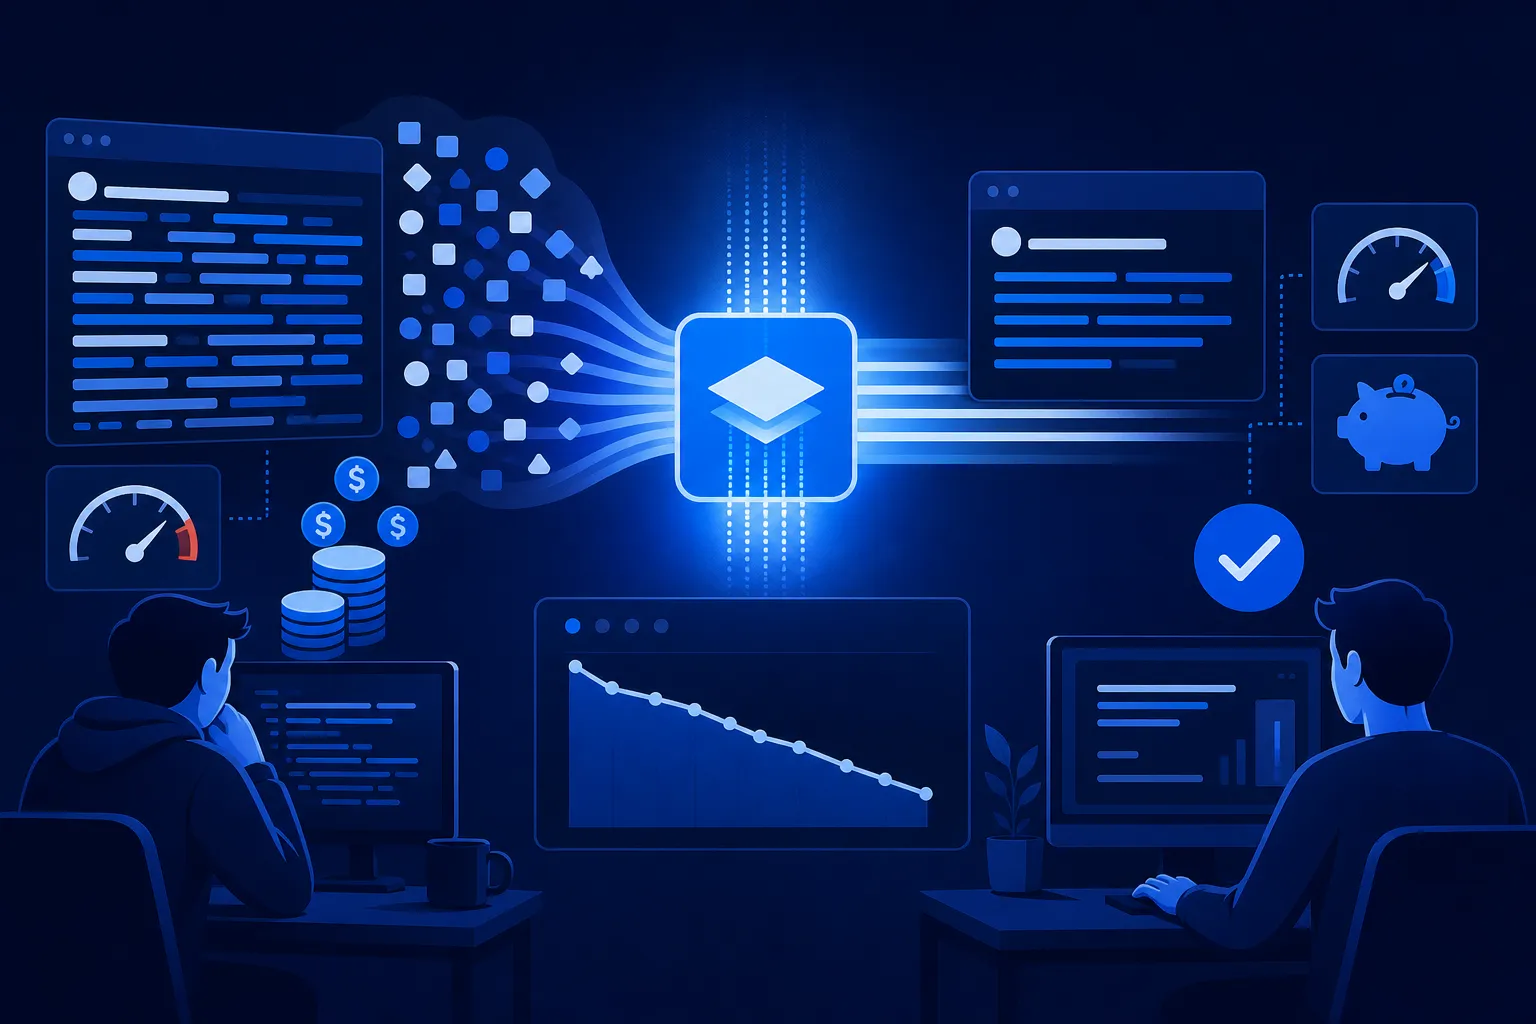
Tejas Chopra debugował awarię karty graficznej. Rutyna dla starszego inżyniera: ściągasz logi, prosisz Claude'a o wskazanie problemu i wracasz do swoich rzeczy. Odpowiedź wróciła poprawna, ale coś się nie zgadzało. To jedno pytanie zjadło dwa pełne okna kontekstowe modelu. Model wczytał plik z logami wielokrotnie, przemielił wszystko i dopiero z tego wyłuskał trzy linijki, które naprawdę coś znaczyły. Kiedy Chopra podliczył miesiąc, za sam prywatny projekt zobaczył na rachunku 287 dolarów.
Poprawka była prosta: przepisał prompt tak, żeby model pomijał linie INFO i patrzył tylko na ostrzeżenia. Koszt spadł, odpowiedź przyśpieszyła. Jedno nie dawało mu jednak spokoju. "Nie można oczekiwać, że każdy programista otworzy okno kontekstowe i wyczyści prompt dokładnie pod to, czego akurat szuka", mówi w rozmowie z LeadDev, serwisem dla inżynierów. "Ludzie, albo modele, na ślepo powiedzą: muszę zajrzeć do logów, więc łapię całe logi." Skoro człowiek tego nie dopilnuje, może dopilnuje maszyna.
Tak powstał Headroom, otwarta warstwa, która siada między twoim narzędziem a modelem i przycina kontekst, zanim ten do modelu doleci. Nawyk, na który odpowiada, bywa nazywany zrzucaniem kontekstu: wrzucaniem w okno kontekstowe całych baz kodu, schematów bazy i długich logów, bo model to udźwignie, a tak jest wygodniej niż zastanawiać się, co jest naprawdę potrzebne. Płacisz przy tym za każdy token, także za te, które model przeczyta i zignoruje. Odwrotny nawyk to higiena tokenów (Chopra mówi o "byciu tokenwise"): pilnowanie, ile kontekstu zadanie faktycznie wymaga, a nie ile pochłania.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.