SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Pliki wyszukuje model, którego nie ma nawet na liście wyboru

Freebuff od CodebuffAI rozbija agenta w terminalu na role: pliki w repozytorium wyszukuje tani Gemini 3.1 Flash Lite, którego nie ma nawet na liście wyboru, a dopiero to, co znajdzie, trafia do modelu piszącego zmiany. Pakiet pięciu narzędzi nie kosztuje nic, bo za dostęp do modeli płacą reklamy, a README wprost przyznaje, że służy do tego treść promptów, i nie podaje ani jednej liczby o jakości. Poza wybranymi regionami zostają dwa modele i trzy sesje na dobę, za to całą orkiestrację napędza otwarty Codebuff, więc ten sam podział ról da się złożyć u siebie, bez reklam.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Pliki wyszukuje model, którego nie ma nawet na liście wyboru
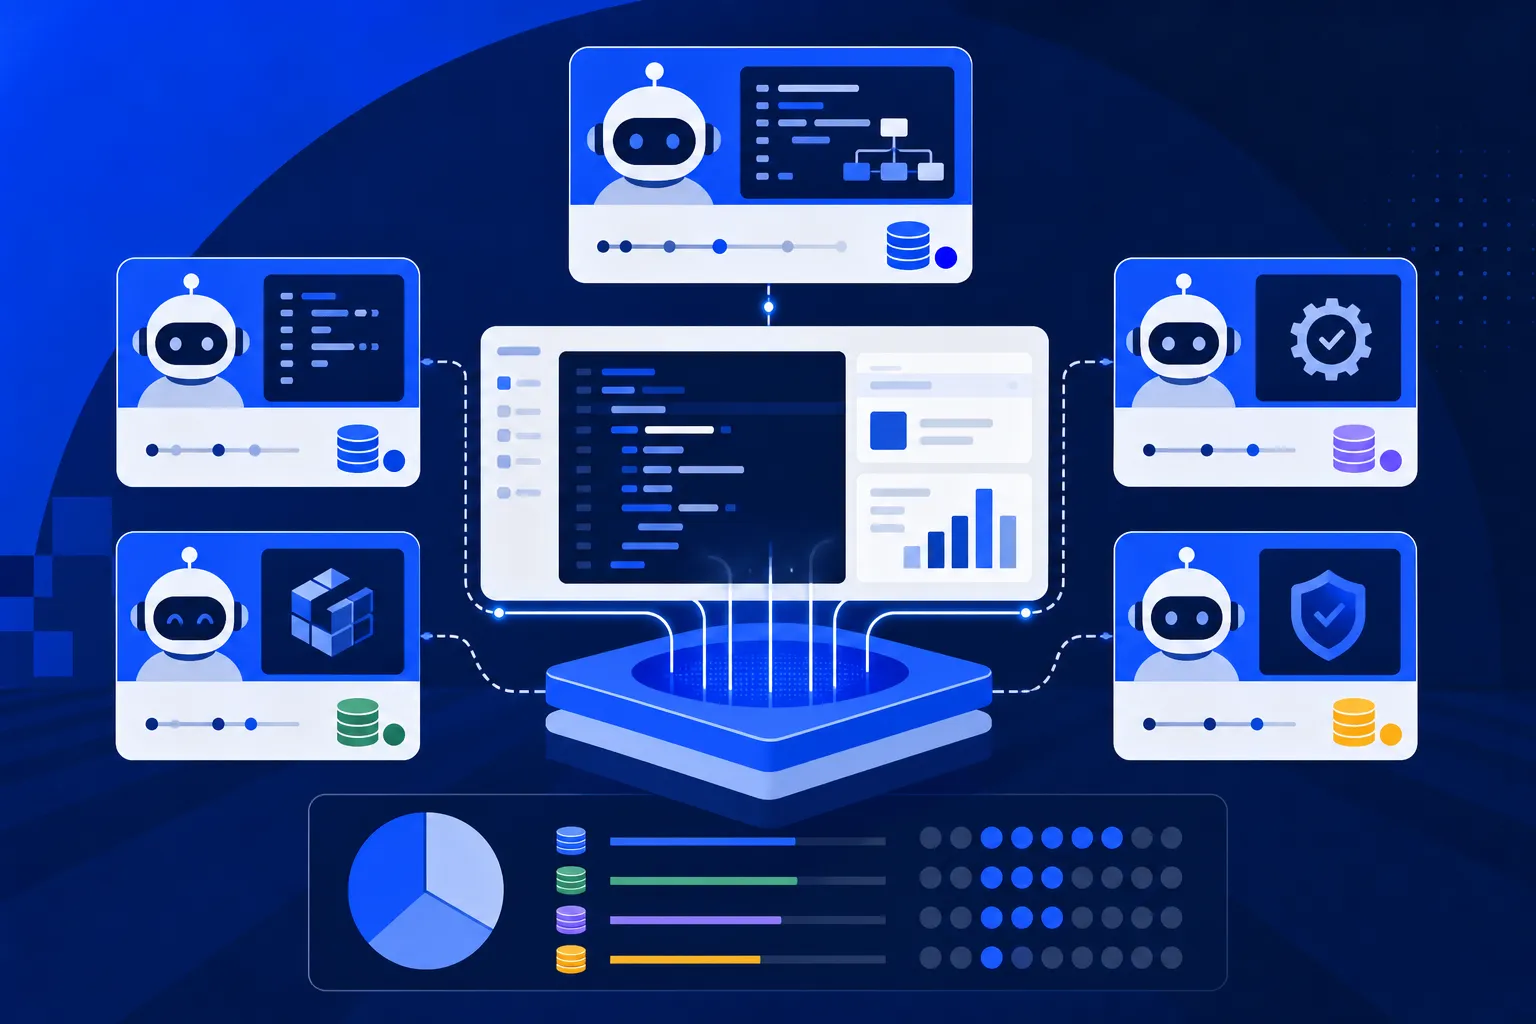
Ilustrację przygotowała AI.

Wpisujesz w terminalu, co ma się zmienić w projekcie, i zanim duży model w ogóle dotknie kodu, po repozytorium biega mały, tani model z jednym zadaniem: znaleźć pliki, o które chodzi. Tak właśnie działa Freebuff, gdzie tę robotę odwala Gemini 3.1 Flash Lite, model, którego nie ma nawet na liście wyboru dla użytkownika, bo nie jest od rozmowy, tylko od czarnej roboty. Dopiero to, co znajdzie, trafia do modelu, który naprawdę pisze zmiany.

Typowy agent w terminalu działa inaczej. Jeden model, jeden prompt, jedna pętla, w której ta sama, najdroższa maszyna przeszukuje repozytorium, planuje, edytuje pliki i na koniec sama sobie sprawdza robotę. CodebuffAI rozbiło tę pętlę na role i wypuściło efekt jako Freebuff, pakiet pięciu darmowych narzędzi do programowania, bez abonamentu, bez kredytów i bez własnego klucza API. Za dostęp do modeli płacą reklamy tekstowe, tyle że najtrwalsza wydaje mi się tu nie darmowość, tylko właśnie ten podział ról.

Podział roboty zamiast jednego modelu do wszystkiego

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Meta oddaje 30-miliardowego agenta za darmo, jeśli masz na czym go uruchomić
Model / Badania

Meta oddaje 30-miliardowego agenta za darmo, jeśli masz na czym go uruchomić

5 min

Meta wypuściła 10 sierpnia Muse Glimmer, agentowy model o 30 miliardach parametrów, i oddała jego wagi za darmo na licencji Apache 2.0, dzięki czemu autonomiczny agent może planować zadania, wywoływać narzędzia i pisać kod lokalnie, bez opłat za API. Darmowy jest jednak tylko model, bo po kwantyzacji do 4 bitów potrzebuje maszyny z 24 do 32 GB pamięci, na przykład RTX 4090 albo MacBooka Pro z M4 Max. Na testach agentowych prowadzi, 51,2 na SWE-Bench Pro wobec 36,9 Gemmy i 50,2 Qwena, ale w terminalu przegrywa z Qwenem, a wszystkie liczby pochodzą od samej Mety.

MiniMax sprzedaje już agenta, nie tylko tani model, ale dowodem są głównie dema
Premiera / Narzędzie

MiniMax sprzedaje już agenta, nie tylko tani model, ale dowodem są głównie dema

3 min

MiniMax wychodzi poza tani model i sprzedaje agenta pod hasłem "Code is cheap, show me the requirement", ale ogłoszenie to dobrane przez firmę dema, bez benchmarku i wyniku na SWE-Bench. Dla programisty konkretem jest natywna integracja z MCP, dzięki której agent sam sięga do GitHuba, GitLaba, Slacka czy Figmy zamiast ręcznego wklejania. Sam żongluje kilkoma modelami naraz, co, jak przyznaje firma, kosztuje i obniża wydajność, więc hasło o tanim kodzie na razie się nie broni. Jedyny twardy sygnał to fakt, że po niecałych 60 dniach stał się codziennym narzędziem ponad połowy zespołu MiniMaxa.

Ta sama para modeli, trzy różne rachunki za jedno zadanie
Model / Badania

Ta sama para modeli, trzy różne rachunki za jedno zadanie

5 min

Artificial Analysis wylicza, że średnie zadanie agentowe kosztuje 3,26 dolara na GPT-6 Astra i 7,63 na Claude Fable 5.1 przy identycznej skuteczności, ale OpenAI i Cognition zmierzyły tę samą różnicę na 63% i 42%, a Zvi Mowshowitz wskazuje, że Fable puszczono w trybie Max, co te 57% zawyża. Cognition odpowiada układem Fusion w Devinie, w którym droższy model prowadzi, a tańszy grzebie w kodzie: na DeepSWE 1.1 ścina to koszt zadania o 46% bez straty jakości, tyle że z Astrą na Terminal-Bench 4.0 wynik leci w dół o ponad pięć punktów. Cenę za zadanie widać dopiero na własnym repozytorium.