SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Najtańsza oszczędność pamięci to jedna liczba w konfiguracji

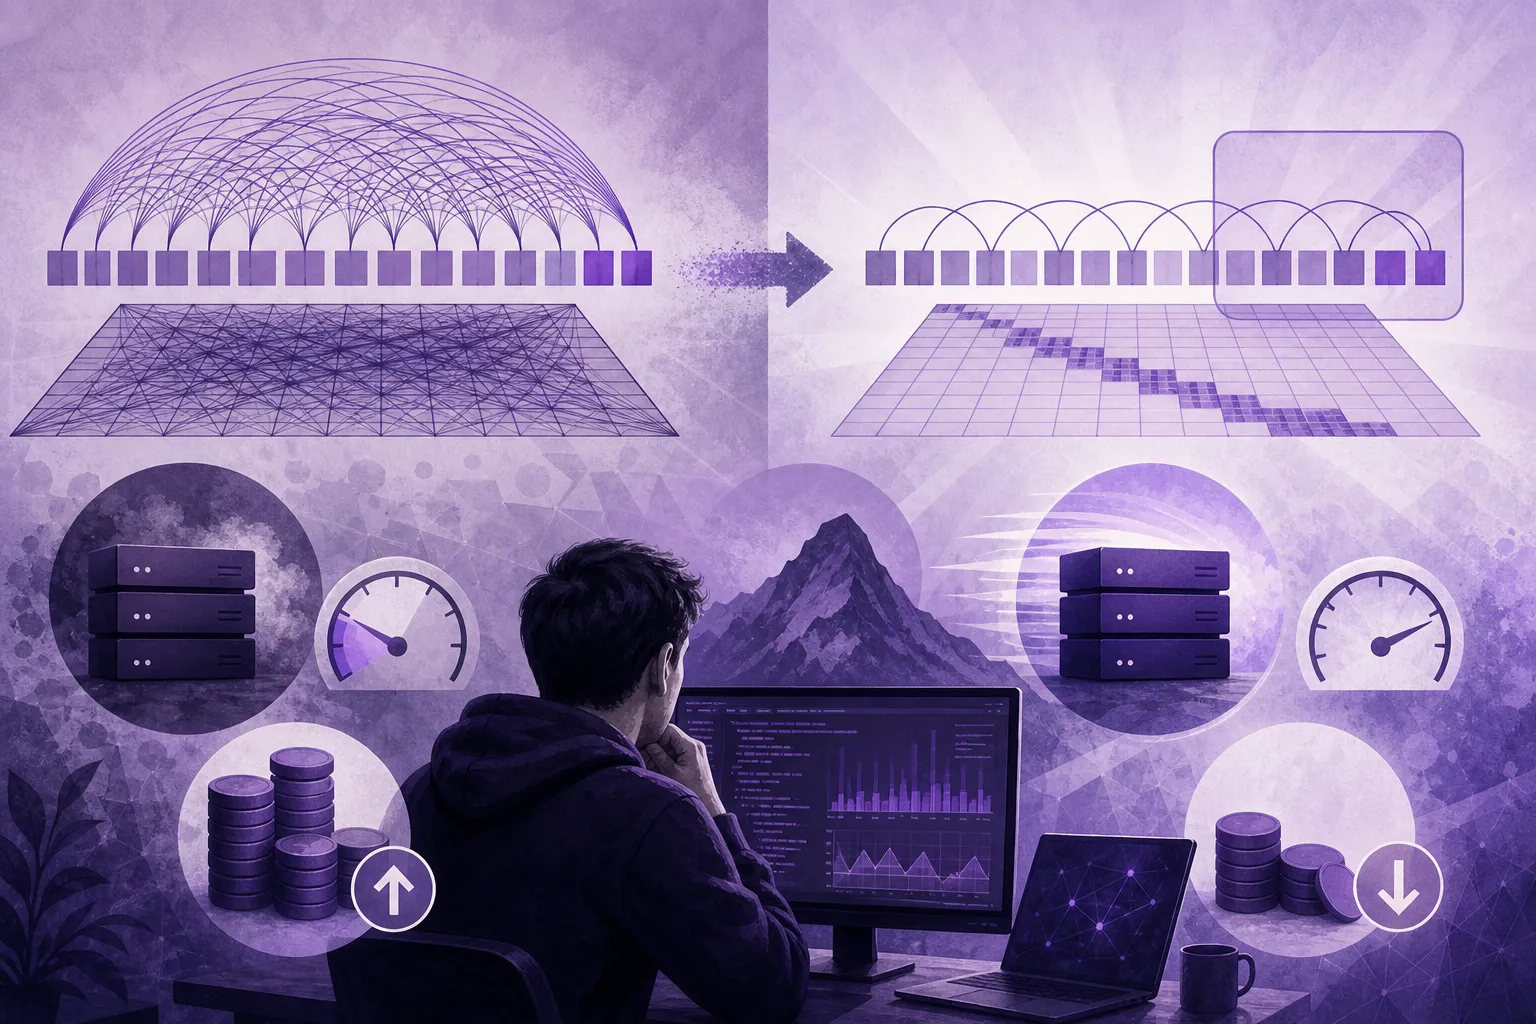
Alexia Jolicoeur-Martineau opublikowała 28 sierpnia na arXiv pracę, która modzie na liniową uwagę stawia zarzut proceduralny: nikt nie porównał jej z prostszą bazą, czyli uwagą z przesuwnym oknem. Na testach czytania długich dokumentów, Needle-in-a-Haystack i BABILong, przesuwne okno wypada od dwóch do dziesięciu razy lepiej niż model dotrenowany do liniowej uwagi, a kosztuje jedną liczbę w konfiguracji zamiast dni pracy kart. To wciąż preprint bez recenzji, a przycięcie kontekstu zabiera dokładnie tę zdolność, za którą płacisz, jeśli zadanie wymaga całego dokumentu.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
Najtańsza oszczędność pamięci to jedna liczba w konfiguracji
Ilustrację przygotowała AI.

Każdy kolejny token w rozmowie z modelem kosztuje więcej niż poprzedni. Model przechowuje przeliczoną postać każdego tokena, który już zobaczył, żeby przy kolejnym słowie nie liczyć całej rozmowy od nowa, i ta sterta rośnie z każdym zdaniem aż do końca sesji, więc rachunek za pamięć rośnie szybciej niż sama rozmowa. Kto trzyma model na własnej karcie, ten zna ten rachunek: klucze i wartości zostają w pamięci na stałe, przez całą sesję.

Od dawna szuka się sposobu, żeby ten koszt obejść bez trenowania czegokolwiek od zera, i najgłośniejszą propozycją jest liniowa uwaga. Bierzesz gotowy model, dotrenowujesz go tak, żeby nie pamiętał każdego tokena z osobna, tylko ściskał całą historię do stanu o stałym rozmiarze, dzięki czemu koszt przestaje rosnąć razem z kontekstem. Obietnica jest kusząca: te same wyniki za ułamek pamięci, po dotrenowaniu gotowego modelu zamiast pełnego trenowania od zera. Nie kupuję jej. I nie dlatego, że liniowa uwaga źle działa, tylko dlatego, że nikt nie sprawdził, czy w ogóle jest po co ją dotrenowywać.

Punkt odniesienia, z którym nikt się nie porównał

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Praca z arXiv obiecuje tańszą pamięć agentów bez spadku dokładności
Analiza / Opinia

Praca z arXiv obiecuje tańszą pamięć agentów bez spadku dokładności

4 min

Nowa praca na arXiv, zgłoszona 23 lipca przez Gaurava Dadhicha z zespołu Maximem AI, przekonuje, że produkcyjne agenty zawodzą nie przez słabe rozumowanie, lecz przez brak panowania nad kontekstem: historią rozmowy, rozdętymi promptami i wynikami narzędzi. Najcenniejsza jest tu diagnoza kosztu: naiwne doklejanie historii rośnie kwadratowo, streszczanie na skróty tnie liniowo, ale ma swoje urwisko dokładności, a rozsądnym wyjściem jest kompresja z walidacją. Wyniki 92% na LongMemEval i 93,2% na LoCoMo firma zmierzyła jednak sama, na własnym produkcie Maximem Synap i bez punktu odniesienia.

Najdroższy model potrzebny tylko do planu, resztę zrobi tańszy
Premiera / Narzędzie

Najdroższy model potrzebny tylko do planu, resztę zrobi tańszy

3 min

Cursor dał rojowi agentów 835 stron dokumentacji SQLite i kazał odtworzyć bazę w Rust bez kodu źródłowego, a efekt przeszedł 100% ukrytych testów. Prawdziwy wniosek leży jednak w rachunku: przy niemal identycznej jakości koszt rozjechał się od 1339 dolarów, gdy planował Opus 4.8, a wykonywał tani Composer 2.5, po 10 565 dolarów za GPT-5.5 grający obie role naraz. Sztuczka polega na tym, że najdroższy model tylko rozbija cel na jednoznaczne instrukcje, a tańszy je wykonuje, bo naprawdę mało momentów w dużym zadaniu wymaga najkosztowniejszej inteligencji.

Po co model ponad trzy razy większy, skoro mniejszy programuje lepiej?
Model / Badania

Po co model ponad trzy razy większy, skoro mniejszy programuje lepiej?

3 min

Thinking Machines Lab wypuściło Inkling-Small, model z otwartymi wagami, który przy każdym tokenie uruchamia tylko 12 miliardów z 276 miliardów parametrów, a mimo to dorównuje ponad trzy razy większemu Inklingowi i wyprzedza go na kodzie, 80,2% wobec 77,6% na SWEBench Verified. Przewagę dało nie skalowanie, tylko dwa dodatkowe tygodnie treningu pod agentowe programowanie. Cena jest jedna: na wiedzy o świecie mniejszy model wyraźnie odstaje, 20,6% do 43,9% na SimpleQA. Mniej aktywnych parametrów oznacza też niższy rachunek za każdą odpowiedź.