SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Praca z arXiv obiecuje tańszą pamięć agentów bez spadku dokładności

Nowa praca na arXiv, zgłoszona 23 lipca przez Gaurava Dadhicha z zespołu Maximem AI, przekonuje, że produkcyjne agenty zawodzą nie przez słabe rozumowanie, lecz przez brak panowania nad kontekstem: historią rozmowy, rozdętymi promptami i wynikami narzędzi. Najcenniejsza jest tu diagnoza kosztu: naiwne doklejanie historii rośnie kwadratowo, streszczanie na skróty tnie liniowo, ale ma swoje urwisko dokładności, a rozsądnym wyjściem jest kompresja z walidacją. Wyniki 92% na LongMemEval i 93,2% na LoCoMo firma zmierzyła jednak sama, na własnym produkcie Maximem Synap i bez punktu odniesienia.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
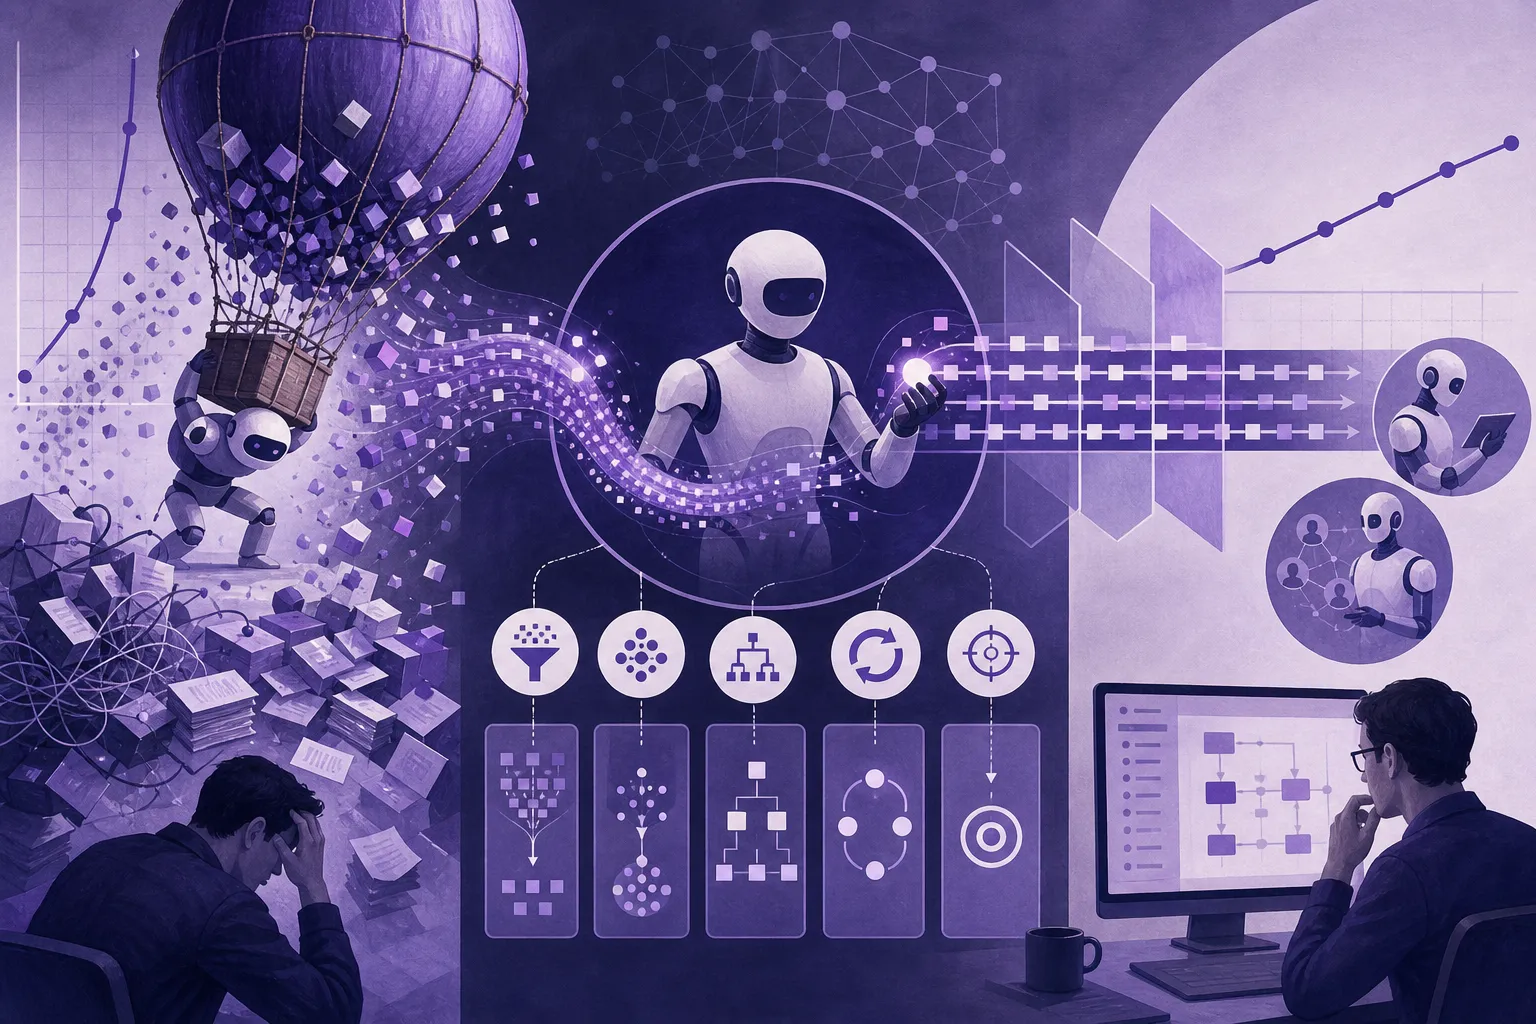
Praca z arXiv obiecuje tańszą pamięć agentów bez spadku dokładności
Ilustrację przygotowała AI.

Agent, który pracuje dłużej niż kilka minut, wpada zwykle w tę samą pułapkę. Z każdą turą dokłada do kontekstu kolejny kawałek rozmowy, wynik wywołanego narzędzia potrafi wrócić jako wielki blok tekstu i zostać tam już na stałe, a całą tę rosnącą stertę agent wysyła do modelu od nowa, płacąc za każdy token jeszcze raz. Mimo to gubi coś, co sam ustalił dziesięć kroków wcześniej. Im dłużej działa, tym jest droższy i tym bardziej roztargniony.

Nowa praca na arXiv, zgłoszona 23 lipca przez Gaurava Dadhicha z zespołu Maximem AI, stawia tezę, że produkcyjne agenty zawodzą nie dlatego, że kiepsko rozumują, tylko dlatego, że nie panują nad tym, co mają akurat w głowie: historią rozmowy, rozdętymi promptami, definicjami narzędzi i puchnącymi wynikami tych narzędzi. Dominujące podejście traktuje to jak problem magazynowania i wyszukiwania, czyli gdzieś zapisać i w porę wyciągnąć. Autorzy uważają, że to za wąsko, bo panowanie nad pamięcią agenta jest procesem o wielu etapach, a nie tylko szufladą, z której się coś wyjmuje.

Rachunek, który rośnie kwadratowo

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Najtańsza oszczędność pamięci to jedna liczba w konfiguracji Analiza / Opinia

Najtańsza oszczędność pamięci to jedna liczba w konfiguracji

4 min

Alexia Jolicoeur-Martineau opublikowała 28 sierpnia na arXiv pracę, która modzie na liniową uwagę stawia zarzut proceduralny: nikt nie porównał jej z prostszą bazą, czyli uwagą z przesuwnym oknem. Na testach czytania długich dokumentów, Needle-in-a-Haystack i BABILong, przesuwne okno wypada od dwóch do dziesięciu razy lepiej niż model dotrenowany do liniowej uwagi, a kosztuje jedną liczbę w konfiguracji zamiast dni pracy kart. To wciąż preprint bez recenzji, a przycięcie kontekstu zabiera dokładnie tę zdolność, za którą płacisz, jeśli zadanie wymaga całego dokumentu.

Ponad 20% drożej i ani jednego zadania więcej Analiza / Opinia

Ponad 20% drożej i ani jednego zadania więcej

3 min

Zespół z laboratorium SRI na ETH w Zurychu sprawdził, czy pliki kontekstowe w repozytorium, jak AGENTS.md, realnie pomagają agentom do programowania, i wyszło, że nie: skuteczność mierzona odsetkiem ukończonych zadań ani drgnęła, a rachunek za pracę agenta urósł o ponad 20%. Wynik trzyma się także wtedy, gdy kontekst pisali ręcznie sami deweloperzy, nie tylko model. Pliki zmieniają zachowanie agenta: więcej testuje i dokładniej przegląda repozytorium, co spala tokeny, ale nie zamyka więcej zgłoszeń. Autorzy nie każą wyrzucać AGENTS.md, tylko skrócić go do rzeczy, których agent sam nie zgadnie.

Agent Memory rusza w prywatnej becie: pięć poleceń dla modelu zamiast surowego SQL-a Premiera / Narzędzie

Agent Memory rusza w prywatnej becie: pięć poleceń dla modelu zamiast surowego SQL-a

4 min

Cloudflare 17 kwietnia wpuścił do prywatnej bety Agent Memory, usługę ratującą pamięć agenta w momencie, gdy okno kontekstowe się zapełnia i harness ucina historię. Zamiast surowego dostępu do bazy wektorowej model dostaje pięć operacji, w tym `recall`, który pod spodem odpala pięć równoległych kanałów wyszukiwania i zwraca gotowe zdanie syntezy. Czarną robotę robi tańszy Llama 4 Scout, większy Nemotron 3 wchodzi tylko do finalnej syntezy. Pamięć jako wąska usługa, nie baza do obsługi przez model, ma sens, choć porównania z własnym Postgresem z embeddingami jeszcze nie ma.