SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Model / Badania

Needle sprowadza wybór funkcji z chmury na urządzenie

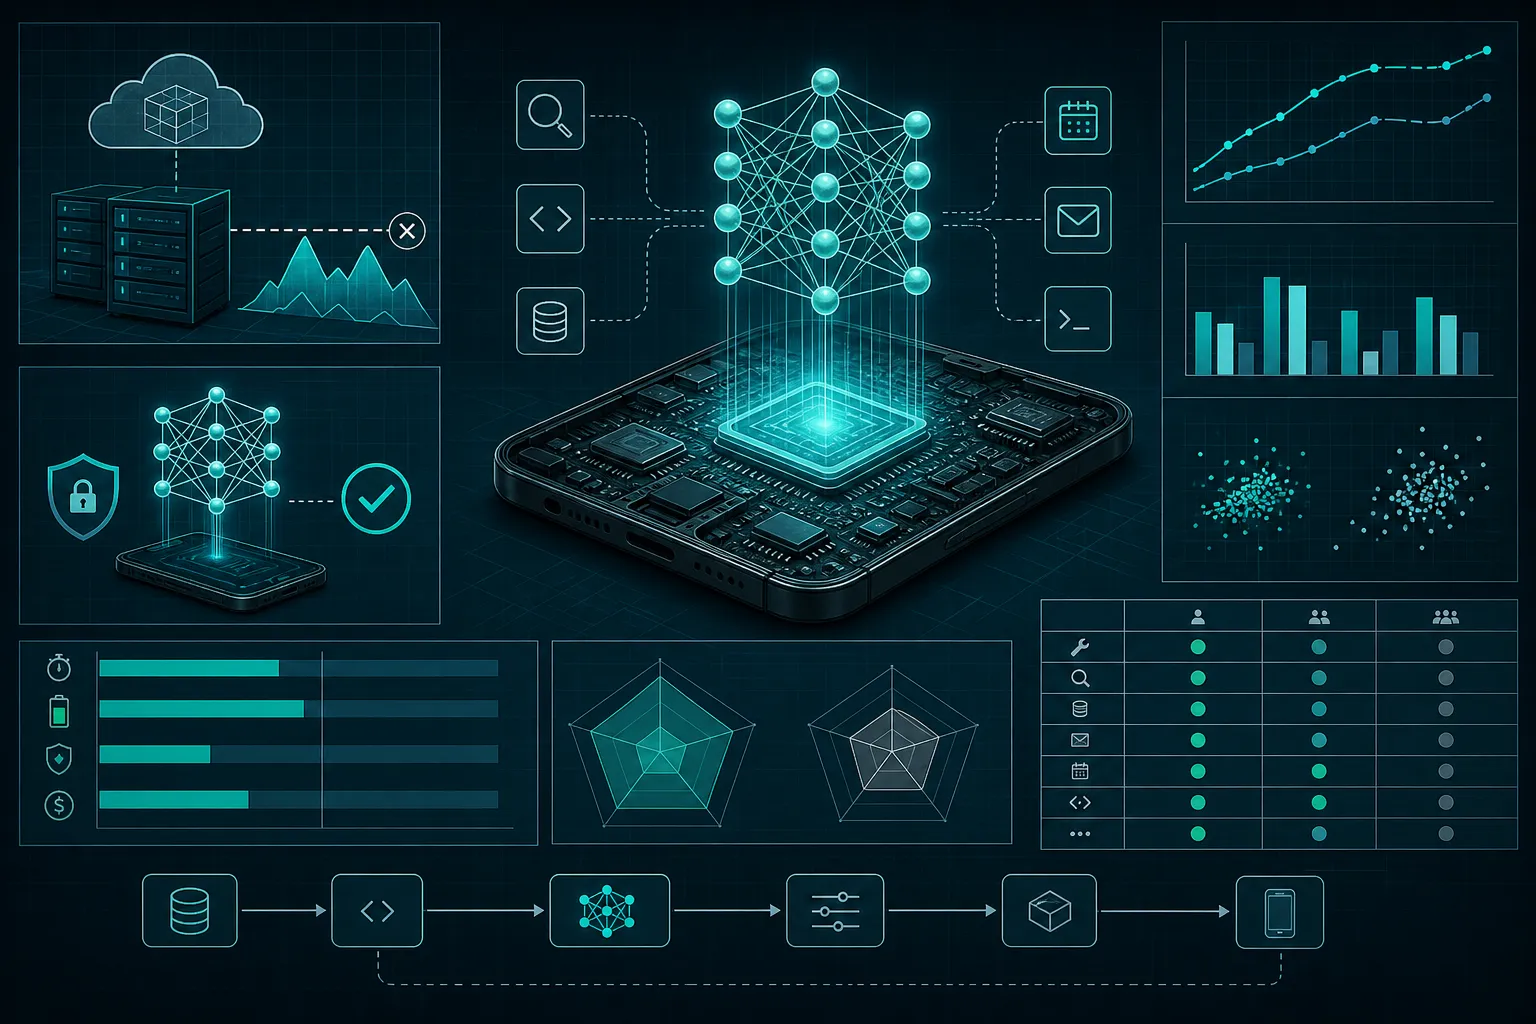
Cactus-Compute wypuściło Needle, model z otwartymi wagami, który robi na urządzeniu jedno: z pytania użytkownika i listy funkcji wybiera, którą wywołać i z jakimi argumentami. Powstał przez destylację Gemini 3.1 do zaledwie 26 milionów parametrów, na architekturze enkoder-dekoder bez warstw feed-forward, dzięki czemu decyzja o wyborze narzędzia zostaje na telefonie i nic nie trafia do chmury. Karta modelu daje pełną przejrzystość i licencję MIT, ale ani jednej liczby o skuteczności, więc trafność sprawdzisz sam na własnym zestawie funkcji, dotrenowując model w 45 minut.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Model / Badania  ·  3 min  · 
Needle sprowadza wybór funkcji z chmury na urządzenie
Ilustrację przygotowała AI.

Zadajesz modelowi pytanie "Jaka jest pogoda w San Francisco?", podajesz mu listę funkcji, którymi aplikacja dysponuje, a w odpowiedzi dostajesz jedną linijkę: wywołaj get_weather z argumentem San Francisco. Na tym kończy się cała robota Needle, modelu, który Cactus-Compute wypuścił w tym tygodniu z otwartymi wagami. Nie prowadzi rozmowy, nie pisze kodu, nie streszcza artykułów. Decyduje, którą funkcję z twojego zestawu odpalić i z jakimi parametrami, a potem robi to bezpośrednio na urządzeniu, w 26 milionach parametrów.

Zwykle o tym, którą funkcję wywołać, decyduje duży model przez API. Pytanie użytkownika leci do chmury, wraca wybór narzędzia, płacisz za każde takie wywołanie, a dane za każdym razem opuszczają urządzenie. Tańsza alternatywa to garść ręcznie pisanych reguł na słowa kluczowe, która sypie się przy pierwszym pytaniu sformułowanym inaczej, niż przewidział autor. Needle przenosi tę jedną decyzję z powrotem na telefon albo laptopa i to jest cały pomysł na ten model.

Cactus wziął dużego Gemini 3.1 i przepisał jego wiedzę do znacznie mniejszego modelu, w procesie zwanym destylacją. Autorzy nazwali architekturę Simple Attention Network: enkoder-dekoder bez warstw feed-forward. W typowym modelu językowym to właśnie na te warstwy przypada większość wag, bo one przetwarzają każdy token z osobna. Cactus wyciął je w całości i zostawił sam mechanizm uwagi, ten, który zestawia słowa zapytania ze sobą. Stąd 26 milionów parametrów zamiast miliardów. To agresywne cięcie i zaraz wrócę do tego, co się za nie płaci.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Liquid AI LFM2.5-24B-A2B: lokalny agent na laptopie, ale nie do naprawiania kodu
Model / Badania

Liquid AI LFM2.5-24B-A2B: lokalny agent na laptopie, ale nie do naprawiania kodu

5 min

LFM2.5-24B-A2B od Liquid AI ma 24 miliardy parametrów, ale przy każdym tokenie pracuje niecałe 2,5 miliarda, dzięki czemu na Apple M5 Max generuje 184 tokeny na sekundę i działa jako agent bez chmury. W teście LiveClaw pokonał Qwen3.6-35B-A3B wynikiem 48,09 do 38,19, bo trenowano go wprost w harnessach takich jak OpenCode i Hermes Agent. Przy naprawianiu prawdziwego kodu wyraźnie jednak odpada: na SWE-Bench Verified rozwiązuje 51 procent zgłoszeń wobec 66,2 u Qwena, więc nadaje się do lokalnych pętli z narzędziami, a nie do pracy w dużym repozytorium.

Lokalny agent do kodu, który celowo mniej myśli
Model / Badania

Lokalny agent do kodu, który celowo mniej myśli

3 min

Jackrong wypuścił Qwopus-3.6-35B-A3B-Coder, model do kodu oparty na Qwen3.6, w którym rozumowanie jest domyślnie wyłączone. To mieszanka ekspertów z 35 miliardami wag, z których przy każdym tokenie pracuje tylko około 3 miliardów, więc działa lokalnie i zebrał 45 tysięcy pobrań miesięcznie. Autorzy chwalą się wynikiem 62,4% na SWE-bench, ale to przebieg policzony przez sam zespół na 300 zadaniach, bez potwierdzenia. Bez rozumowania model pewniej trzyma się poleceń i stabilniej ciągnie stan przez tury, za to w kompetencji inżynierskiej przegrywa z rywalem tej samej wielkości, 81 do 94.

Karta modelu nie powie wam, co się stanie na telefonie
Premiera / Narzędzie

Karta modelu nie powie wam, co się stanie na telefonie

4 min

Liquid AI wypuściło Pipette, otwartą platformę mierzącą modele na telefonach, a nie na serwerowych kartach graficznych: ponad tysiąc pomiarów dla 30 modeli, między innymi na iPhonie 17 Pro i Galaxy S26 Ultra. Artificial Analysis zweryfikowało metodykę i pokazało rachunek za ten sam wynik: Nanbeige4.2-3B i LFM2.5-2.6B remisują na 63 punktach, tylko że pierwszy odpowiada w 21 sekund, a drugi w 8. Gdy każda odpowiedź dostaje minutę na iPhonie, Nanbeige spada do 18 punktów, a wygrywa LFM2.5-8B-A1B. Zestaw modeli dobierało jednak samo Liquid AI, więc czytam tę tablicę z zastrzeżeniem.