SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Bezpieczeństwo

Nie każ modelowi pilnować danych, odbierz mu do nich dostęp

PAR Technology, dostawca analityki dla ponad 300 firm restauracyjnych, pokazuje na blogu AWS, dlaczego modelu językowego nie należy traktować jako granicy bezpieczeństwa danych. Jego agent text-to-SQL na Claude Sonnet 4 nie dostaje identyfikatora firmy w promptcie, lecz wzorzec Split-Plane SQL: system deterministycznie odfiltrowuje dane do tymczasowej piaskownicy, a model widzi tylko jej schemat i nie sięgnie po cudze wiersze. Ponad 50 tysięcy zapytań bez wycieku to własny wynik firmy, działający tylko dlatego, że pytania trafiają w skończony zbiór zdefiniowanych metryk.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Bezpieczeństwo  ·  5 min  · 
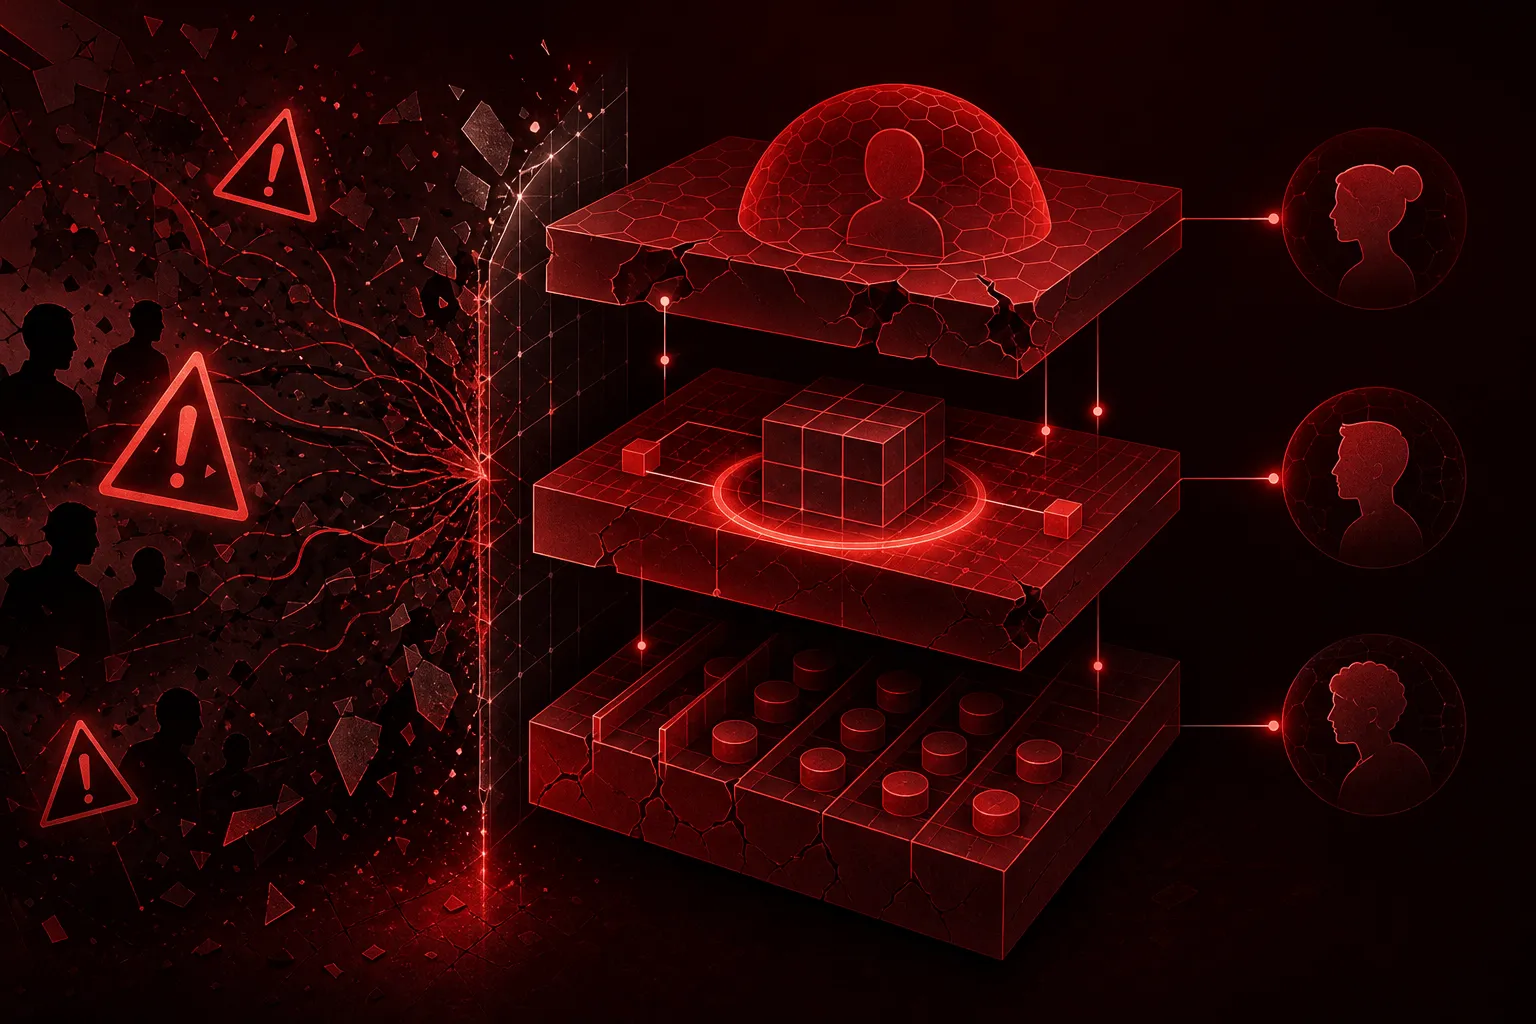
Nie każ modelowi pilnować danych, odbierz mu do nich dostęp
Ilustrację przygotowała AI.

Dwóch użytkowników otwiera tego samego ranka to samo narzędzie analityczne i zadaje dokładnie to samo pytanie: "ile wyniosła sprzedaż w zeszłym tygodniu?". Pierwszy prowadzi dwa lokale w Chicago, więc prawidłowa odpowiedź brzmi 84 tysiące dolarów. Drugi zarządza całą siecią, 200 lokalami w skali kraju, i dla niego prawidłowa liczba to 9,2 miliona dolarów. To samo pytanie, ta sama baza danych, dwie zupełnie różne odpowiedzi i obie poprawne. Gdyby właściciel dwóch lokali zobaczył krajowe 9,2 miliona, byłby to nie tylko błąd, ale i wyciek danych o wynikach innych operatorów w systemie.

Ta scena pochodzi z opisu architektury, który PAR Technology opublikował na blogu AWS. Firma buduje oprogramowanie analityczne dla ponad 300 firm z branży restauracyjnej i postawiła sobie z pozoru prosty cel: pozwolić użytkownikowi zadać pytanie zwykłym językiem i dostać wiarygodną odpowiedź w kilka sekund. Pod spodem model Claude Sonnet 4 na Amazon Bedrock bierze to pytanie i sam układa z niego zapytanie SQL do hurtowni danych. To agent text-to-SQL. Problem w tym, że każde takie zapytanie musi zwrócić dane wyłącznie tego jednego użytkownika, nigdy cudze. To jest właśnie row-level security, bezpieczeństwo na poziomie pojedynczego wiersza w tabeli: ten sam wiersz bywa widoczny dla jednego użytkownika i niewidoczny dla drugiego.

Dlaczego nie da się kazać modelowi pilnować cudzych danych

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

WrenAI każe spisać reguły firmy, zanim agent napisze SQL Premiera / Narzędzie

WrenAI każe spisać reguły firmy, zanim agent napisze SQL

4 min

Canner wypuścił na licencji Apache 2.0 otwarte narzędzie WrenAI, które generuje SQL z pytań zadanych po ludzku na ponad 20 źródłach danych, od Postgresa po Snowflake i BigQuery. Nowość nie leży w samej zamianie pytania na zapytanie, tylko w tym, że Wren każe wcześniej spisać reguły firmy w wersjonowanej warstwie kontekstu: model semantyczny w formacie MDL, definicje biznesowe i pamięć sprawdzonych zapytań. Doczepia się do agenta, jak Claude Code czy Cursor, jednym poleceniem npx. Wartość jest w nadzorze i zwraca się dopiero, gdy zespół zainwestuje w utrzymanie tego kontekstu.

Klucze i dane logowania wyciekają z zaszyfrowanych bloków rozumowania Bezpieczeństwo

Klucze i dane logowania wyciekają z zaszyfrowanych bloków rozumowania

4 min

Zaszyfrowane bloki rozumowania, które modele Anthropic, OpenAI i Google odsyłają przez API, chronią własność dostawcy przed tobą, a nie twoje dane przed kimkolwiek innym. Praca z 10 sierpnia na arXiv pokazuje, że są w pełni wymienne między sesjami i modelami jednego dostawcy, więc słabszy model tej samej firmy odczyta podsunięty blok czystym tekstem, bez łamania szyfru. Z publicznych repozytoriów badacze wydobyli tą metodą 367 fragmentów danych osobowych i 182 komplety danych logowania. Wniosek: zaszyfrowany zapis sesji trzeba traktować jak zwykły tekst jawny i nie wrzucać go na GitHuba.

Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki Premiera / Narzędzie

Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki

4 min

Tejas Chopra prosił Claude'a o wskazanie awarii w logach, a jedno pytanie zjadło dwa okna kontekstowe i 287 dolarów miesięcznie, bo model raz za razem czytał całe logi, by wyłuskać trzy istotne linijki. Tak powstał Headroom, otwarta warstwa przycinająca kontekst, zanim ten doleci do modelu: wycina zbędne znaki z JSON-a (około 30% oszczędności), a oryginał chowa lokalnie na wypadek, gdyby model potrzebował pełnych danych. Chopra reklamuje 700 tysięcy dolarów oszczędności w pięć miesięcy, ale mocniejsza jest sama diagnoza: większość tego, czym karmimy modele, jest zbędna, a płacimy za wszystko.