Model / Badania
Ta sama para modeli, trzy różne rachunki za jedno zadanie
Artificial Analysis wylicza, że średnie zadanie agentowe kosztuje 3,26 dolara na GPT-6 Astra i 7,63 na Claude Fable 5.1 przy identycznej skuteczności, ale OpenAI i Cognition zmierzyły tę samą różnicę na 63% i 42%, a Zvi Mowshowitz wskazuje, że Fable puszczono w trybie Max, co te 57% zawyża. Cognition odpowiada układem Fusion w Devinie, w którym droższy model prowadzi, a tańszy grzebie w kodzie: na DeepSWE 1.1 ścina to koszt zadania o 46% bez straty jakości, tyle że z Astrą na Terminal-Bench 4.0 wynik leci w dół o ponad pięć punktów. Cenę za zadanie widać dopiero na własnym repozytorium.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Model / Badania · 5 min ·
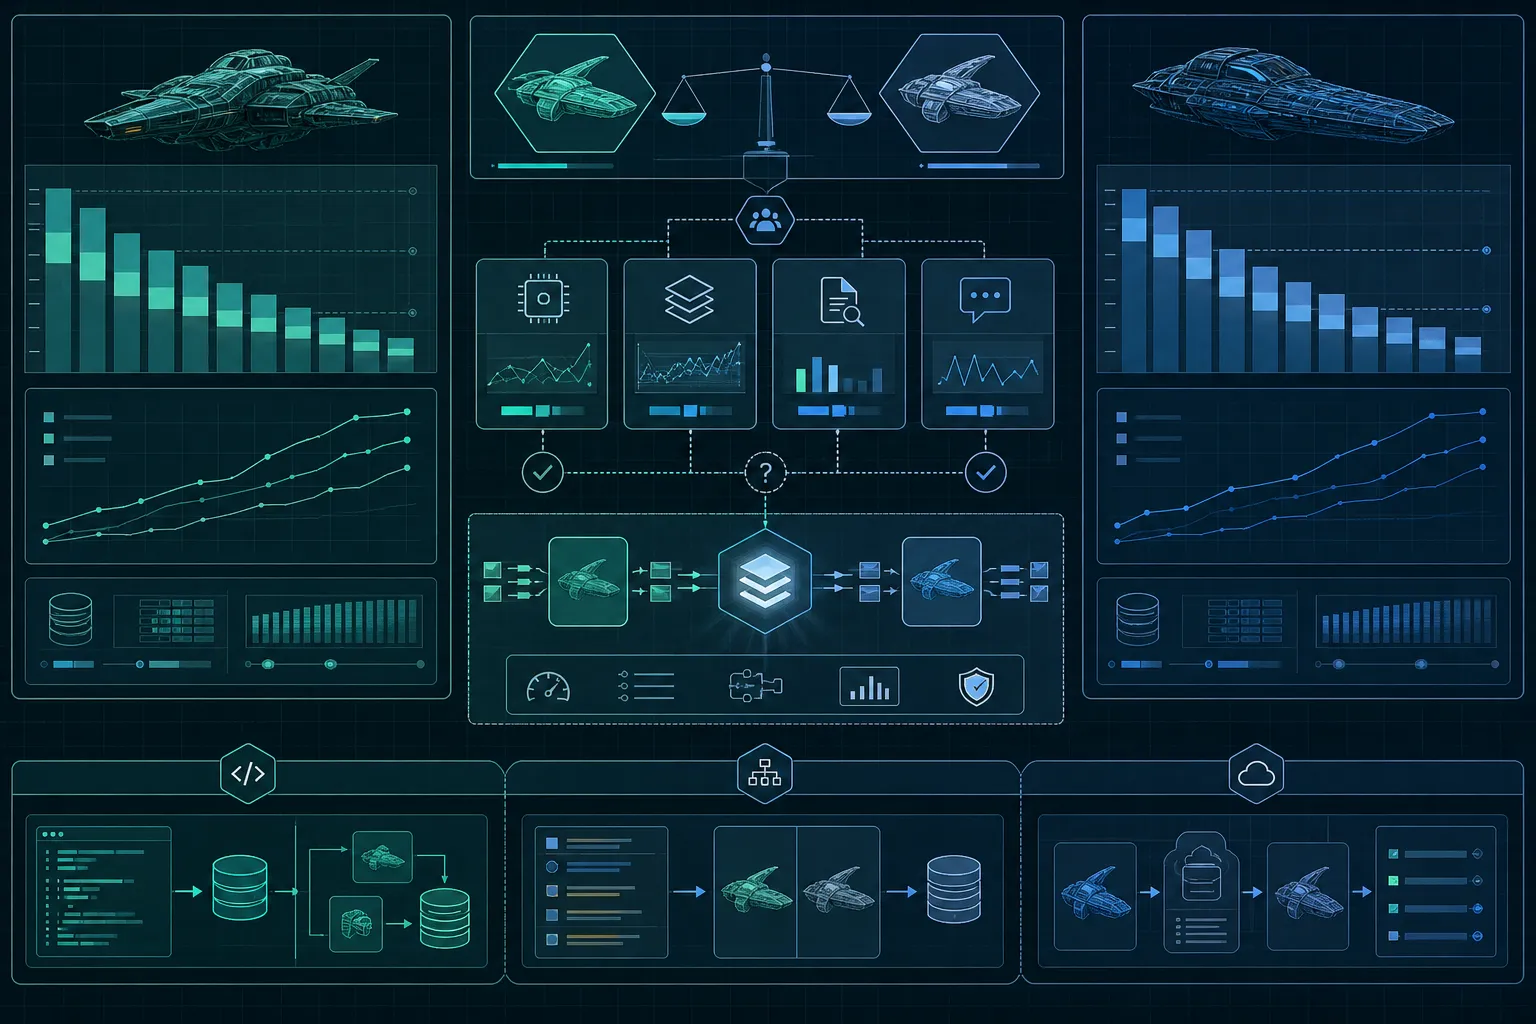
Terminal-Bench 4.0 sadza model przy gołym terminalu i każe mu samemu doprowadzić robotę do końca. Artificial Analysis, niezależna pracownia, która przepuszcza kolejne modele przez własne testy i publikuje wynik razem z rachunkiem, odświeżyło właśnie swój indeks agentowy: 66 zadań Terminal-Bench 4.0 i 657 przepływów w stylu Zapiera. GPT-6 Astra i Claude Fable 5.1 kończą w nim z identycznym wynikiem skuteczności, a średnie zadanie kosztuje 3,26 dolara na Astrze i 7,63 na Fable 5.1. To o 57% mniej za tę samą robotę. Cenniki obu modeli są przy tym nie do odróżnienia, 10 dolarów za milion tokenów na wejściu i 50 na wyjściu, więc taka różnica wygląda na koniec dyskusji o tym, co wybrać do agenta.
Tyle że tę samą różnicę policzono we wrześniu jeszcze dwa razy, na podobnych zadaniach agentowych, i za każdym razem wyszło co innego. OpenAI szacuje, że na Terminal-Bench 4.0 Astra wychodzi za zadanie o 63% taniej niż Fable 5.1, jak zestawia to Maxim AI. Cognition zmierzyło oba modele razem z Artificial Analysis i Vals AI, drugą niezależną pracownią porównującą modele, i podaje na tym teście 17,46 dolara za zadanie na Fable 5.1 i 10,08 na Astrze, czyli 42% różnicy. Trzy pomiary, trzy liczby, a cena jednego zadania na Astrze potrafi się między nimi potroić.
Zvi Mowshowitz, niezależny analityk, który na blogu Don't Worry About the Vase rozbiera kolejne premiery modeli na części, przekopał się przez benchmarki z premiery Astry i dorzuca zdanie wyjaśnienia: Artificial Analysis puściło Fable 5.1 w trybie Max, a ten tryb, jak zastrzega sam Zvi, poza rozmową jest zwykle błędem i prawdopodobnie stąd bierze się ta różnica. Dla mnie to przesądza sprawę. Te 57% mówi więcej o ustawieniach pomiaru niż o samych modelach, więc traktowałbym tę liczbę jako górną granicę tego, co da się wycisnąć z samej podmiany dostawcy.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.