Premiera / Narzędzie
Podręcznik dostrajania modeli, do którego trzeba się najpierw zapisać
Thinking Machines Lab udostępniło na GitHubie tinker-cookbook, otwartą bibliotekę dziewięciu gotowych receptur na dostrajanie modeli językowych, od trójstopniowego RLHF, przez destylację, po dane audio i modele wizualno-językowe. Kod jest otwarty, ale silnik pod spodem, Tinker, chodzi na serwerach firmy w zamkniętej becie, więc żeby cokolwiek uruchomić, trzeba poprosić o dostęp i czekać. W zestawie jest też framework do oceny z dwunastoma benchmarkami i dwie umiejętności dla Claude Code. Bliżej temu do podręcznika podpiętego pod lejek do API niż do narzędzia, które każdy odpala po południu.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
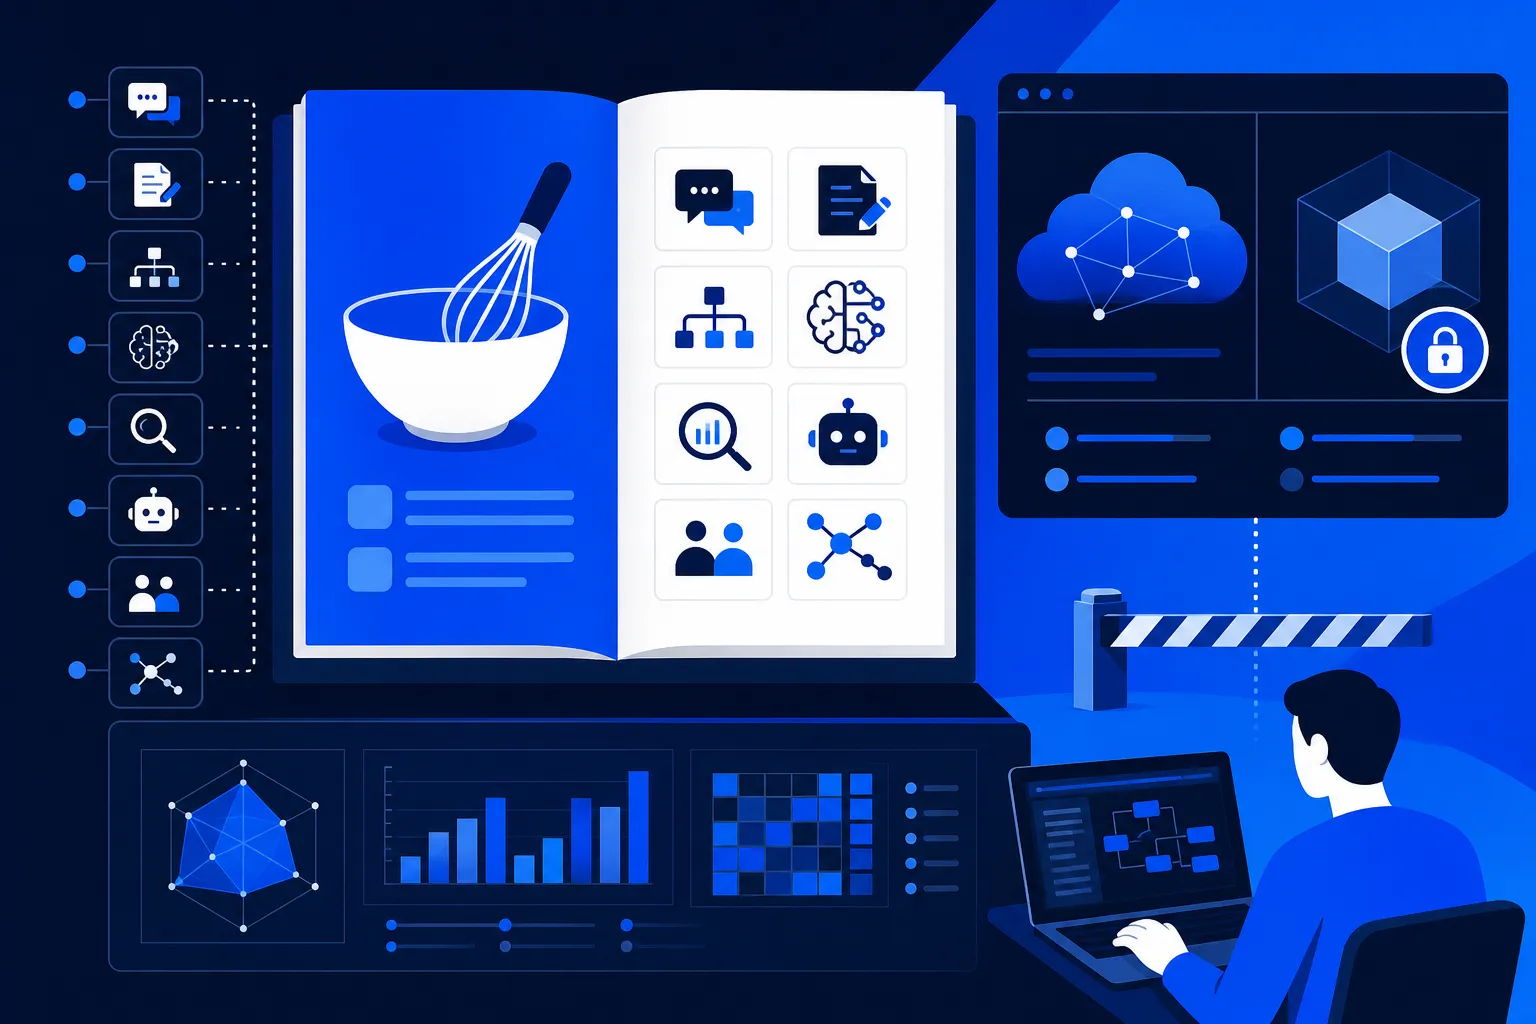
Thinking Machines Lab wrzuciło na GitHuba tinker-cookbook, otwartą bibliotekę gotowych przepisów na dostrajanie modeli językowych. Brzmi jak prezent dla każdego, kto chce wziąć gotowy model i nauczyć go czegoś swojego. Ale zanim odpalicie pierwszy przykład, instrukcja instalacji każe zrobić jedną rzecz: zapisać się na Tinker i poczekać na dostęp. Cała biblioteka stoi na API, które chodzi na serwerach Thinking Machines Lab i wciąż jest w zamkniętej becie. Otwarty jest przepis, nie kuchnia.
Duży model językowy wychodzi z trenowania jako ogólny model bazowy, i żeby zrobił coś konkretnego, trzeba go dostroić na własnych danych. Ta faza po głównym trenowaniu to właśnie post-training. Kłopot w tym, że wymaga rozproszonego trenowania na wielu kartach GPU, a to potrafi zablokować każdego, kto nie ma pod ręką klastra. Tinker to SDK, które bierze tę część na siebie: wysyłacie żądanie do ich serwerów, a one zajmują się całą maszynerią rozproszonego trenowania. Cookbook dokłada do tego warstwę gotowych abstrakcji i przykładów, żebyście nie zaczynali od czystej kartki.
Dziewięć receptur, których zwykle nie ma jako kod
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.