SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Tani model rozmawia, drogi model pisze: wzorzec STORM ze Stanfordu

STORM ze Stanfordu bierze dowolny temat, sam przeszukuje sieć i składa z tego raport z przypisami w stylu Wikipedii, ale najciekawsza jest tu inżynieria, nie efekt. Research rozbito na symulowaną rozmowę autora z ekspertem, dzięki czemu rodzą się pytania głębsze niż te, które model wymyśli na zawołanie. Najpraktyczniejsza lekcja siedzi w konfiguracji: tańszy model prowadzi rozmowę i rozbija zapytania, a mocniejszy pisze finalny tekst z cytatami, gdzie liczy się wierność źródłom. To wzorzec do przeniesienia do własnego projektu, nawet jeśli STORM nie produkuje tekstów gotowych do publikacji.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Tani model rozmawia, drogi model pisze: wzorzec STORM ze Stanfordu
Ilustrację przygotowała AI.

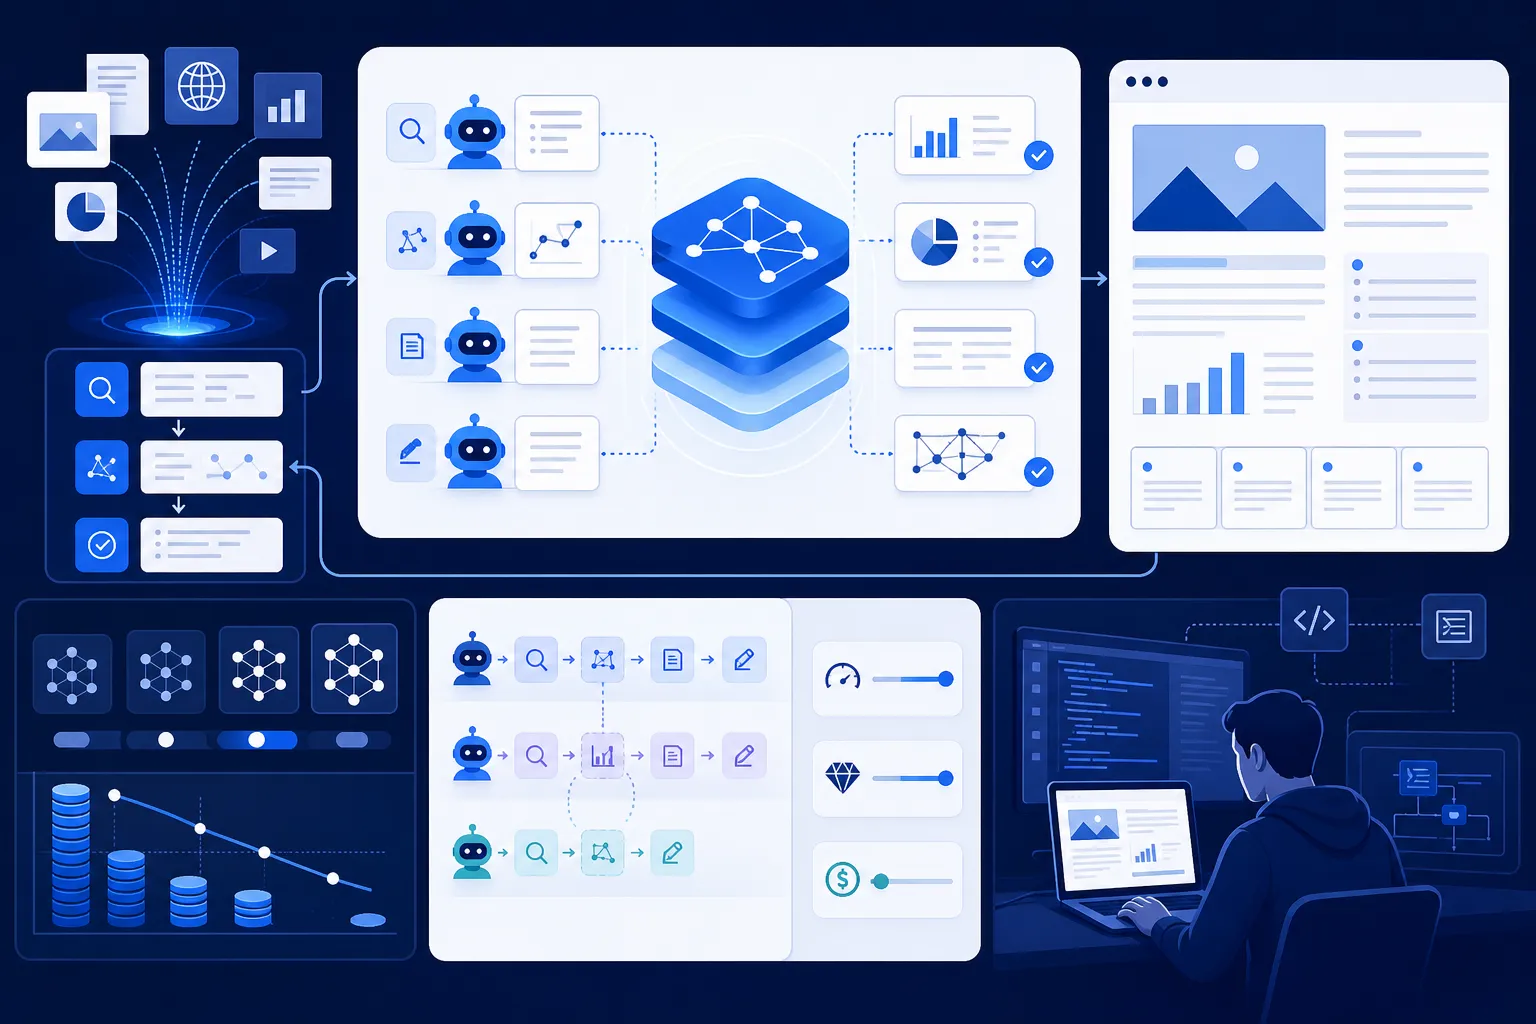
Najbardziej praktyczna lekcja ze STORM siedzi w jednej decyzji: tani model prowadzi research, a drogi pisze finalny tekst. STORM to otwarty system ze Stanfordu, który bierze dowolny temat, sam przeszukuje internet i generuje z tego raport z przypisami w stylu Wikipedii. Brzmi jak kolejny generator tekstu, ale pod spodem kryje się coś, co warto rozłożyć na części: to jeden z czytelniejszych przykładów, jak zorganizować pełny pipeline z wieloma modelami, żeby nie przepłacać i nie tracić na jakości. I to właśnie ta inżynieria, a nie sam efekt, jest tu najciekawsza dla kogoś, kto sam buduje aplikacje na bazie LLM.

Zacznijmy od problemu, który STORM rozwiązuje, bo nie jest oczywisty. Gdy chcesz, żeby model napisał rzetelny materiał o nieznanym mu temacie, naturalnym odruchem jest poprosić go, żeby wymyślił pytania, na które trzeba odpowiedzieć. Autorzy piszą wprost, że to nie działa dobrze: model pytany na sucho generuje pytania płytkie i powtarzalne. STORM obchodzi to dwoma chwytami. Najpierw przegląda istniejące artykuły o podobnych tematach, żeby wyłowić różne perspektywy, z jakich w ogóle da się o czymś pisać. Potem symuluje rozmowę dwóch ról: jedna instancja modelu udaje autora, który zbiera materiały, a druga eksperta, który odpowiada na podstawie znalezionych w sieci źródeł. Z takiej udawanej rozmowy rodzą się pytania pogłębiające, których model sam z siebie by nie zadał.

To jest sedno tego, co warto stąd wynieść: zamiast jednego ogromnego promptu autorzy rozbili research na wymianę zdań między dwiema rolami. Pytanie rodzi odpowiedź, odpowiedź rodzi kolejne pytanie, i dopiero z tego materiału powstaje konspekt, a na końcu tekst.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Wtyczka, która układa twoją historię w wątki, a model dokłada etykiety na końcu Poradnik / Praktyka

Wtyczka, która układa twoją historię w wątki, a model dokłada etykiety na końcu

4 min

openloops, otwartoźródłowa wtyczka do Chrome'a z poradnika FreeCodeCampu autorstwa Shola Jegede, skanuje historię przeglądania i grupuje ją w wątki intencji, licząc podobieństwo domen i słów miarą Jaccarda. Cały rdzeń działa lokalnie w IndexedDB, bez jednego wywołania sieci, a Claude (model Haiku) tylko opcjonalnie dokłada tytuły i następne kroki. Pouczający jest moment, w którym pierwsza wersja po cichu się wywaliła: przy 30 wątkach odpowiedź uderzyła w limit max_tokens i urwała JSON. Lekcja brzmi tak, że model wpina się jako wycinalny dodatek, nie jako centrum produktu.

Trzy frameworki, które każą maszynie pisać własne prompty i skille Premiera / Narzędzie

Trzy frameworki, które każą maszynie pisać własne prompty i skille

5 min

Trzy czerwcowe projekty open-source, GEPA, EvoSkill i Self-Harness, oddają maszynie to, co dotąd pisał inżynier: prompt, umiejętności agenta i reguły jego działania. Pętla ewolucyjna sama generuje warianty, ocenia je i zachowuje najlepsze, obiecując kilkudziesięcioprocentowy skok skuteczności bez dotykania wag modelu; GEPA podbił GPT-4.1 Mini na zadaniach AIME z 46,6% do 56,6% przy 100 do 500 prób zamiast tysięcy. Działa to jednak tylko tam, gdzie wynik da się tanio i jednoznacznie zmierzyć, więc nowa rola człowieka to napisać dobrą miarę, a nie cyzelować pojedyncze zdanie.

Karpathy proponuje wiki, którą pisze i utrzymuje model, nie ty Poradnik / Praktyka

Karpathy proponuje wiki, którą pisze i utrzymuje model, nie ty

5 min

Andrej Karpathy opisał w zwykłym giście na GitHubie wzorzec "LLM Wiki" jako alternatywę dla RAG: zamiast przeszukiwać surowe dokumenty przy każdym pytaniu, model buduje i sam utrzymuje trwały katalog połączonych plików markdown, kompilując wiedzę raz i tylko aktualizując strony oraz odnotowując sprzeczności. Kluczowy jest schemat w stylu CLAUDE.md, który mówi modelowi, co robić z nowym źródłem. Gist zebrał ponad pięć tysięcy gwiazdek nie dzięki nowej technologii, lecz dlatego, że nazwał coś, co wielu po cichu sklejało, i odpowiada na stare pytanie: kto zniesie nudę utrzymania wiki.