SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Self-Harness: model czyta zapisy własnych porażek i dopisuje sobie reguły

Praca Self-Harness z arXiv proponuje, żeby agent sam poprawiał harness, czyli reguły i narzędzia wokół modelu: przegląda zapisy własnych porażek, proponuje drobne zmiany i zostawia tylko te, które przejdą testy regresji. Na Terminal-Bench-2.0, SWE-bench Verified i AppWorld, z modelami MiniMax M2.5, Qwen3.5-35B-A3B i GLM-5, wynik poprawił się we wszystkich dziewięciu parach, także na zadaniach, których pętla nie widziała. Najwięcej wart jest jednak sam porządek pętli z bramką testów, bo reguły dopisane przez model ktoś i tak musi przeczytać.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
Self-Harness: model czyta zapisy własnych porażek i dopisuje sobie reguły
Ilustrację przygotowała AI.

Agent pracujący w terminalu wpada w pętlę: polecenie zwraca błąd, więc ponawia je raz za razem, aż skończy mu się czas na zadanie. Inny łata błąd w repozytorium i oddaje poprawkę, nie sprawdziwszy, czy testy w ogóle przechodzą. Takie wpadki rzadko biorą się z tego, że model nie umie programować. Zawodzi raczej warstwa wokół niego, czyli harness: zestaw reguł, narzędzi i instrukcji, który decyduje, co model widzi, czym może działać i kiedy powinien przestać. Praca Self-Harness z serwisu arXiv proponuje, żeby tę warstwę poprawiał sam agent, na podstawie zapisów własnych porażek.

Pierwsza wersja tej pracy ukazała się w czerwcu. Od tamtej pory autorzy wypuścili dwie poprawione wersje, ostatnią 20 sierpnia, i udostępnili kod na GitHubie. Skoro kod jest publiczny, pytanie przestaje być akademickie i dotyczy już mojego warsztatu: czy warto przenieść ten pomysł do własnego agenta? Skłaniam się ku odpowiedzi, że tak, ale z innego powodu, niż sugeruje tytuł. Najwięcej wart jest tu porządek pętli, w której każda zmiana musi się wybronić testami, a dopiero potem to, że zmiany proponuje model, a nie człowiek.

Dlaczego harness trzeba szyć pod konkretny model

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Self-Harness: agent czyta własne logi i sam łata swoje opakowanie
Analiza / Opinia

Self-Harness: agent czyta własne logi i sam łata swoje opakowanie

4 min

Self-Harness, opisany w pracy z arXiv z 8 czerwca, każe agentowi czytać własne logi z awarii i samodzielnie przepisywać reguły swojego opakowania w pętli: znajdź słabość, załataj, przepuść zmianę przez testy regresji. Na Terminal-Bench-2.0 największy skok zaliczył najsłabszy model, Qwen3.5, który z 23,8% doszedł do 38,1%, podczas gdy mocniejsze MiniMax M2.5 i GLM-5 podniosły się słabiej. Wygląda to więc na sposób, żeby tańszy albo hostowany lokalnie model podciągnąć do poziomu, na którym w ogóle nadaje się do roboty, choć zostaje pytanie, kto potem czyta reguły, które napisał model.

Co, jeśli lepszy agent nie potrzebuje większego modelu, tylko lepszego harnessu?
Premiera / Narzędzie

Co, jeśli lepszy agent nie potrzebuje większego modelu, tylko lepszego harnessu?

3 min

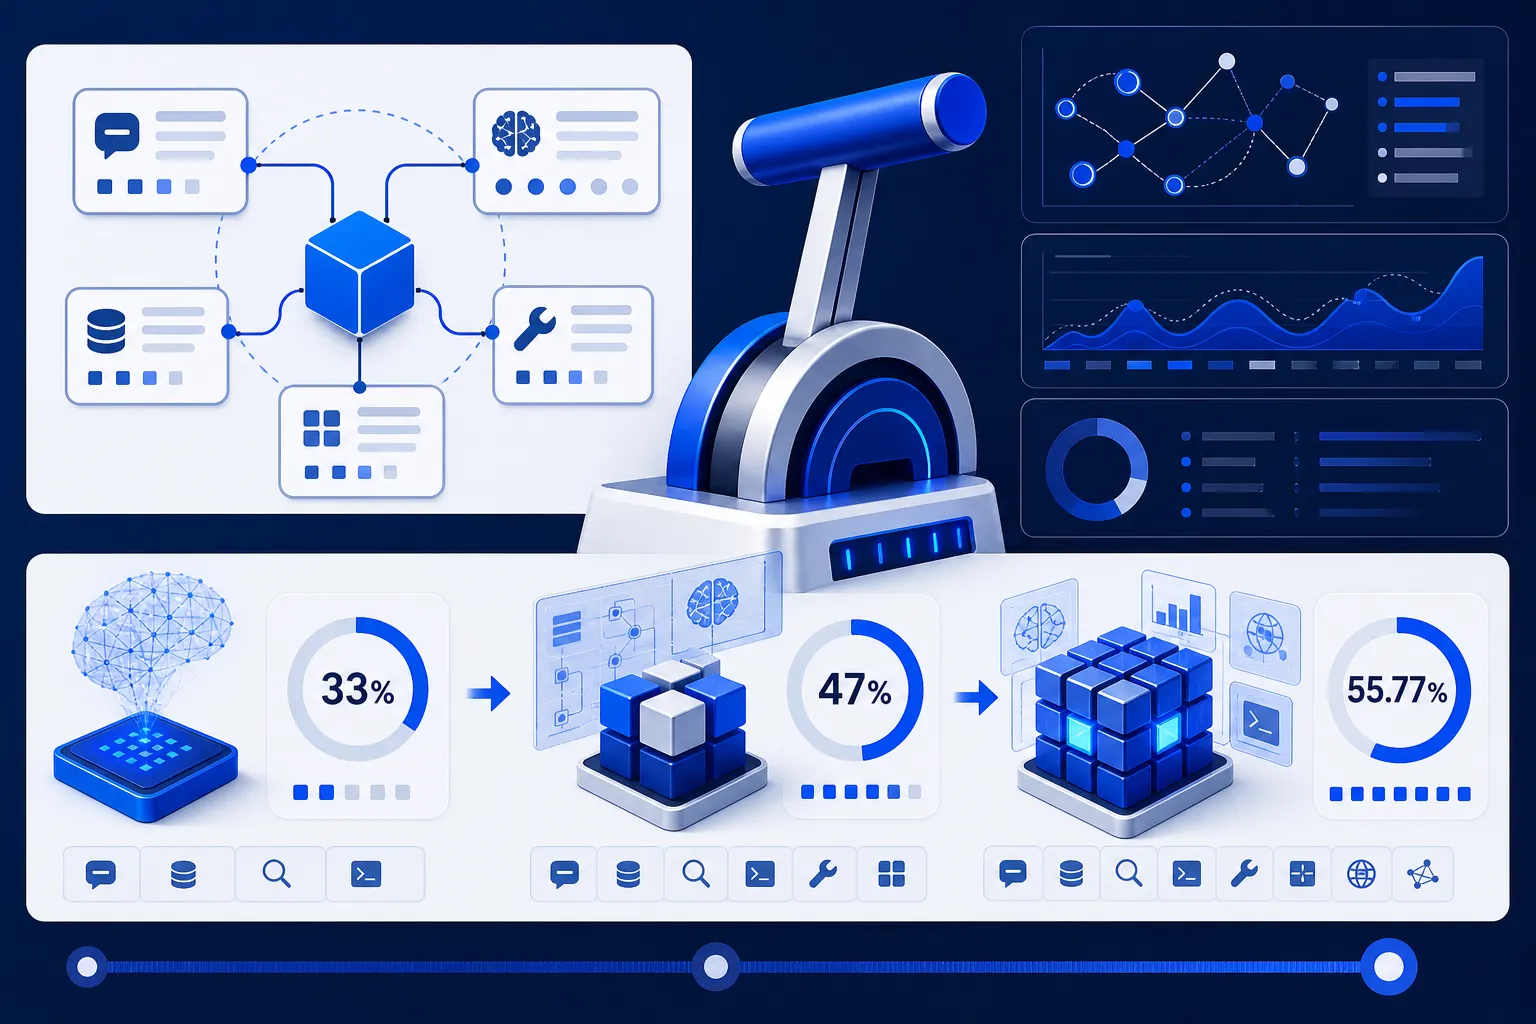
HarnessX, otwarty framework Darwin Agent na licencji MIT, traktuje harness — warstwę wokół modelu, która decyduje o narzędziach, pamięci i kontekście — jako wymienny klocek, ulepszany osobno od samych wag. Na Qwenie 3.5 9B sama przebudowa harnessu podnosi wynik na GAIA z 33,97% do 41,67%, a douczenie modelu RL-em dociąga go do 55,77%; ten sam schemat na GPT-5 idzie z 62% do 84%. Skłaniam się ku tezie, że architektura agenta to dźwignia, po którą sięga się za rzadko, ale liczby podał sam autor na jednym benchmarku, w wersji 0.1.0 beta, i wciąż czekają na niezależne powtórzenie.

Claude Code, OpenCode i mini-SWE-agent na tych samych modelach: wynik ten sam, rachunek do trzech razy wyższy
Analiza / Opinia

Claude Code, OpenCode i mini-SWE-agent na tych samych modelach: wynik ten sam, rachunek do trzech razy wyższy

5 min

Badacze z Uniwersytetu Shandong uruchomili te same modele w Claude Code, OpenCode i mini-SWE-agent na blisko 500 zadaniach z SWE-bench Verified i wyszło, że harness nie podnosi skuteczności ponad zwykły rozrzut między próbami, za to potrafi potroić koszt zadania. Claude Code wysyła na start ponad 16,5 tysiąca tokenów stałego kontekstu, a mini-SWE-agent nieco ponad 800, i ten narzut rośnie z każdym krokiem. Zanim zapłacisz za cięższy harness, warto dwa razy puścić własną konfigurację i zobaczyć, o ile wynik waha się sam z siebie.