SmartDigest Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Stare logi agenta jako poligon dla nowej strategii szukania

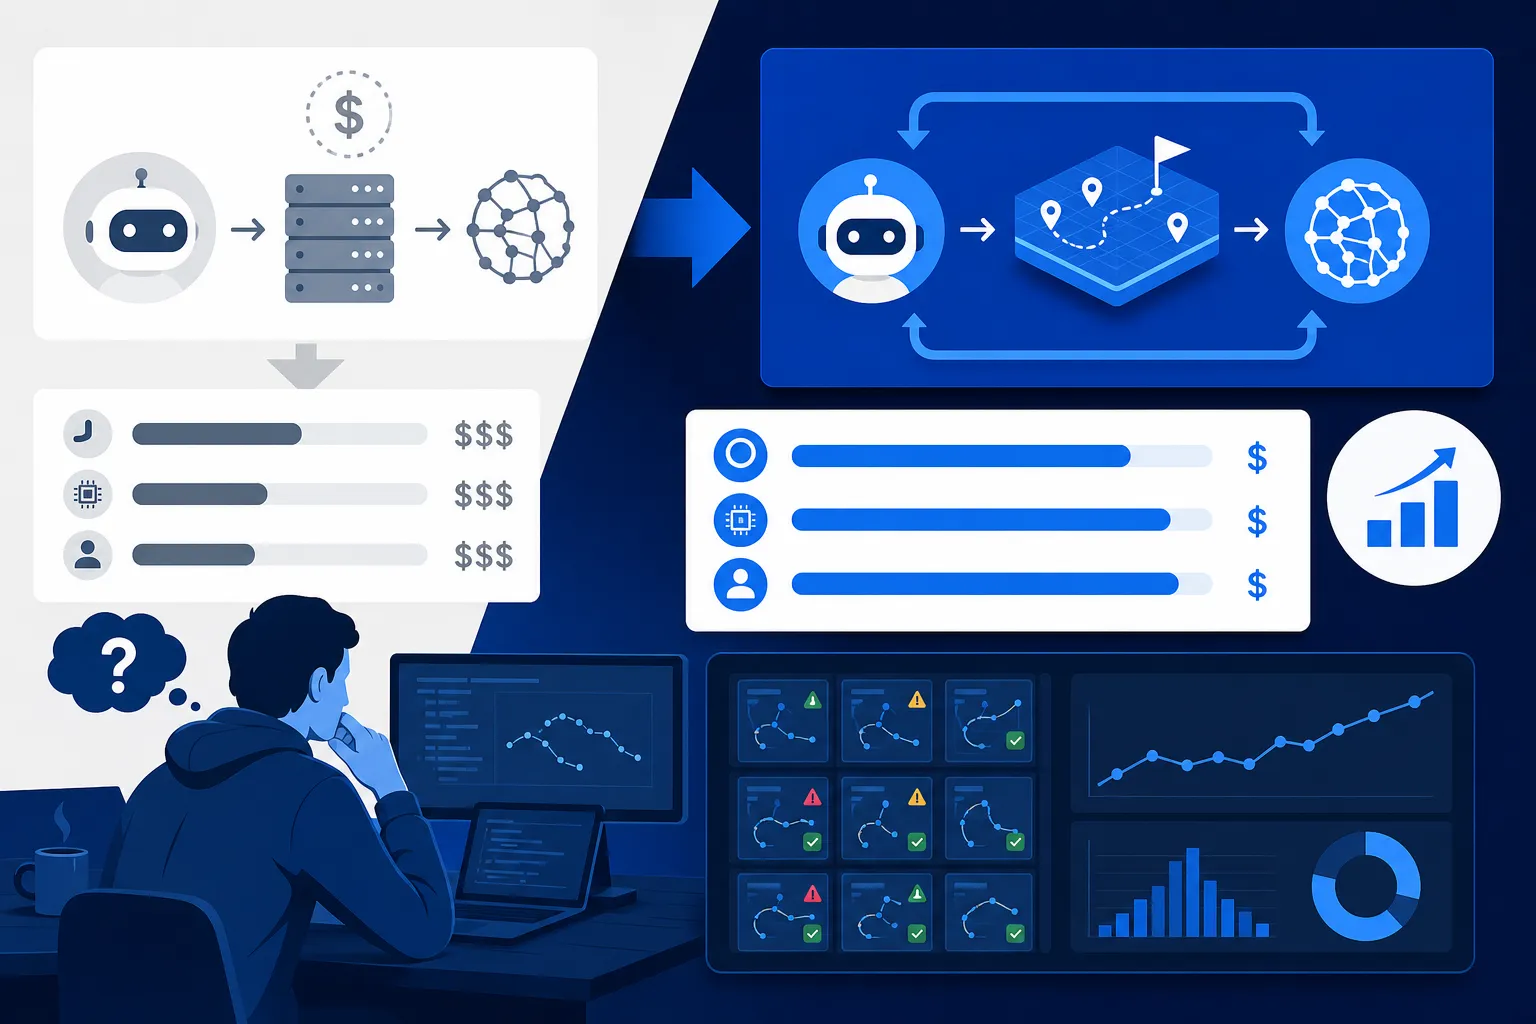
Dream-RSI od Google DeepMind, mimo groźnej etykiety rekurencyjnego samodoskonalenia, nie zmienia samego modelu, tylko strategię, według której agent programistyczny rozdziela próby między ścieżki rozwiązań, a ćwiczy ją na nagraniach starych przebiegów. W najlepszym zadaniu na GPU dało to 2,43 raza mniej prób. Niezależne eksperymenty TheAstrayDev pokazują jednak, że przygotowanie potrafi kosztować 100 zapytań zamiast 24, a spłata przychodzi dopiero po około 48 podobnych zadaniach, więc na razie najwięcej daje zapisywanie całej ścieżki decyzji agenta.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Stare logi agenta jako poligon dla nowej strategii szukania
Ilustrację przygotowała AI.

Skrót RSI, czyli rekurencyjne samodoskonalenie, wraca we wrześniu głównie w tekstach o końcu świata. Axios 22 września zestawił deklarację Anthropica, że AI prowadzi już około 26% jego prac badawczo-rozwojowych, ze scenariuszem, w którym model sam buduje swoich następców poza ludzką kontrolą. W tym samym tekście, jednym zdaniem, pojawia się Dream-RSI od badaczy Google DeepMind. Przeczytałem tę pracę dokładniej i Dream-RSI okazał się dużo skromniejszy niż etykieta, którą nosi. Moim zdaniem właśnie dlatego przyda się każdemu, kto buduje agentów, bo zamiast wizji maszyny poprawiającej samą siebie dostajemy konkretną technikę tańszego szukania rozwiązań.

Co dokładnie zmienia Dream-RSI

Tong Zheng z Uniwersytetu Maryland i zespół Google DeepMind opisują w pracy o Dream-RSI agenta programistycznego, który poluje na lepsze rozwiązania trudnych problemów, na przykład szybszy algorytm albo sprawniejszy fragment kodu uruchamiany na karcie graficznej. Taki agent robi setki prób: pisze kandydata, puszcza testy, dostaje ocenę i decyduje, czy dalej poprawiać tę ścieżkę, czy otworzyć nową. O tych wyborach zwykle rozstrzyga sztywna reguła w rodzaju "trzymaj dziesięć ścieżek i każdej daj tyle samo kroków", przez co budżet przepala się na pomysłach, które od dawna nie rokują.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe Premiera / Narzędzie

Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe

4 min

Microsoft Research wypuścił SkillOpt, narzędzie, które zamiast dotrenowywać model, trenuje sam plik z instrukcją dla agenta. Osobny optymalizator proponuje zmiany w dokumencie i zachowuje tylko te, które realnie podnoszą wynik na odłożonym zbiorze zadań walidacyjnych. Na sześciu benchmarkach i siedmiu modelach SkillOpt wypada najlepiej lub na równi we wszystkich 52 przypadkach, a na GPT-5.5 dorzuca średnio ponad 23 punkty skuteczności. Efektem jest jeden plik best_skill.md, bez dodatkowych kosztów w trakcie pracy. Wyniki pochodzą jednak od autorów metody.

Ta sama para modeli, trzy różne rachunki za jedno zadanie Model / Badania

Ta sama para modeli, trzy różne rachunki za jedno zadanie

5 min

Artificial Analysis wylicza, że średnie zadanie agentowe kosztuje 3,26 dolara na GPT-6 Astra i 7,63 na Claude Fable 5.1 przy identycznej skuteczności, ale OpenAI i Cognition zmierzyły tę samą różnicę na 63% i 42%, a Zvi Mowshowitz wskazuje, że Fable puszczono w trybie Max, co te 57% zawyża. Cognition odpowiada układem Fusion w Devinie, w którym droższy model prowadzi, a tańszy grzebie w kodzie: na DeepSWE 1.1 ścina to koszt zadania o 46% bez straty jakości, tyle że z Astrą na Terminal-Bench 4.0 wynik leci w dół o ponad pięć punktów. Cenę za zadanie widać dopiero na własnym repozytorium.

Jury Google'a zajrzało w kod i znalazło jeden model z imionami agentów Poradnik / Praktyka

Jury Google'a zajrzało w kod i znalazło jeden model z imionami agentów

4 min

Google przejrzał kod tysięcy zgłoszeń na AI Agents Challenge i opisał cztery wzorce, które powtarzały się u najlepszych, choć żaden nie dotyczy agentów jako takich. Zamiast łańcucha wywołań jeden zespół postawił cztery kolejki asyncio.Queue, inny wstawił przed model lokalny regex, który odsiał ponad 40% wiadomości, zanim cokolwiek trafiło na rachunek za inferencję, a kolejny wystawił własnego agenta jako serwer MCP. Liczby są pomiarami samych zespołów, a konkurs oceniało jury firmy, która go zorganizowała, więc to obserwacja, nie dowód.