SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Torvalds ujawnia: kod, testy i recenzję jego poprawek jądra Linuksa przygotował Claude Code

Linus Torvalds ujawnił, że kod, testy, recenzję i szkic listu przewodniego do ośmiu eksperymentalnych poprawek jądra Linuksa przygotował Claude Code pod jego kierunkiem, a on sam wybrał problem i zmierzył wyniki na swoim komputerze. Poprawki z gałęzi noref-filemap-read-with-llm pozwalają wątkom czytać dane z page cache bez podbijania licznika odwołań, co ma usunąć wąskie gardło przy wielu wątkach. Do oficjalnego jądra jeszcze nie trafiły, więc prawdziwym testem będzie dopiero przegląd zrobiony przez ludzi.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  3 min  · 
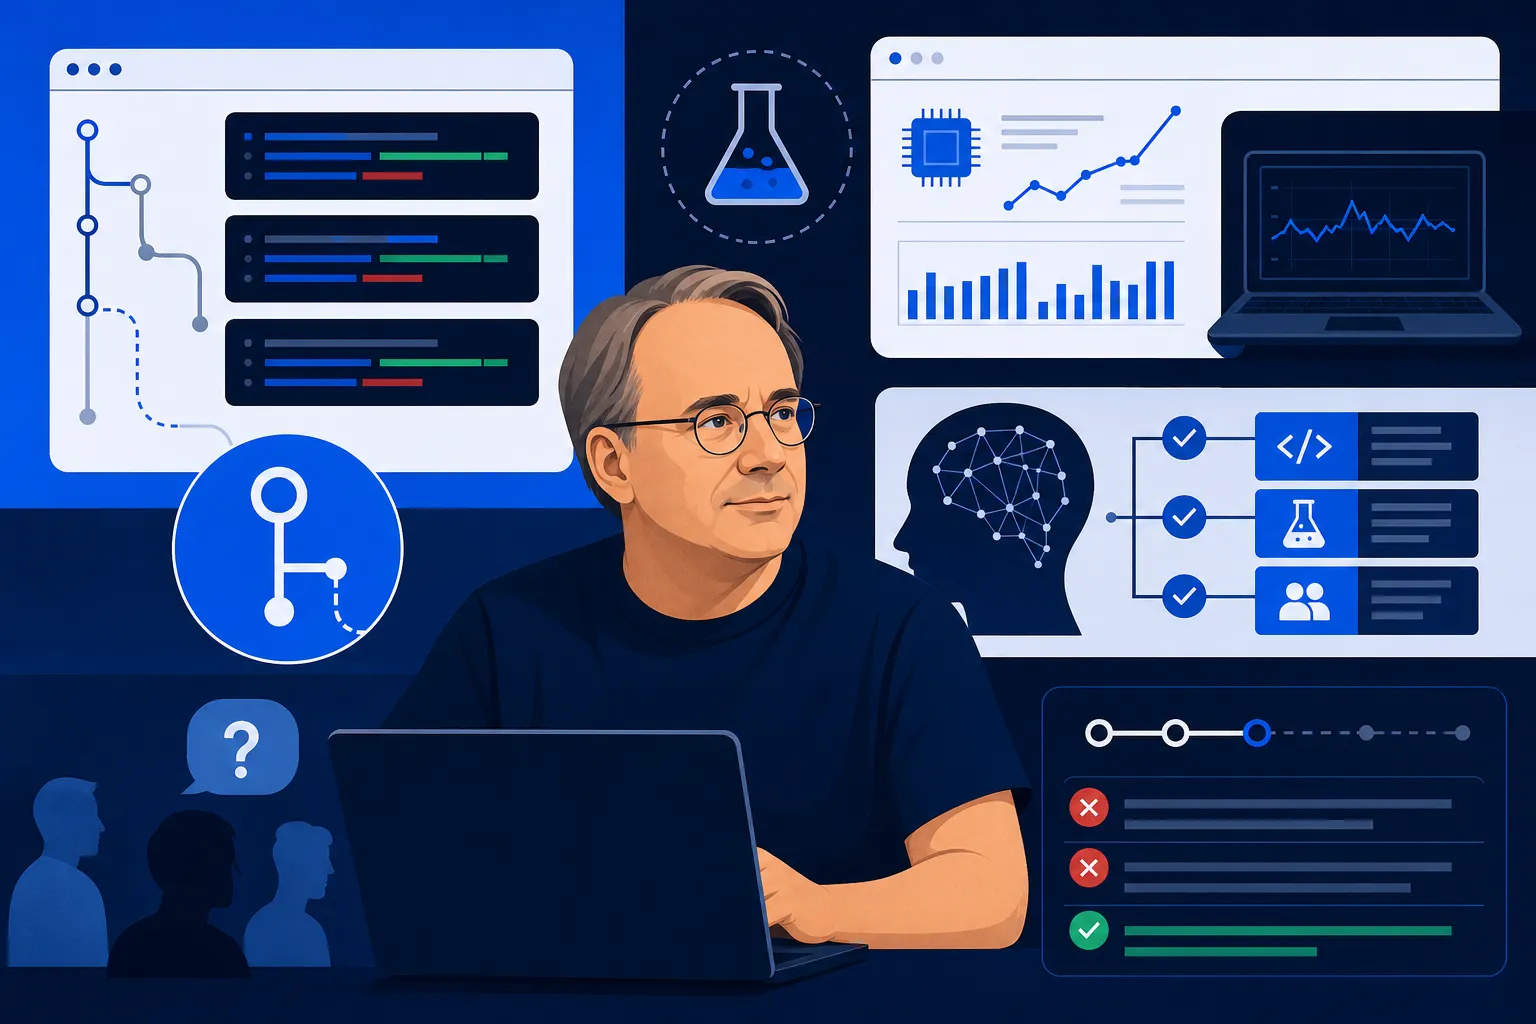
Torvalds ujawnia: kod, testy i recenzję jego poprawek jądra Linuksa przygotował Claude Code
Ilustrację przygotowała AI.

Linus Torvalds, twórca Linuksa, długo patrzył na kod pisany przez AI z dystansem. Teraz w jego głównym repozytorium pojawiła się gałąź o nazwie noref-filemap-read-with-llm, a dopisek "with-llm" nie jest żartem. W liście otwierającym serię poprawek Torvalds napisał wprost, że kod, programy testowe, przegląd zmian i pierwszą wersję samego listu przygotował Claude Code, asystent programistyczny Anthropica, pracujący pod jego kierunkiem (Open Source For You).

Czytam to jako uczciwie opisany eksperyment jednej osoby, a nie zmianę zasad w projekcie Linux. Seria liczy osiem poprawek, jak podaje Computerworld, powołując się na ZDNet, a wszystkie są eksperymentalne i nie trafiły do oficjalnego jądra (Computerworld). Mimo to ta historia mówi o pracy z agentem więcej niż większość pokazów producentów, bo autor rozpisał, kto co zrobił, zamiast ogłaszać sukces.

Co poprawia seria Torvaldsa

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Z Linuksa wylatuje 27 tysięcy linii kodu, bo skanery AI zalały opiekunów
Analiza / Opinia

Z Linuksa wylatuje 27 tysięcy linii kodu, bo skanery AI zalały opiekunów

3 min

Społeczność jądra Linuksa rozważa wycięcie około 27 tysięcy linii kodu sterowników sieciowych ISA i PCMCIA dla sprzętu firm 3Com czy Xircom, bo skanery AI zalewają listy mailingowe raportami o błędach w kodzie, którego prawie nikt już nie uruchamia. Andrew Lunn, opiekun podsystemu sieciowego, tłumaczy asymetrię kosztu: zgłaszającego raport kosztuje minuty, opiekuna godzinę odtwarzania kontekstu kodu sprzed dwóch dekad. Najprostsza obrona to filtr osiągalności po stronie twórców skanerów, bez niego następne w kolejce są mniejsze projekty open source.

Kod przechodzi linter i testy, a i tak bywa błędny
Bezpieczeństwo

Kod przechodzi linter i testy, a i tak bywa błędny

4 min

Agent od kodu w jedno popołudnie otwiera kilkadziesiąt pull requestów, ale liczy się dla niego skończenie zadania, a nie to, żeby wyszło bezpiecznie. AWS proponuje na to trójwarstwową ramę: twarde automaty jak linter i skanery, model w roli sędziego oceniający intencję zmiany, oraz człowieka rezerwowanego tylko do kodu wrażliwego albo nowej logiki. Największy problem to kod, który przechodzi wszystkie automaty, a mimo to jest funkcjonalnie błędny. Rama zostaje mapą, nie dowodem, bo brakuje w niej choćby jednej liczby na to, że realnie zbija liczbę wpadek.

Arbor rozplątuje to, co Claude Code i Codex robią naraz
Premiera / Narzędzie

Arbor rozplątuje to, co Claude Code i Codex robią naraz

5 min

Arbor, framework badaczy z Renmin University of China i Microsoft Research, rozdziela autonomiczną optymalizację kodu na długowiecznego koordynatora i krótko żyjących wykonawców, z których każdy testuje jedną hipotezę w osobnej kopii repozytorium gita. Sednem jest drzewo poszukiwań z bramką scalenia, która wpuszcza zmianę tylko wtedy, gdy realnie poprawia wynik na ukrytym zbiorze testowym. Na Terminal-Bench 2.0 Arbor sięgnął 77,36 punktu tam, gdzie Claude Code spadło do 71, a autorzy chwalą się ponad dwuipółkrotnie większymi zyskami niż Codex, choć to liczba z laboratorium.