SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Trwała pamięć i śledzenie wyników jako odkrycie maszyny, nie projektanta

W pracy HyperAgents badacze Meta pokazali system, który przepisuje nie tylko agenta rozwiązującego zadania, ale też zasady, według których sam wprowadza zmiany. Sprawdzona w czterech dziedzinach wersja DGM-H, rozwinięcie Darwin Gödel Machine, sama dodała sobie trwałą pamięć i śledzenie wyników, czyli dokładnie to, co dziś ręcznie doklejamy do agentów. Dla programistów to sygnał, że ciężar pracy przesunie się na testy i miary, według których wiadomo, że nowa wersja jest lepsza.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
Trwała pamięć i śledzenie wyników jako odkrycie maszyny, nie projektanta
Ilustrację przygotowała AI.

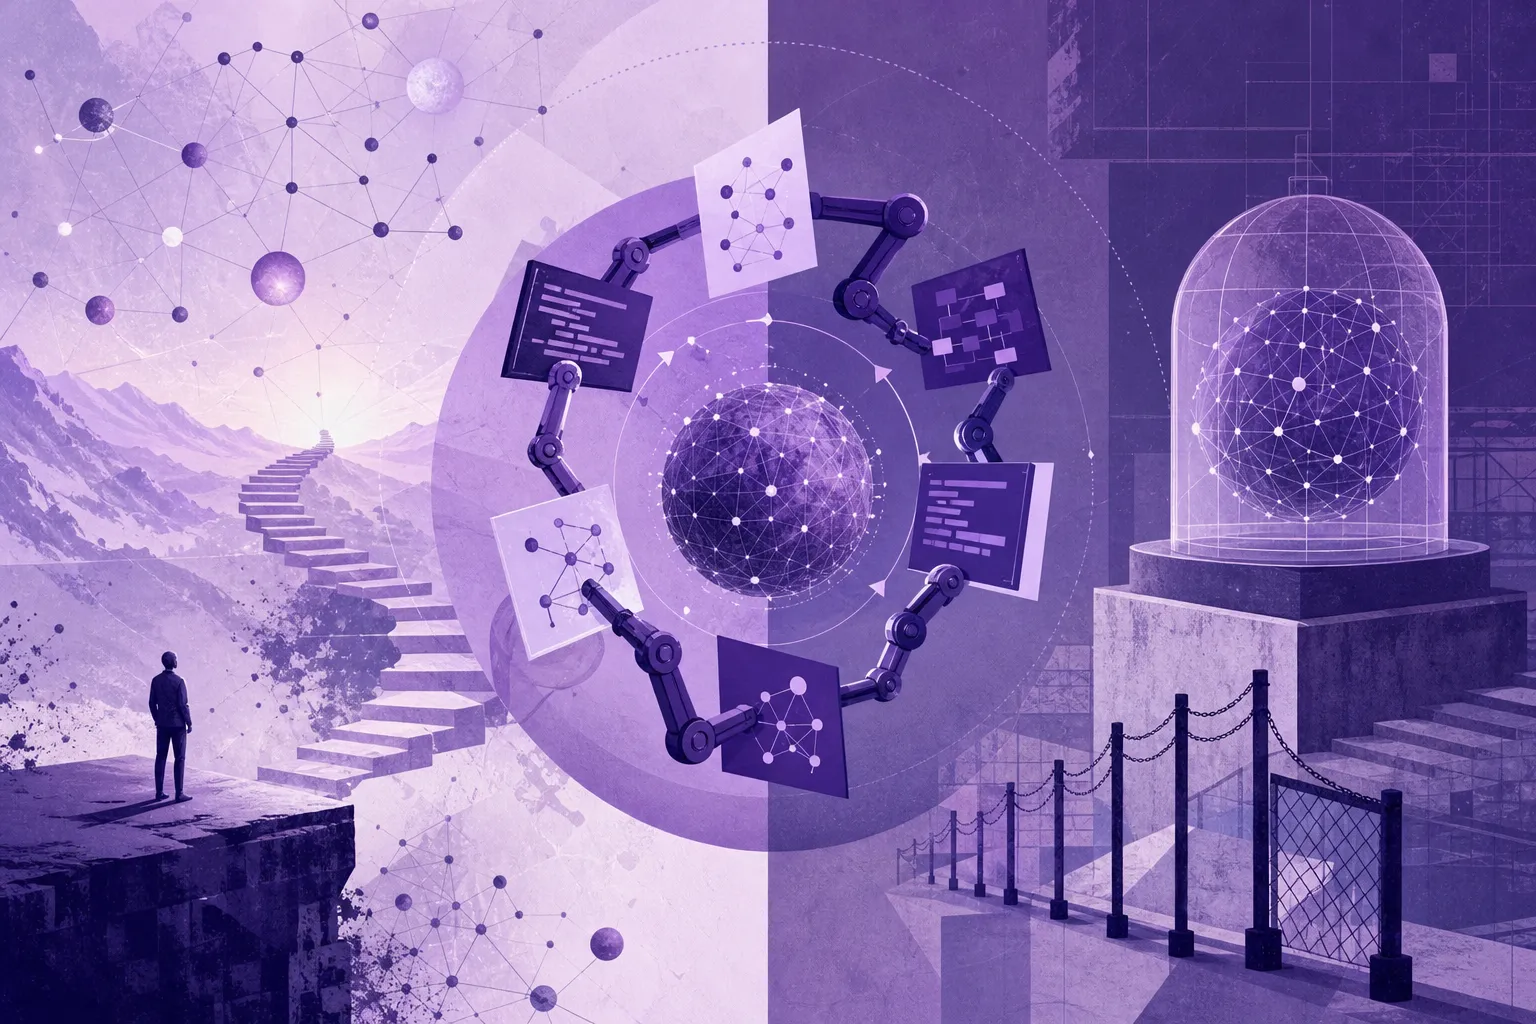
Kto budował własnego agenta do pisania kodu, zna ten rytuał: dopisujesz mu pamięć między sesjami, każesz notować, które próby się udały, a po każdej porażce poprawiasz instrukcje. W pracy HyperAgents, którą badacze Meta opublikowali 24 marca, takie elementy pojawiły się, choć nikt ich systemowi wprost nie wpisał. System, który miał przerabiać agenta tak, żeby lepiej radził sobie z zadaniami z danej dziedziny, sam doszedł do tego, że przyda mu się trwała pamięć i śledzenie własnych wyników, a potem przeniósł te usprawnienia do zupełnie innych dziedzin.

Praca ma ponad pół roku, więc nie piszę o niej jako o nowości. Piszę, bo ten jeden szczegół mówi mi więcej niż cała obietnica samodoskonalącej się AI. Moim zdaniem HyperAgents to mniej zapowiedź agentów, które będą się ulepszać w nieskończoność, a bardziej wskazówka, że części, które dziś ręcznie doklejamy do agentów, są tym, do czego automatyczne przeszukiwanie i tak dochodzi samo.

Agent, który przepisuje własny kod

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Stare logi agenta jako poligon dla nowej strategii szukania
Premiera / Narzędzie

Stare logi agenta jako poligon dla nowej strategii szukania

4 min

Dream-RSI od Google DeepMind, mimo groźnej etykiety rekurencyjnego samodoskonalenia, nie zmienia samego modelu, tylko strategię, według której agent programistyczny rozdziela próby między ścieżki rozwiązań, a ćwiczy ją na nagraniach starych przebiegów. W najlepszym zadaniu na GPU dało to 2,43 raza mniej prób. Niezależne eksperymenty TheAstrayDev pokazują jednak, że przygotowanie potrafi kosztować 100 zapytań zamiast 24, a spłata przychodzi dopiero po około 48 podobnych zadaniach, więc na razie najwięcej daje zapisywanie całej ścieżki decyzji agenta.

Praca z arXiv obiecuje tańszą pamięć agentów bez spadku dokładności
Analiza / Opinia

Praca z arXiv obiecuje tańszą pamięć agentów bez spadku dokładności

4 min

Nowa praca na arXiv, zgłoszona 23 lipca przez Gaurava Dadhicha z zespołu Maximem AI, przekonuje, że produkcyjne agenty zawodzą nie przez słabe rozumowanie, lecz przez brak panowania nad kontekstem: historią rozmowy, rozdętymi promptami i wynikami narzędzi. Najcenniejsza jest tu diagnoza kosztu: naiwne doklejanie historii rośnie kwadratowo, streszczanie na skróty tnie liniowo, ale ma swoje urwisko dokładności, a rozsądnym wyjściem jest kompresja z walidacją. Wyniki 92% na LongMemEval i 93,2% na LoCoMo firma zmierzyła jednak sama, na własnym produkcie Maximem Synap i bez punktu odniesienia.

Autonomia agenta ma swoją cenę, liczoną w minutach i tokenach
Analiza / Opinia

Autonomia agenta ma swoją cenę, liczoną w minutach i tokenach

4 min

Dwaj inżynierowie z IBM dali asystentowi kodu dokumentację LangChain4j i poprosili, żeby zbudował własną kopię, czyli działający system wielu agentów. Model sam wybrał wzorzec nadzorcy z czterema podwładnymi i odtworzył architekturę, na jakiej sam działa. Na słabszym gpt-4o system wpadł w pętlę i padł po 100 wywołaniach narzędzi, za to gpt-5-mini naprawił wszystkie cztery błędy w testowej klasie Calculator, a 11 testów przeszło na zielono. Druga, deterministyczna wersja oparta na workflow zrobiła to samo trzy razy szybciej, bo nie płaci za osobne wywołanie modelu przy każdej decyzji nadzorcy.