Premiera / Narzędzie
Czy agent może nauczyć się waszych zasad code review z samych komentarzy w PR-ach?
Kilo wprowadziło trzy zmiany w swoim agencie do recenzji kodu: plik REVIEWS.md z konwencjami zespołu, mechanizm Code Review Memory uczący się reguł z historii waszych reakcji na uwagi oraz lokalne podpowiedzi w VS Code jeszcze przed pushem. Code Review Memory brzmi najciekawiej, ale uczy się z ubogiego sygnału, bo jedno kliknięcie Reject może oznaczać trzy różne rzeczy, więc jego propozycje warto traktować jak pull request od kogoś, kto zna projekt powierzchownie. Najbardziej przekonuje lokalna recenzja niezacommitowanych zmian, która oszczędza całą rundę przez CI.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 4 min ·
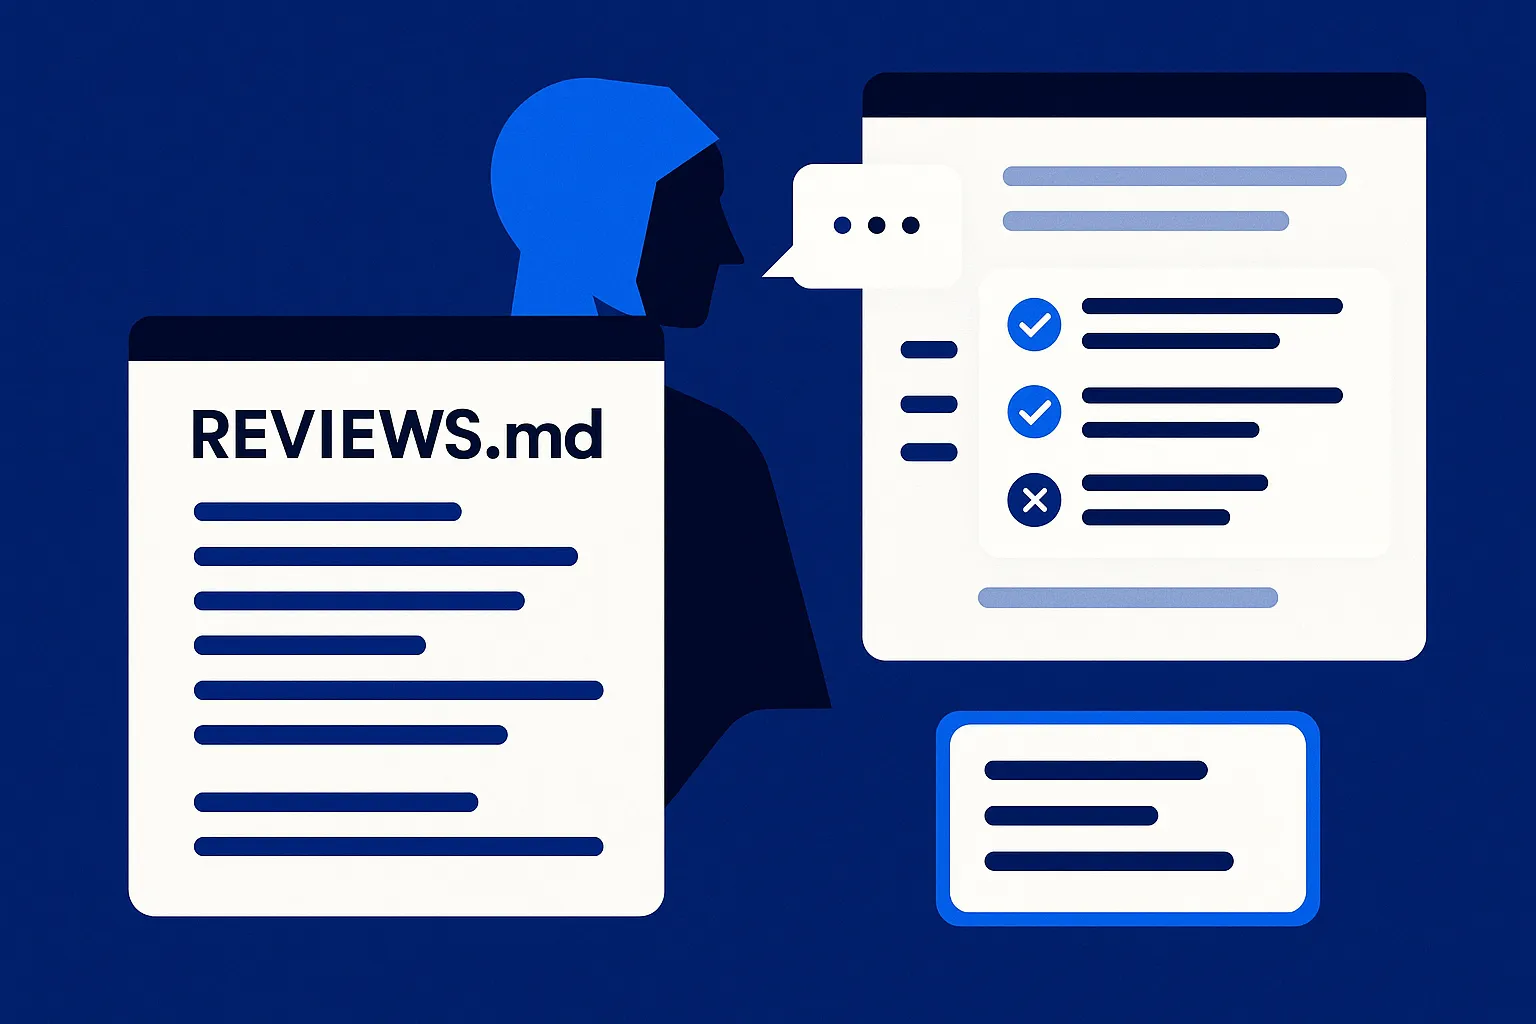
Agent do recenzji kodu, który do każdego repozytorium podchodzi z tą samą generyczną listą kontrolną, prędzej czy później zacznie marudzić nie o to, co trzeba. W jednym projekcie zespół pilnuje długości linii, w innym ma to w nosie, ale za to nie wybacza pochopnej obsługi błędów. Kilo, firma stojąca za rozszerzeniem do recenzji kodu, które nazwała tak samo jak siebie, ogłosiła trzy zmiany, które mają zamknąć tę lukę: plik REVIEWS.md z waszymi konwencjami, mechanizm uczący się tych konwencji z historii waszych komentarzy oraz lokalne podpowiedzi do recenzji jeszcze przed pushem.
Najprostsza z tych trzech rzeczy to REVIEWS.md. Jeśli zetknęliście się kiedyś z plikiem AGENT.md, czyli zwykłym Markdownem w korzeniu repozytorium, w którym spisuje się zasady dla agenta piszącego kod, to znacie ten układ, tyle że ten plik jest adresowany nie do agenta piszącego kod, lecz do agenta, który ten kod recenzuje. Wpisujecie tam swoje konwencje, preferencje stylu i decyzje architektoniczne, a kiedy włączycie automatyczne recenzje na GitHubie albo GitLabie, agent czyta plik i stosuje wasze reguły przy każdym przeglądzie. Repozytorium frontendu może egzekwować zupełnie inne zasady niż repozytorium infrastruktury, i żadne z nich nie musi dzielić konfiguracji z drugim. To rozsądny pomysł, choć trudno nazwać go odkrywczym, bo całą pracę i tak wykonujecie wy, siadając i spisując te reguły ręcznie.
I właśnie tę pracę ma zdjąć z was druga funkcja, Code Review Memory. Założenie jest takie, że większość waszych preferencji już istnieje, tyle że nie w żadnym pliku, lecz w tym, jak reagujecie na recenzje i pull requesty. Kiedy włączycie tę opcję, Kilo uruchamia analizę, która zbiera wasze odpowiedzi i uwagi do recenzji wystawionych przez ich agenta, a następnie generuje propozycję aktualizacji REVIEWS.md na podstawie tego, czego się z nich nauczyło. Przykład z ogłoszenia jest konkretny: jeśli wasz zespół raz po raz macha ręką na uwagi o długości linii, ale na komentarze o obsłudze błędów reaguje za każdym razem, agent ma to wychwycić i zaproponować przesunięcie uwagi tam, gdzie naprawdę ją kierujecie. Gdy analiza się kończy, dostajecie szczegółową propozycję zmian, a Kilo potrafi nawet wygenerować z niej pull request, który przeglądacie i mergujecie jak każdą inną zmianę. Wasze standardy recenzji zostają więc pod kontrolą wersji i widoczne dla całego zespołu, a wy, jak ujmuje to firma, nie musicie myśleć o tym, jak ma się zachowywać agent, bo on sam wyłapuje wasze skłonności z tego, jak faktycznie postępujecie.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.