SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Poradnik / Praktyka

Trzeci raz odrzucasz tę samą uwagę i agent przestaje ją powtarzać

Jerin Mathew Vinu zbudował agenta do code review, który zapamiętuje, które uwagi zespół akceptuje, a które odrzuca — po trzech kliknięciach Reject komentarz znika z czwartego PR-a. Pamięć trzyma Hindsight, recenzje generuje qwen3-32b przez Groq, a całość spina FastAPI. Kluczowa obserwacja: decyzje lądują w bazie jako jedno zdanie po angielsku, bo i tak wracają prosto do promptu — format zapisu warto dopasować do formatu odczytu. To weekendowy projekt bez pomiarów, ale wzorzec jest na tyle prosty, że można go sprawdzić u siebie.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Poradnik / Praktyka  ·  3 min  · 
Trzeci raz odrzucasz tę samą uwagę i agent przestaje ją powtarzać
Ilustrację przygotowała AI.

Jerin Mathew Vinu opisał na dev.to agenta, który czyta diff pull requesta, wystawia komentarze i, co najważniejsze, zapamiętuje, które z nich zespół akceptuje, a które systematycznie odrzuca. Jeśli trzy razy z rzędu odrzucisz komentarz "zamień print na logging", przy czwartym PR-ze agent już go nie pokaże. Z bota, który nuży, robi się coś, co przypomina starszego kolegę po pół roku pracy z waszym zespołem.

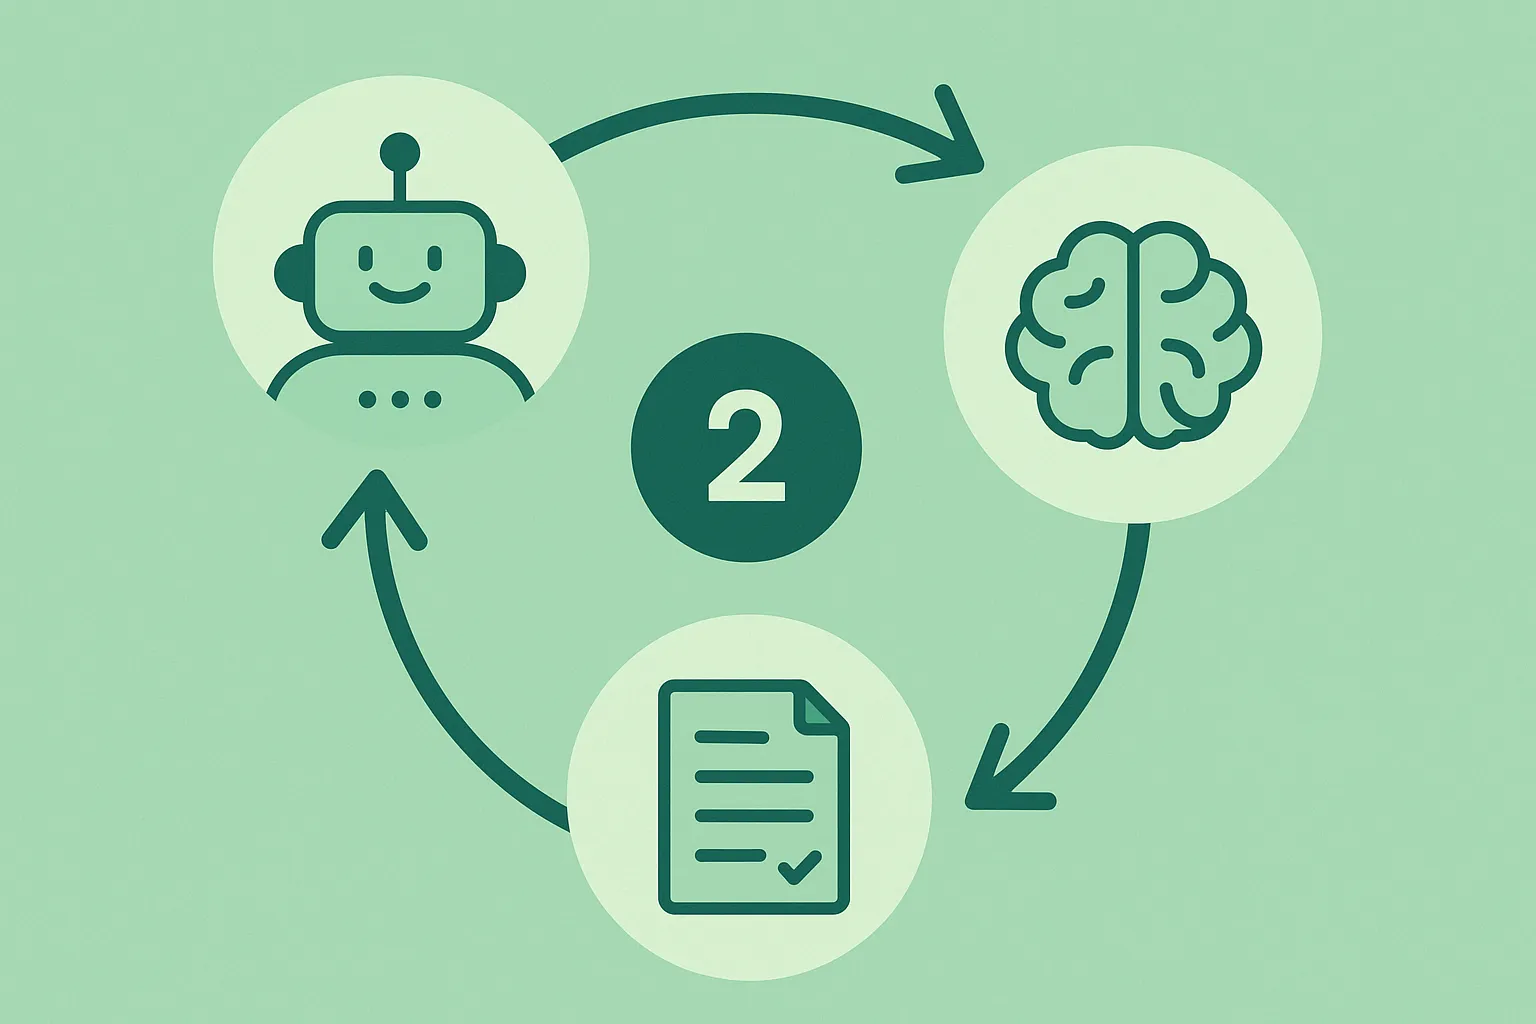
Pod spodem są trzy klocki. Pamięć trzyma Hindsight, recenzje generuje model qwen/qwen3-32b przez Groq, a całość spina FastAPI po stronie serwera. Cykl jednej recenzji wygląda tak: agent czyta historię decyzji zespołu z Hindsight, dokleja ją do diffu w prompcie do modelu i odbiera z powrotem JSON-a z komentarzami. Po każdym kliknięciu Accept albo Reject ta decyzja wraca do tej samej kolekcji w Hindsight. Pętla się domyka.

Każdy komentarz dostaje też jedną z czterech etykiet: krytyczny, ostrzeżenie, sugestia albo pochwała. Pochwała nie jest tu przypadkiem. Agent, który tylko strzela błędami, łatwo wyłączyć w głowie po piątym PR-ze. Jedno zdanie, że docstring jest dobrze napisany, zmienia ciężar pozostałych uwag.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Trzy agenty recenzują kod lepiej niż pięć
Analiza / Opinia

Trzy agenty recenzują kod lepiej niż pięć

3 min

Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.

Czy agent może nauczyć się waszych zasad code review z samych komentarzy w PR-ach?
Premiera / Narzędzie

Czy agent może nauczyć się waszych zasad code review z samych komentarzy w PR-ach?

4 min

Kilo wprowadziło trzy zmiany w swoim agencie do recenzji kodu: plik REVIEWS.md z konwencjami zespołu, mechanizm Code Review Memory uczący się reguł z historii waszych reakcji na uwagi oraz lokalne podpowiedzi w VS Code jeszcze przed pushem. Code Review Memory brzmi najciekawiej, ale uczy się z ubogiego sygnału, bo jedno kliknięcie Reject może oznaczać trzy różne rzeczy, więc jego propozycje warto traktować jak pull request od kogoś, kto zna projekt powierzchownie. Najbardziej przekonuje lokalna recenzja niezacommitowanych zmian, która oszczędza całą rundę przez CI.

Co się dzieje z uwagami, które wpisujesz agentowi tuż przed końcem sesji?
Premiera / Narzędzie

Co się dzieje z uwagami, które wpisujesz agentowi tuż przed końcem sesji?

5 min

Warp opisał u Anthropica układ dwóch umiejętności: bazowa trzyma zasady przeglądu kodu, a druga rusza z harmonogramu, zbiera uwagi ludzi i proponuje jedną małą poprawkę do pliku bazowego, która wchodzi zwykłym pull requestem. Publiczne demo z agentem porządkującym zgłoszenia pokazuje całą pętlę, a komenda Skill Doctor ocenia wcześniejsze rozmowy agenta i podsuwa gotowy diff. Kupuję ten wzorzec z jednym zastrzeżeniem: uwagi ludzi prawie zawsze mówią, czego agentowi zabrakło, więc plik SKILL.md tylko puchnie, a im dłuższy, tym gorzej agent trafia do właściwej wiedzy.