Premiera / Narzędzie
JetBrains otwiera KotlinLLM: model dopisuje kod, który zostaje w repo jak każdy inny
JetBrains Research udostępnił na licencji Apache 2.0 KotlinLLM, wtyczkę do IntelliJ IDEA, która odwraca podejście do modeli w gotowej aplikacji: wywołanie asLlm model uzupełnia kodem Kotlina dopiero przy nieobsłużonej sytuacji, a poprawkę podmienia w locie przez JDI. Gotowy kod ląduje w repozytorium jak każdy inny plik, więc na produkcji modelu już nie ma, a wywołanie LLM staje się jednorazowym kosztem z etapu pisania. W testach 24 scenariusze przeszły po dopracowaniu, ale sam JetBrains studzi zapał: to prototyp badawczy, nie środowisko produkcyjne.
Napisała AI, żeby oszczędzić Ci czytania setek źródeł. · Jak to działa
Premiera / Narzędzie · 3 min ·
Pomysł, który JetBrains Research pokazał pod koniec lipca, brzmi znajomo tylko przez pierwszą sekundę. W kodzie piszesz zwykłe wywołanie funkcji, na przykład asLlm(response, hint = "zwróć wszystkie zgłoszenia dobre dla początkujących"), a ciało tej funkcji dopisuje model, prawdziwym kodem Kotlina. Do tego momentu nie ma w tym nic nowego, tak działa dziś połowa edytorów. Właściwa różnica jest w tym, co dzieje się potem: wygenerowany kod trafia do repozytorium jako zwykły plik Kotlina, a samo wywołanie modelu z działającej aplikacji znika. I to, a nie generowanie kodu, jest tu naprawdę interesujące. Całość nazywa się KotlinLLM, to wtyczka do IntelliJ IDEA dla projektów Kotlin/JVM, otwarta na licencji Apache 2.0.
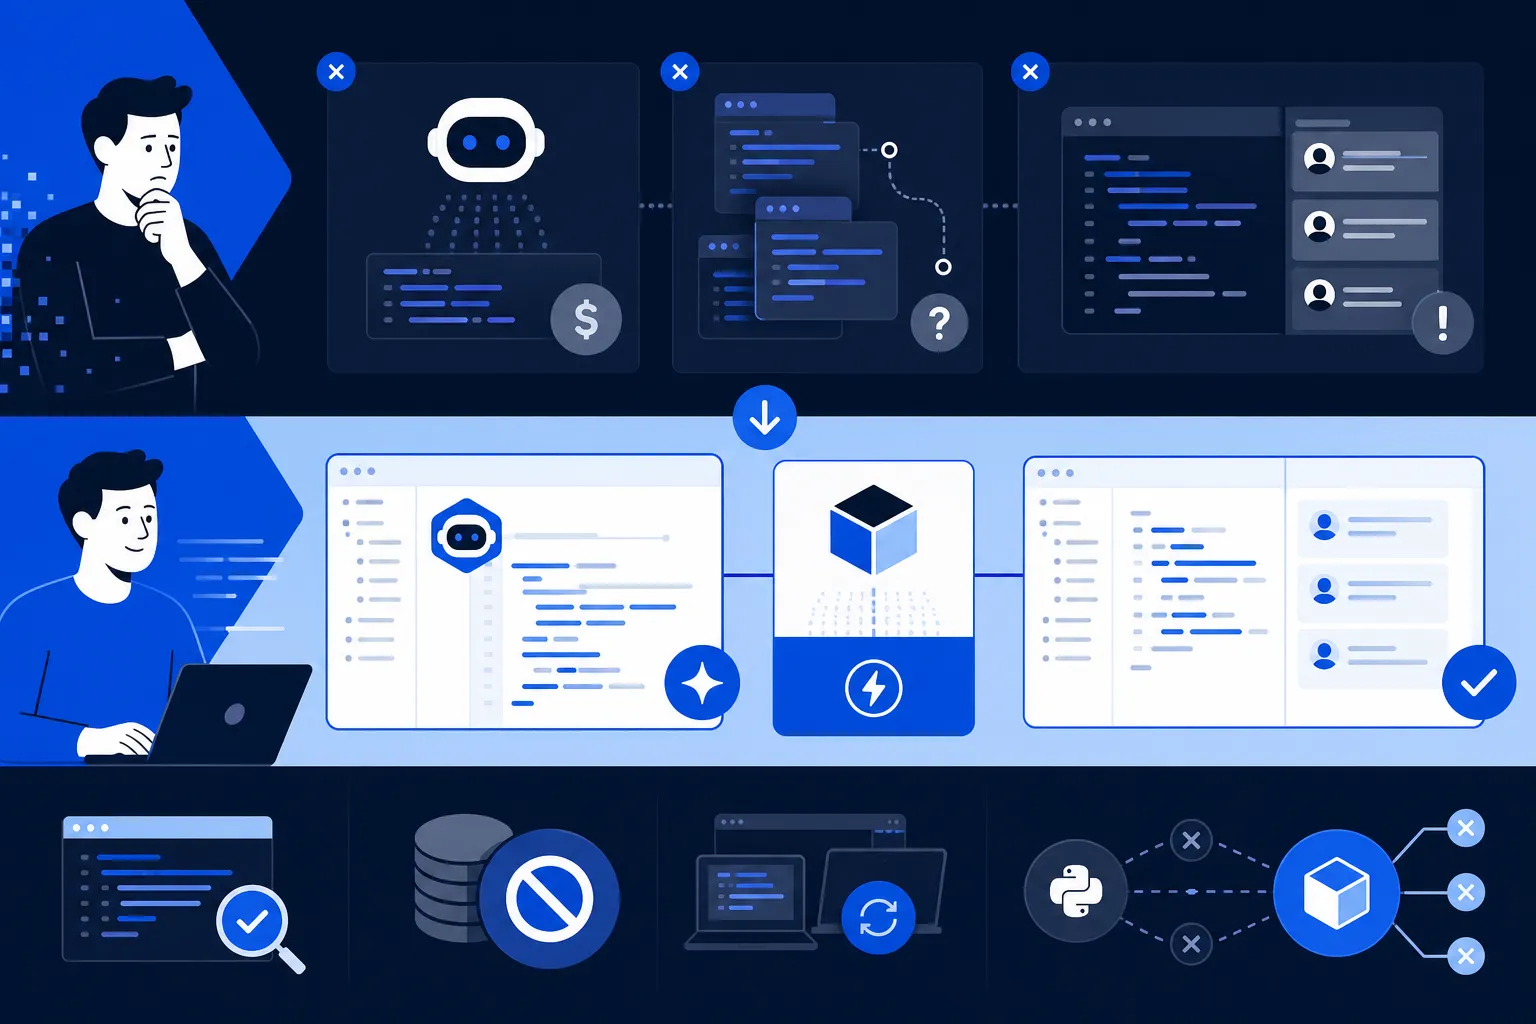
Dlaczego to w ogóle problem? Bo użycie modelu w trakcie działania gotowej aplikacji, a nie podczas jej pisania, do tej pory wyglądało kiepsko na każdy z trzech sposobów, które wylicza JetBrains. Można odpytywać model wprost przy każdym żądaniu, ale to wolne, nieprzewidywalne, kosztowne i na zawsze uzależnia aplikację od zewnętrznej usługi. Można wypchnąć logikę do osobnego agenta, tyle że wtedy ląduje ona poza kodem, gdzie trudniej ją przejrzeć, przetestować i wydać. Można wreszcie generować potrzebny kod w locie, tak jak robiły wcześniejsze prace badawcze, tyle że te celowały w języki interpretowane w rodzaju Pythona i nie radziły sobie ze skompilowanym, statycznie typowanym Kotlinem.
Sztuczka KotlinLLM polega na tym, że model dopisuje kod dopiero wtedy, gdy naprawdę jest potrzebny, i robi to jednorazowo. Gdy uruchamiasz projekt przez konfigurację wtyczki, skanuje ona kod w poszukiwaniu wywołań asLlm i odpala aplikację pod JDI, mechanizmem debugowania JVM, który pozwala podmienić kod załadowanej klasy bez restartu. Dopóki wygenerowana logika radzi sobie z tym, co przychodzi, nic się nie dzieje. Kiedy trafia na sytuację, której nie obsługuje, wykonanie zatrzymuje się na wcześniej ustawionym breakpoincie. Wtyczka odczytuje wtedy z zamrożonej ramki rzeczywiste wartości i ich typy, agent proponuje na tej podstawie poprawkę, a wtyczka kompiluje ją i podmienia klasę w locie, zanim ponowi pierwotne wywołanie. Kotlin/JVM nie jest tu przypadkiem, bo cała ta pętla stoi na podmianie załadowanych klas przez JDI.
Czytaj dalej za darmo
Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.