SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Poradnik / Praktyka

Nowy cookbook Llamy to nie premiera, tylko uporządkowanie i jeden czytelny sygnał

Meta przemianowała repozytorium llama-recipes na llama-cookbook i przebudowała je od środka, ale to nie premiera, tylko zebranie w jednym miejscu trzech podstaw pracy z modelami Llama: inferencji, fine-tuningu i RAG. Prawdziwym sygnałem są wyróżnione na górze przepisy dla Llamy 4, gdzie wariant Scout dostaje okno kontekstowe 5 milionów tokenów, a Maverick analizator prac naukowych i bota na WhatsAppie. To pokazuje, do czego Meta faktycznie szykuje swój model, czyli długi kontekst i analiza dokumentów, a nie walka o czołowe miejsce w benchmarkach programistycznych.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Poradnik / Praktyka  ·  3 min  · 
Nowy cookbook Llamy to nie premiera, tylko uporządkowanie i jeden czytelny sygnał
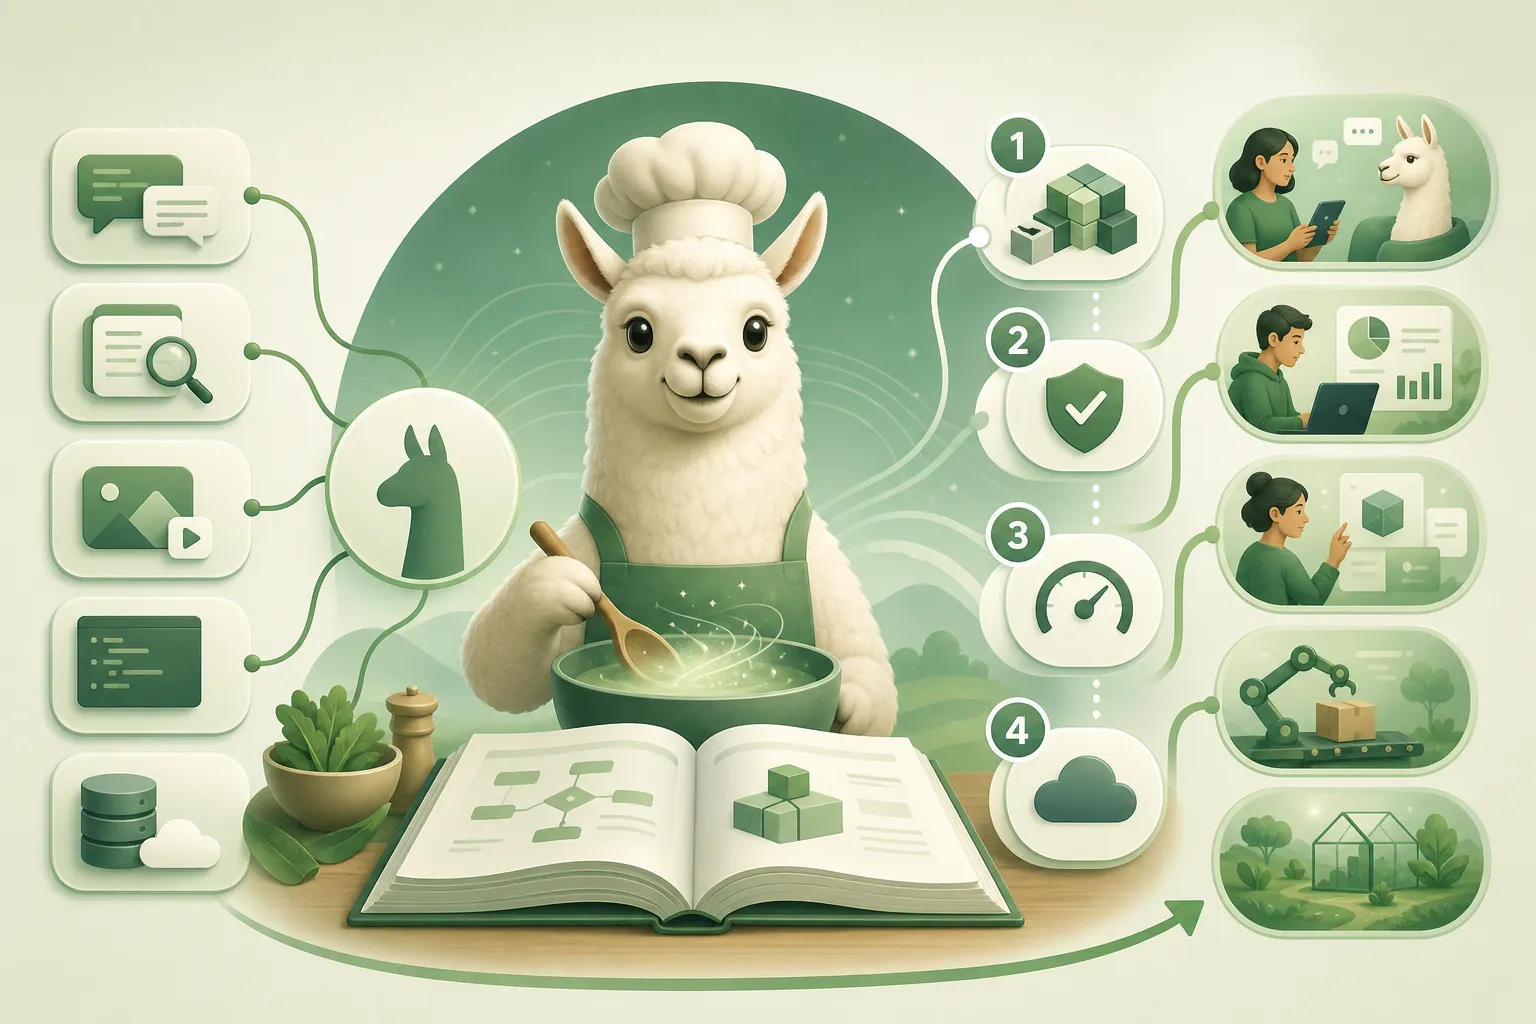
Ilustrację przygotowała AI.

Meta przemianowała swoje repozytorium llama-recipes na llama-cookbook i przy okazji przebudowała je od środka. Brzmi to jak kosmetyka, ale sama zmiana nazwy coś zdradza. Książka kucharska jest po to, żeby ktoś, kto ma składniki, wiedział, jak ugotować z nich obiad. Zwykle całą uwagę przyciąga sam model, jego rozmiar i wyniki w testach. Sama zmiana nazwy sugeruje, że surowy model Llama to dopiero składnik, a to, co realnie interesuje programistę, kryje się w przepisach.

Llama to rodzina otwartych modeli językowych Mety, które można pobrać i uruchomić samodzielnie, w odróżnieniu od zamkniętych modeli pokroju GPT czy Claude, dostępnych wyłącznie przez API.

Repozytorium, o którym mowa, jest oficjalnym punktem wyjścia do budowania aplikacji na tej rodzinie modeli. Zbiera w jednym miejscu trzy podstawy, które trzeba ogarnąć, zanim cokolwiek powstanie: inferencję, czyli samo uruchamianie modelu i wyciąganie z niego odpowiedzi, fine-tuning, czyli dostrajanie modelu do własnych danych, żeby lepiej radził sobie z konkretnym zadaniem, oraz RAG, czyli sięganie w trakcie odpowiedzi po zewnętrzne dokumenty, zamiast polegania wyłącznie na tym, co model zapamiętał podczas trenowania.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Co zmienia llm 0.31: dwie flagi, cicha poprawka i nowy model OpenAI
Premiera / Narzędzie

Co zmienia llm 0.31: dwie flagi, cicha poprawka i nowy model OpenAI

3 min

Wersja 0.31 narzędzia llm Simona Willisona, wydana 24 kwietnia, dorzuca dwie flagi do wtyczki OpenAI: `-o verbosity low` ścisza model bez wpychania instrukcji do promptu, a osobny przełącznik decyduje, jak dokładnie API ogląda obrazek, z nową wartością `original` dla GPT-5.4 i 5.5. Pod spodem modele z `extra-openai-models.yaml` rejestrują się też jako asynchroniczne, więc własny serwer na vLLM albo Groq wystarczy wpisać raz. Dla skryptów przepuszczających setki zapytań to konkretna kontrola nad tokenami i kosztami.

JetBrains otwiera KotlinLLM: model dopisuje kod, który zostaje w repo jak każdy inny
Premiera / Narzędzie

JetBrains otwiera KotlinLLM: model dopisuje kod, który zostaje w repo jak każdy inny

3 min

JetBrains Research udostępnił na licencji Apache 2.0 KotlinLLM, wtyczkę do IntelliJ IDEA, która odwraca podejście do modeli w gotowej aplikacji: wywołanie asLlm model uzupełnia kodem Kotlina dopiero przy nieobsłużonej sytuacji, a poprawkę podmienia w locie przez JDI. Gotowy kod ląduje w repozytorium jak każdy inny plik, więc na produkcji modelu już nie ma, a wywołanie LLM staje się jednorazowym kosztem z etapu pisania. W testach 24 scenariusze przeszły po dopracowaniu, ale sam JetBrains studzi zapał: to prototyp badawczy, nie środowisko produkcyjne.

Podręcznik dostrajania modeli, do którego trzeba się najpierw zapisać
Premiera / Narzędzie

Podręcznik dostrajania modeli, do którego trzeba się najpierw zapisać

4 min

Thinking Machines Lab udostępniło na GitHubie tinker-cookbook, otwartą bibliotekę dziewięciu gotowych receptur na dostrajanie modeli językowych, od trójstopniowego RLHF, przez destylację, po dane audio i modele wizualno-językowe. Kod jest otwarty, ale silnik pod spodem, Tinker, chodzi na serwerach firmy w zamkniętej becie, więc żeby cokolwiek uruchomić, trzeba poprosić o dostęp i czekać. W zestawie jest też framework do oceny z dwunastoma benchmarkami i dwie umiejętności dla Claude Code. Bliżej temu do podręcznika podpiętego pod lejek do API niż do narzędzia, które każdy odpala po południu.