SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Analiza / Opinia

Recenzent trafił w linijkę z podatnością i jej nie nazwał

Agent recenzujący kod trafił w linijkę, w której adres od użytkownika szedł prosto do Kernel#open w Rubym, ale nie nazwał podatności, bo zabrakło mu wiedzy o jednej funkcji z biblioteki standardowej Ruby. Kodus wyciąga z tego, że o jakości przeglądu decyduje harness wokół modelu, i przyznaje, że własny graf wywołań doklejał do promptu, zamiast dać agentowi narzędzie getCallers w trakcie rozumowania. Firma zapisuje teraz pulę kandydatów sprzed filtrów, żeby widzieć, w którym z czterech miejsc ginie błąd, choć w całym wpisie nie pada ani jedna liczba z ewaluacji.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Analiza / Opinia  ·  4 min  · 
Recenzent trafił w linijkę z podatnością i jej nie nazwał
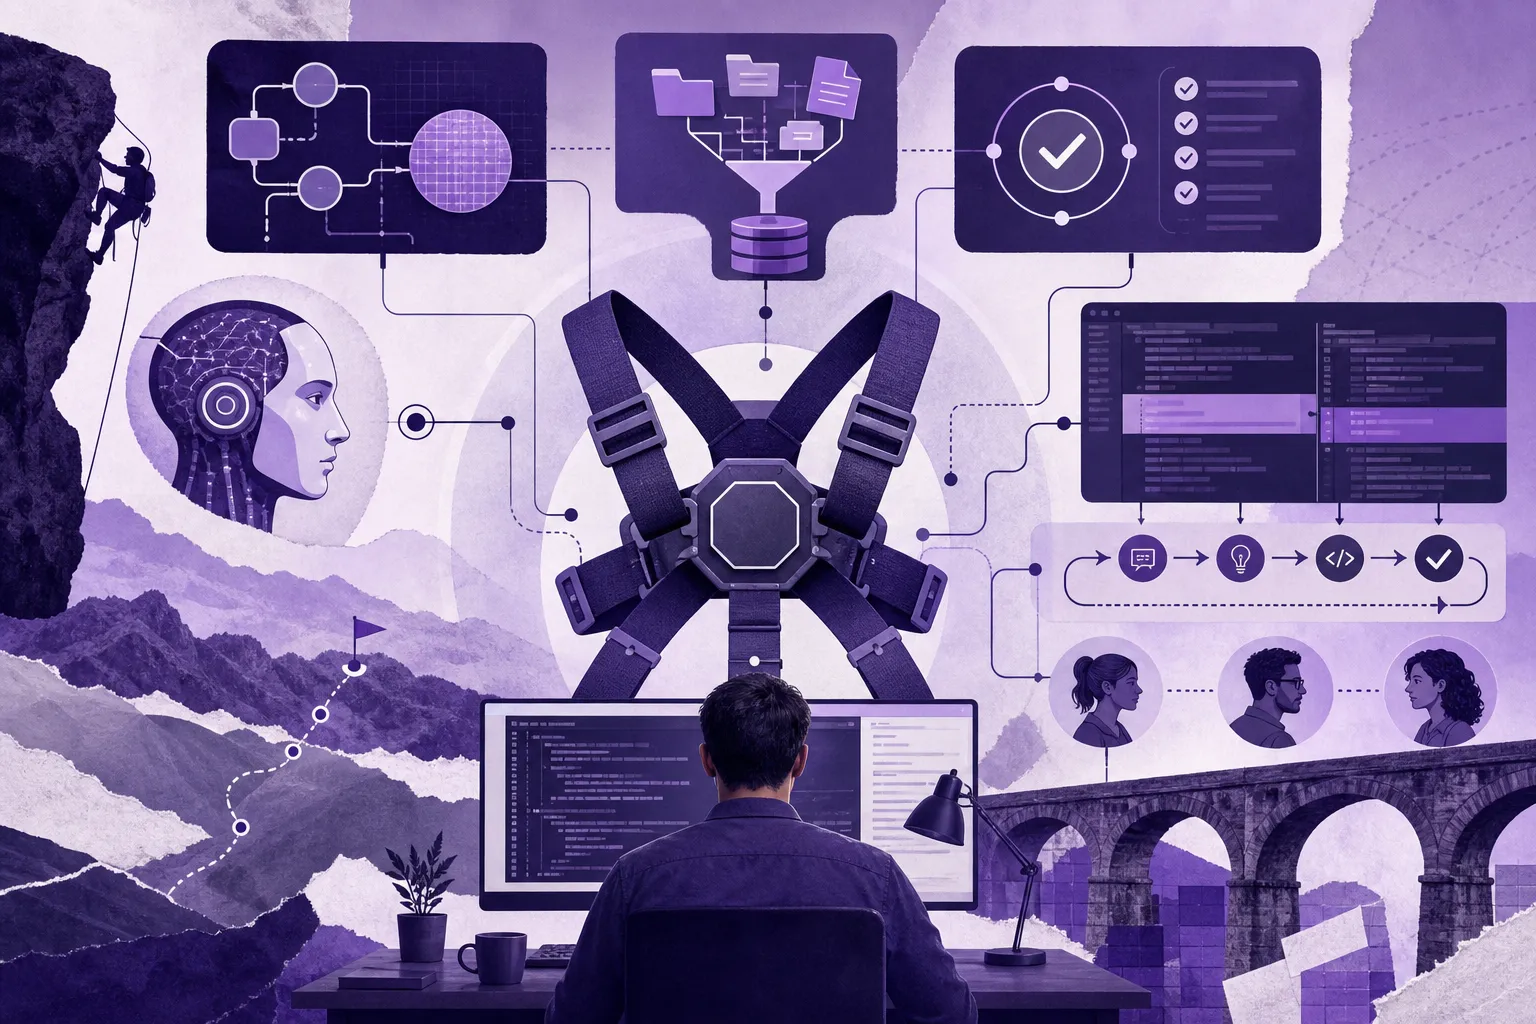
Ilustrację przygotowała AI.

Pull request przepuszczał adres URL podany przez użytkownika prosto do Kernel#open w Rubym. Agent sprawdzający tę zmianę trafił dokładnie w tę linijkę, prześledził wartość aż do miejsca, w którym wpisuje ją użytkownik, i zgłosił nawet kilka uwag do sąsiedniego kodu. Nie nazwał tylko rzeczy najważniejszej: Kernel#open potrafi w tym kontekście otworzyć połączenie sieciowe, więc atakujący może kazać serwerowi wysłać żądanie pod dowolny adres.

Dosypanie modelowi reszty repozytorium nic by nie dało, bo właściwy kod miał już przed sobą, a prośba o uważniejszą lekturę diffa najpewniej skończyłaby się kolejnym pewnym siebie przebiegiem po tych samych linijkach. Zabrakło wiedzy o jednej funkcji z biblioteki standardowej Ruby.

Kodus, firma budująca własny silnik do przeglądu kodu, opisał ten nieudany przegląd na blogu jako moment, po którym w firmie przestali odpowiadać zmianą modelu na każdy przeoczony błąd. Kupuję tę diagnozę: model pracuje wewnątrz większego systemu, który buduje mu prompt, podaje narzędzia i decyduje, kiedy przegląd się kończy. Ten system nazywa się harness i przy przeglądzie kodu często waży na wyniku tyle samo, co same wagi modelu.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Recenzent nie pomylił się ani razu i to był problem Poradnik / Praktyka

Recenzent nie pomylił się ani razu i to był problem

5 min

Automatyczny recenzent Codex w projekcie AgentCoop nie pomylił się ani razu, a mimo to sześć rund recenzji rozdęło funkcję z 28 do 42 linii, bo zasada „każda uwaga załatwiona przed mergem” po cichu zmieniła się w „każdą poprawiamy”, a tak kończyło się 91% uwag. Zespół odpowiedział procedurą liczącą koszt w godzinach zamiast etykietek P1 i P2 oraz skryptem chain-check, który zatrzymuje pracę, gdy dwie rundy z rzędu trafiają w kod napisany pod wcześniejszą uwagę tego samego recenzenta. Arytmetyki nie kupuję, ale ktoś wreszcie spisał drugą stronę rachunku, czyli to, co naprawdę traci użytkownik.

Trzy agenty recenzują kod lepiej niż pięć Analiza / Opinia

Trzy agenty recenzują kod lepiej niż pięć

3 min

Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.

Trzeci raz odrzucasz tę samą uwagę i agent przestaje ją powtarzać Poradnik / Praktyka

Trzeci raz odrzucasz tę samą uwagę i agent przestaje ją powtarzać

3 min

Jerin Mathew Vinu zbudował agenta do code review, który zapamiętuje, które uwagi zespół akceptuje, a które odrzuca — po trzech kliknięciach Reject komentarz znika z czwartego PR-a. Pamięć trzyma Hindsight, recenzje generuje qwen3-32b przez Groq, a całość spina FastAPI. Kluczowa obserwacja: decyzje lądują w bazie jako jedno zdanie po angielsku, bo i tak wracają prosto do promptu — format zapisu warto dopasować do formatu odczytu. To weekendowy projekt bez pomiarów, ale wzorzec jest na tyle prosty, że można go sprawdzić u siebie.