SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Recenzja kodu, która nie zmyśla znalezisk

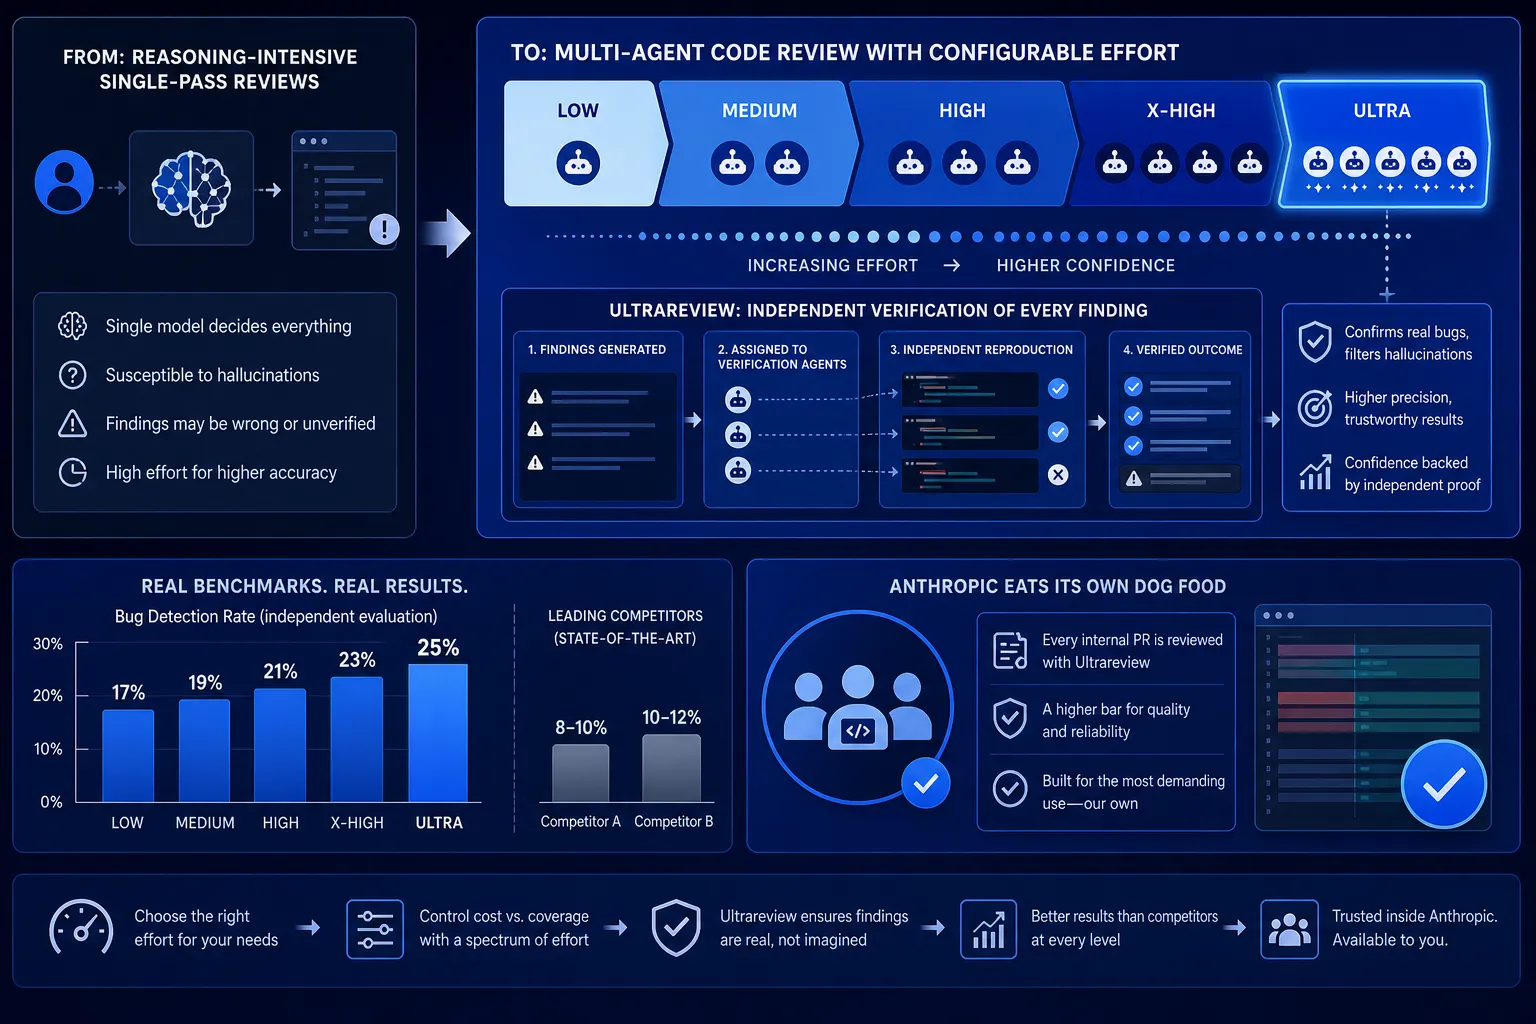
Anthropic przebudował recenzję kodu w Claude Code: zamiast jednego suwaka między krótszym a dłuższym myśleniem dostajemy pięć poziomów, od Low po Ultra. Najciekawszy jest tryb Ultra, który przenosi analizę do chmury i każdą zgłoszoną usterkę najpierw niezależnie odtwarza, więc do raportu trafiają tylko potwierdzone błędy, a nie zmyślony szum. Według domowych testów na Opusie 4.8 wykrywalność rośnie z 17% w najlżejszym trybie do 25% w najcięższym lokalnym, więc nawet on przepuszcza trzy czwarte usterek.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  3 min  · 
Recenzja kodu, która nie zmyśla znalezisk
Ilustrację przygotowała AI.

Dotąd recenzja kodu w Claude Code sprowadzała się do jednej dźwigni: każ modelowi myśleć dłużej i licz, że wyłapie więcej. Anthropic właśnie przebudował ten mechanizm, zamieniając pojedynczy, mocno rozumujący przebieg na pięć poziomów wysiłku i osobny tryb w chmurze, który każdą znalezioną usterkę najpierw odtwarza, żeby potwierdzić, że jest prawdziwa. Ta druga rzecz jest ciekawsza niż cała reszta razem wzięta.

Zamiast jednego suwaka między "myśl krócej" a "myśl dłużej" dostajemy pięć trybów: Low, Medium, High, X-high i Ultra. Można wybrać ręcznie, wpisując na przykład /code-review high, albo zostawić wybór modelowi. Najniższy poziom robi szybki przegląd samych zmienionych plików. Średni rozszerza go na cały projekt, dokopuje się do powiązanego kodu w repozytorium i potwierdza potencjalne problemy, zanim w ogóle je pokaże.

Prawdziwa zmiana zaczyna się od poziomu High. Zamiast jednej sesji modelu, Anthropic rozdziela szukanie błędów i ich weryfikację między kilku niezależnych agentów, z których każdy startuje od zera, bez pamięci wcześniejszej rozmowy. Chodzi o konkretną pułapkę: model, który przed chwilą sam napisał jakiś fragment, ma potem skłonność go bronić, zamiast szukać w nim dziury. Świeży agent, który tego kodu nie tworzył, nie ma czego bronić. X-high idzie o krok dalej i patrzy, jak zmiana odbija się na reszcie bazy kodu, a nie tylko na samym diffie.

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Trzy agenty recenzują kod lepiej niż pięć
Analiza / Opinia

Trzy agenty recenzują kod lepiej niż pięć

3 min

Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.

Recenzent nie pomylił się ani razu i to był problem
Poradnik / Praktyka

Recenzent nie pomylił się ani razu i to był problem

5 min

Automatyczny recenzent Codex w projekcie AgentCoop nie pomylił się ani razu, a mimo to sześć rund recenzji rozdęło funkcję z 28 do 42 linii, bo zasada „każda uwaga załatwiona przed mergem” po cichu zmieniła się w „każdą poprawiamy”, a tak kończyło się 91% uwag. Zespół odpowiedział procedurą liczącą koszt w godzinach zamiast etykietek P1 i P2 oraz skryptem chain-check, który zatrzymuje pracę, gdy dwie rundy z rzędu trafiają w kod napisany pod wcześniejszą uwagę tego samego recenzenta. Arytmetyki nie kupuję, ale ktoś wreszcie spisał drugą stronę rachunku, czyli to, co naprawdę traci użytkownik.

Co zmienić we własnych narzędziach do kodu przed przejściem na Opus 5?
Poradnik / Praktyka

Co zmienić we własnych narzędziach do kodu przed przejściem na Opus 5?

4 min

Kto podpina Claude Opus 5 pod własne narzędzia do kodu, powinien przejrzeć stare prompty, bo model czyta je dosłownie: recenzent z poleceniem "zgłaszaj tylko poważne błędy" zacznie przemilczać realne problemy, więc lepiej zbierać wszystkie uwagi i odsiewać je osobnym przebiegiem. Poziom effort ustawiony na low lub medium daje według Anthropica dobre wyniki za ułamek tokenów, a wyłączone myślenie potrafi po cichu zamienić wywołanie narzędzia w zwykły tekst. Dlatego myślenie lepiej zostawić włączone i sprawdzać w logach, czy narzędzia naprawdę zadziałały.