SmartDigest.ai Tworzone przez AI, żeby nadążyć za AI
Zapisz się

Zapisz się do newslettera

Co tydzień najważniejsze newsy AI prosto na Twój e-mail. Wybierz tematy, które Cię interesują.

Premiera / Narzędzie

Z pięciu wzorców Warpa tylko dwa są naprawdę równoległe

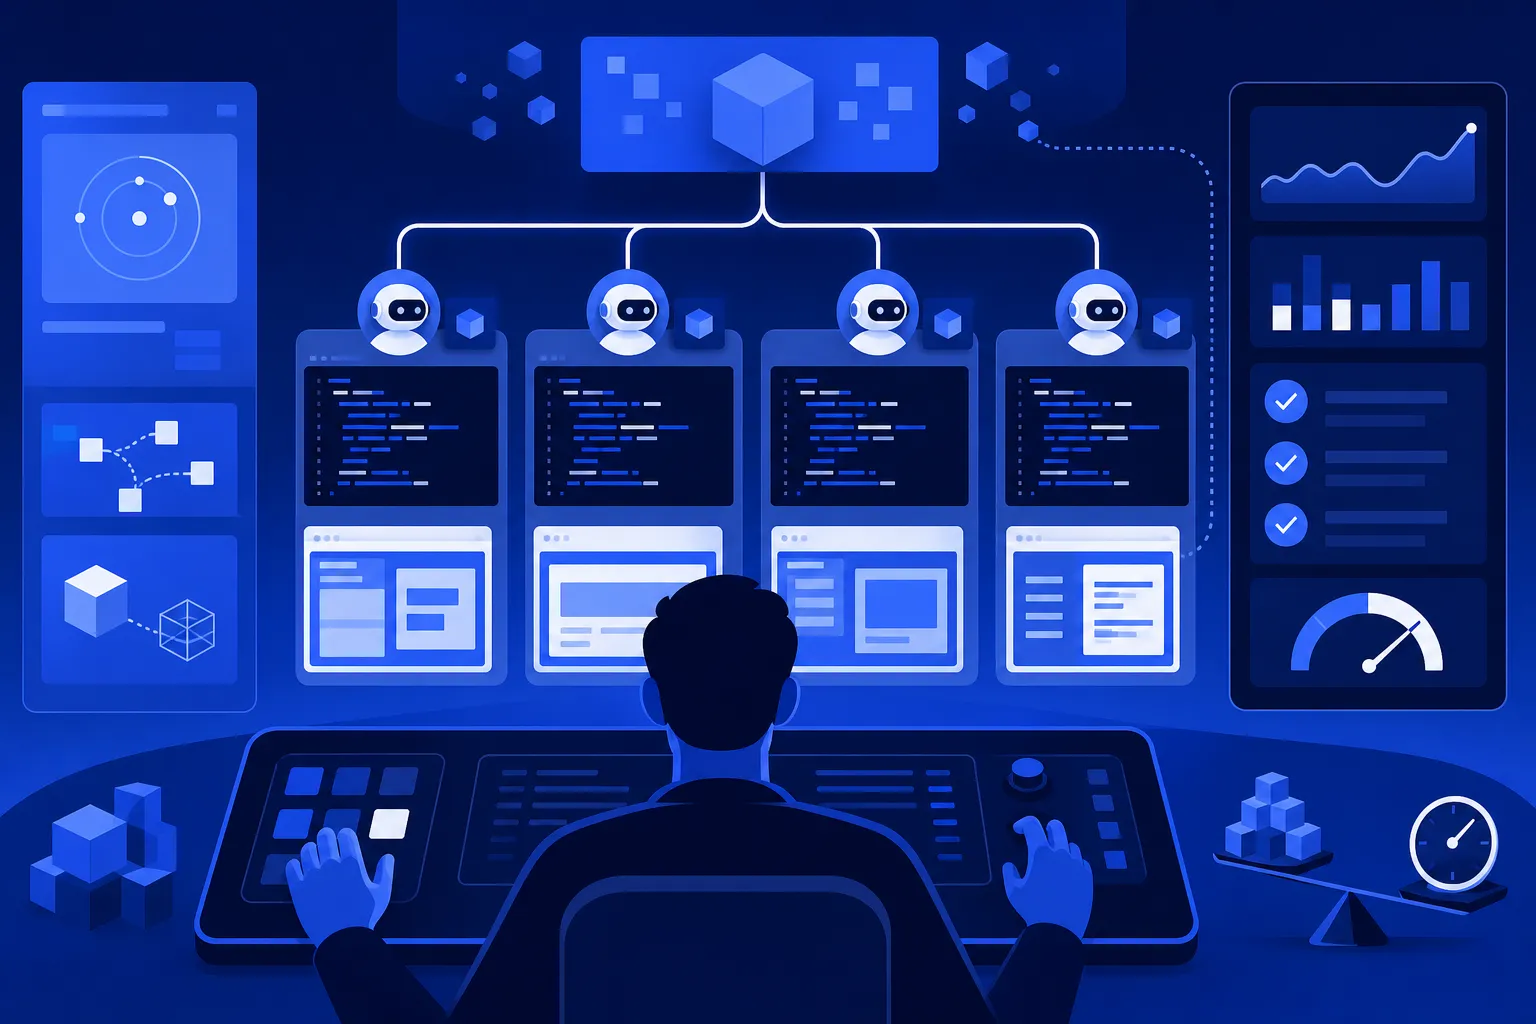
Z pięciu wzorców pracy z wieloma agentami w poradniku Warpa realną równoległość dają tylko dwa: podział zadań po modułach i rozrzucenie roboty po agentach w chmurze poleceniem /orchestrate. Dwa agenty przy tym samym zadaniu albo para, w której jeden pisze, a drugi recenzuje, to sekwencja, w której całą wartość wnosi twoje czytanie dwóch wersji kodu. Sufit ustawia repozytorium, a nie terminal, bo granice między modułami muszą istnieć w kodzie, zanim odpalisz pierwszą sesję.

Napisała AI, żeby oszczędzić Ci czytania setek źródeł.  ·  Jak to działa

Premiera / Narzędzie  ·  4 min  · 
Z pięciu wzorców Warpa tylko dwa są naprawdę równoległe
Ilustrację przygotowała AI.

Warp, terminal z wbudowanym agentem, każe zacząć od rzeczy najbardziej prozaicznej: przestawienia kart z poziomych na pionowe. Dopiero wtedy przy każdej sesji widać, który agent w niej pracuje, na jakiej gałęzi, w którym katalogu i czy właśnie liczy, czeka na twoją zgodę, czy już skończył. Tyle że to jest porządek na ekranie, a nie praca kilku agentów naraz. O tej różnicy decyduje coś zupełnie innego niż terminal.

Tydzień temu rozpisywałem tu pięć linijek, które poradnik Warpa każe wkleić każdemu agentowi na starcie sesji. Teraz chcę wrócić do tabelki, od której poradnik się zaczyna, bo widać w niej coś, o czym reszta tekstu mówi półgębkiem: z pięciu zestawionych tam wzorców pracy z wieloma agentami realną równoległość dają tylko dwa.

Dwa agenty na to samo zadanie to nie równoległość

Czytaj dalej za darmo

Podaj e-mail, aby odblokować pełną treść i cały serwis. Zapiszemy Cię do newslettera.
Powiązane

Pięć linijek, które piszesz, zanim odpalisz drugiego agenta
Poradnik / Praktyka

Pięć linijek, które piszesz, zanim odpalisz drugiego agenta

4 min

Poradnik Warpa o pracy z kilkoma agentami naraz sprowadza się do pięciu linijek wklejanych każdej sesji na start: kto odpowiada za które katalogi, na jakiej gałęzi pracuje i co ma zameldować na koniec. Warp rozpisuje to na osiem kroków, sadza każdego agenta we własnym worktree i wprost zabrania automatycznego scalania, bo cudzy błąd łapiesz tylko przy przeglądzie. Chmurowe polecenie /orchestrate zostawiłbym na migracje monorepo, bo poradnik nie podaje ani kosztu, ani oszczędności, a cztery agenty skracają czas pisania kodu i wydłużają czas jego czytania.

Trzy agenty recenzują kod lepiej niż pięć
Analiza / Opinia

Trzy agenty recenzują kod lepiej niż pięć

3 min

Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.

Cursor stawia nad agentami koordynatora, który sam nie tyka kodu
Premiera / Narzędzie

Cursor stawia nad agentami koordynatora, który sam nie tyka kodu

4 min

Cursor wypuścił 10 września betę Projects: koordynator pracuje na osobnej maszynie w chmurze, sam nie tyka kodu, tylko rozsyła zadania podległym agentom, a projekt pamięta, czego się nauczyły, więc kolejny agent nie zaczyna od pustej kartki. Firma chwali się sześciokrotnie większą liczbą zmergeowanych pull requestów, ale nie podała ani wielkości grup, ani okresu pomiaru, a narzędzie rozbijające tę samą pracę na kilkanaście wątków z definicji pokaże więcej zamkniętych kawałków. Wąskim gardłem robi się wtedy ludzki przegląd kodu, więc przed pierwszym uruchomieniem warto ustawić limit wydatków.