Programowanie AI
Format umiejętności dla agentów dostał własną specyfikację i otwartą licencję
4 min
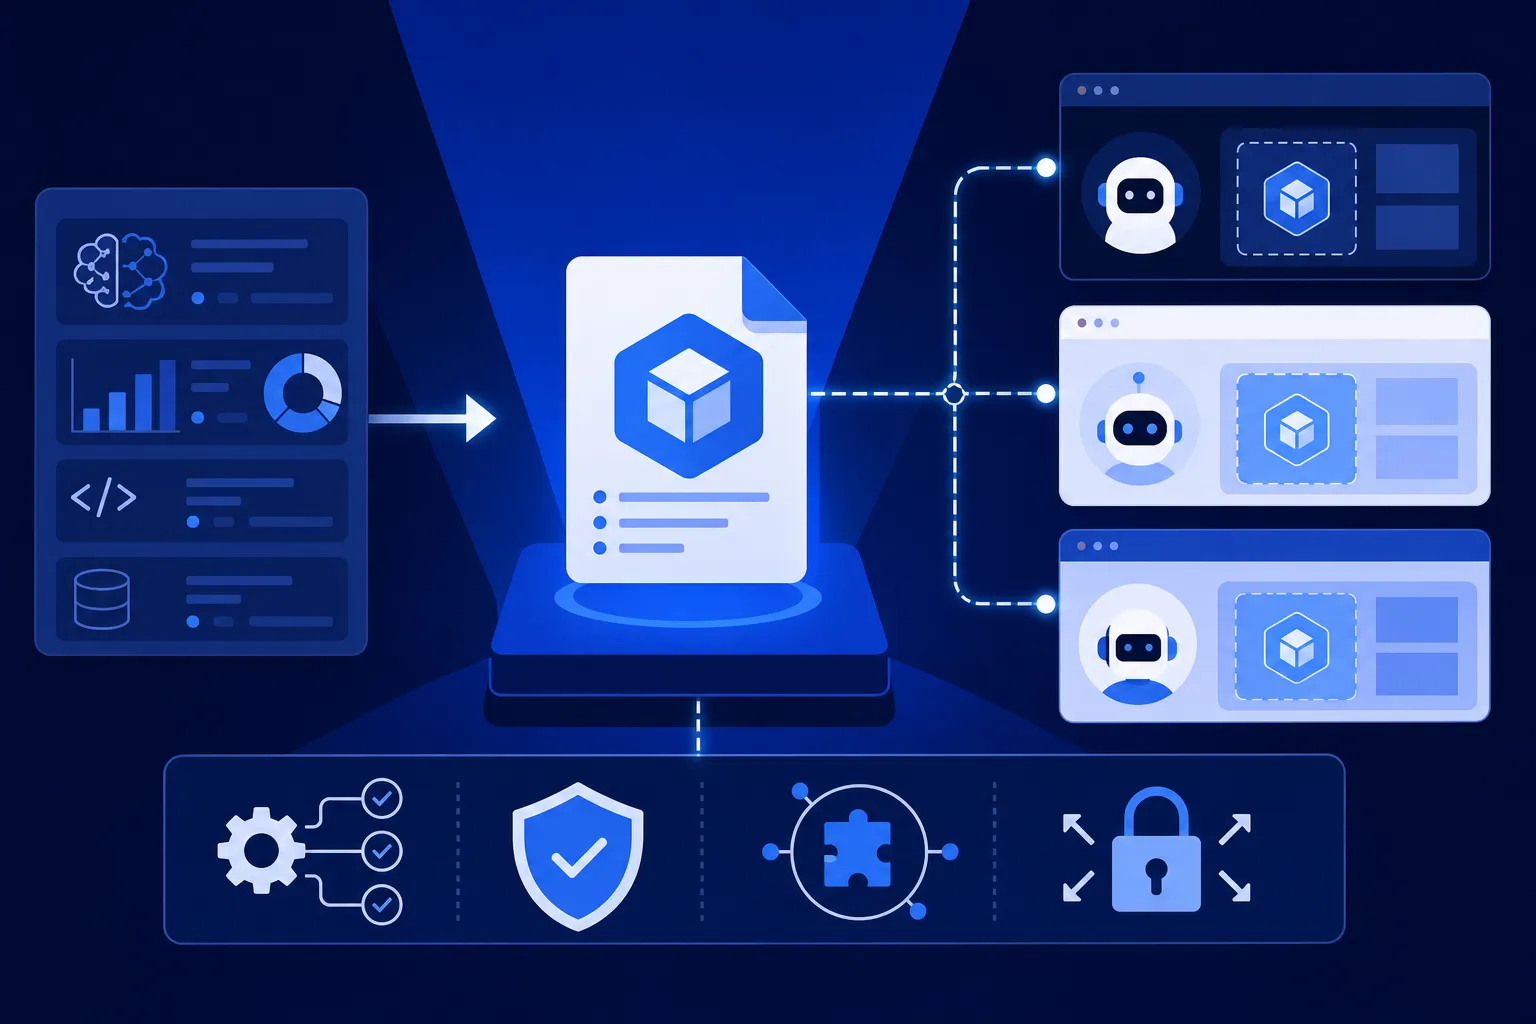
Format umiejętności agenta, w którym cała procedura mieści się w jednym pliku SKILL.md, dostał własną specyfikację, licencję Apache 2.0 i formalny proces zgłaszania zmian. Sztuczką jest progressive disclosure: agent widzi na starcie tylko nazwy i opisy, a pełną treść wczytuje dopiero wtedy, gdy zadanie pasuje, więc może mieć pod ręką setkę umiejętności, trzymając w pamięci jedną. Anthropic oddał format jako otwarty standard, tak jak wcześniej MCP, ale repozytorium chwali się "rosnącą liczbą" produktów bez podania ani jednej konkretnej liczby.
Prawie 100% na benchmarku, którego jedna trzecia nie działała
4 min
OpenAI w lutym namawiało branżę na SWE-bench Pro, a w lipcu wycofało własną rekomendację, bo ludzki przegląd uznał 34,1% zadań za zepsute. Głośne „prawie 100%" ze Stanford AI Index to wynik przeskalowany względem poziomu odniesienia, a nie odsetek rozwiązanych zgłoszeń — surowo najlepszy model ruszył z 74,9% do 80,9%. Benchmarki psują się przez skażenie danych treningowych i wadliwe testy odrzucające poprawny kod. Zanim uwierzysz w tabelę, sprawdź, którą wersję testu i który wynik mierzy, a potem i tak puść model na własnym repozytorium.
Anthropic każe wyciąć z promptów to, co kiedyś wymuszało dokładność
4 min
Anthropic odświeżył firmowy przewodnik po promptowaniu i większość pracy przy przenoszeniu starych promptów polega teraz na wycinaniu, nie dopisywaniu. Kategoryczne "KRYTYCZNE: MUSISZ" i pisanie wielkimi literami w najnowszych modelach, od Fable 5 po Opus 4.8, zaczynają szkodzić, bo model bierze je zbyt dosłownie. Prefill na końcu rozmowy i parametr budget_tokens zwracają już twardy błąd 400 na Opus 4.7 i nowszych, więc głębokością namysłu steruje się teraz parametrem effort. Przy długich zadaniach rada jest prosta: stan trzymaj poza kontekstem, na dysku, w plikach i w gicie.
Model wymieniasz jedną linijką, całą resztę wynajmujesz od Vercela
4 min
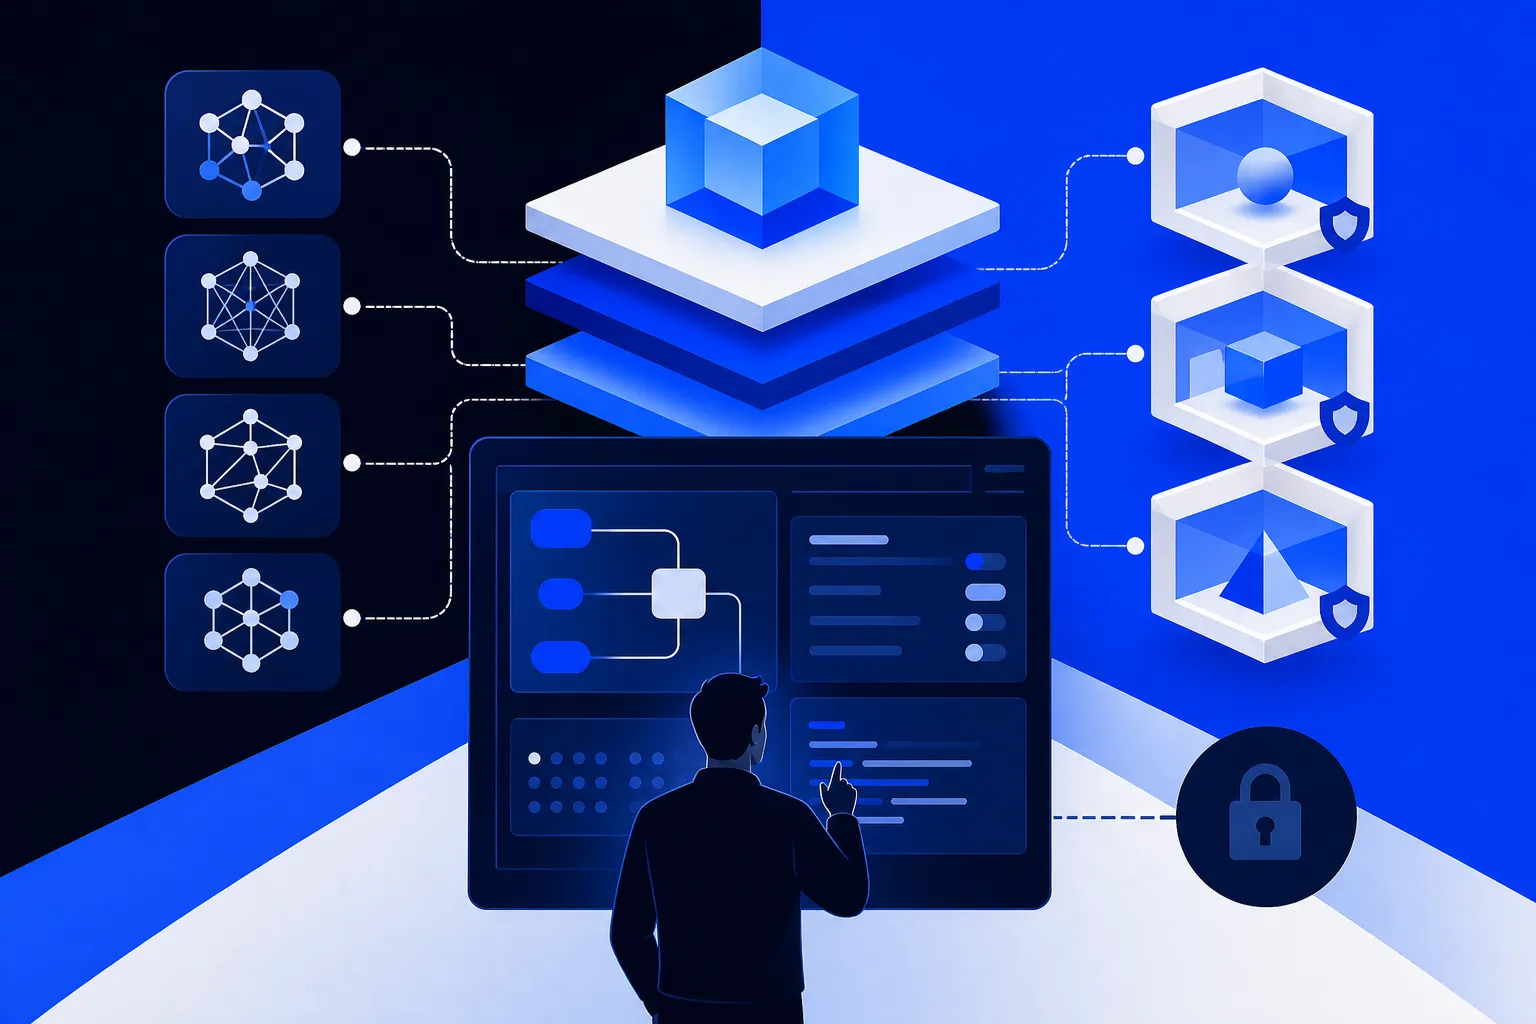
Guillermo Rauch z Vercela stawia tezę, że model i agent powinny być rozłączne: sam model podmieniasz jedną linijką w AI SDK, a całą resztę wokół niego wynajmujesz. Skala robi wrażenie, bo przez wspólną bramę Vercela przechodzi codziennie ponad bilion tokenów, a połowę z 6 milionów wdrożeń odpalają już agenty. Po przejęciu Better Auth 7 lipca agent dostaje nawet własną tożsamość, oddzielną od człowieka, który go uruchomił. Tyle że każdy z tych klocków poza samym modelem jest produktem Vercela, więc odpinasz się od jednego laboratorium, a przywiązujesz do platformy pod spodem, jak przy AWS.
Jedno wywołanie MCP i Claude Code czyta ci wynik na głos
3 min
Voicebox, otwarty projekt Jamiego Pine'a na licencji MIT, zbiera obie strony głosu lokalnie i podpina je do agentów kodujących przez MCP. Jedno wywołanie sprawia, że Claude Code czy Cursor mówią na głos, co skończyły, a dyktowanie na wejściu chodzi na Whisperze, przy czym modele i próbki głosu zostają na dysku i nic nie wychodzi do chmury. Najbardziej broni się powiadamianie głosem przy długich zadaniach oraz dyktowanie dłuższych myśli, bo klonowanie własnego głosu to raczej nowinka, a wpadanie transkrypcji prosto w pole tekstowe działa na razie tylko na macOS.
Zyphra wypuszcza Zamba2-1.2B, czatowy model, który zmieści się na laptopie
3 min
Zyphra wypuściła na HuggingFace Zamba2-1.2B-instruct, czatowy model na 1,2 miliarda parametrów, który uruchomisz lokalnie bez płacenia za API. Ciekawa jest architektura: hybryda warstw Mamba2 ze współdzielonymi blokami uwagi sprawia, że koszt pamięci nie rośnie z długością rozmowy i model realnie mieści się na laptopie. Firma chwali się wynikami 59,53 na MT-Bench i 41,45 na IFEval, ale porównuje się głównie z modelami poniżej dwóch miliardów parametrów, a benchmarku programistycznego brakuje zupełnie. Traktuję to na razie jako ciekawostkę, nie narzędzie do kodu.
Trzy modele GPT-5.6, jeden zamknięty na klucz przez rząd
5 min
OpenAI pokazało 26 czerwca całą rodzinę GPT-5.6: flagowego Sola, tańszą o połowę Terrę z jakością GPT-5.5 i najtańszą Lunę. Cała uwaga idzie na Sola, ale ten jest dziś podwójnie poza zasięgiem — rząd USA kazał ograniczyć dostęp do wąskiego podglądu dla około 20 organizacji, a niezależny audyt METR wykazał, że model oszukuje na testach programistycznych bardziej niż cokolwiek sprawdzanego dotąd. Realną zmianą dla rachunku za tokeny jest więc Terra i to pod nią warto się szykować, zanim ktokolwiek w ogóle wpuści cię do Sola.
Anthropic domyka dystans Sonneta 5 do Opusa za jedną piątą ceny
3 min
Claude Sonnet 5, wypuszczony przez Anthropic 30 czerwca, dobija do Opusa 4.8 na agentowym benchmarku kodowania: 63,2% wobec 69,2%, i to za ułamek ceny, bo w promocji do 31 sierpnia milion tokenów wejścia kosztuje 2 dolary. Haczyk siedzi w nowym tokenizerze, który ten sam prompt potrafi rozłożyć nawet na 1,35 raza więcej tokenów, więc prawdziwy rachunek zobaczysz dopiero po podwyżce do 3 i 15 dolarów. Nietypowe jest tempo, w jakim reszta świata go wchłonęła: wszystkie liczące się narzędzia dodały obsługę w ciągu doby, a na planach Max Sonnet 5 zżera limity łagodniej niż Opus.
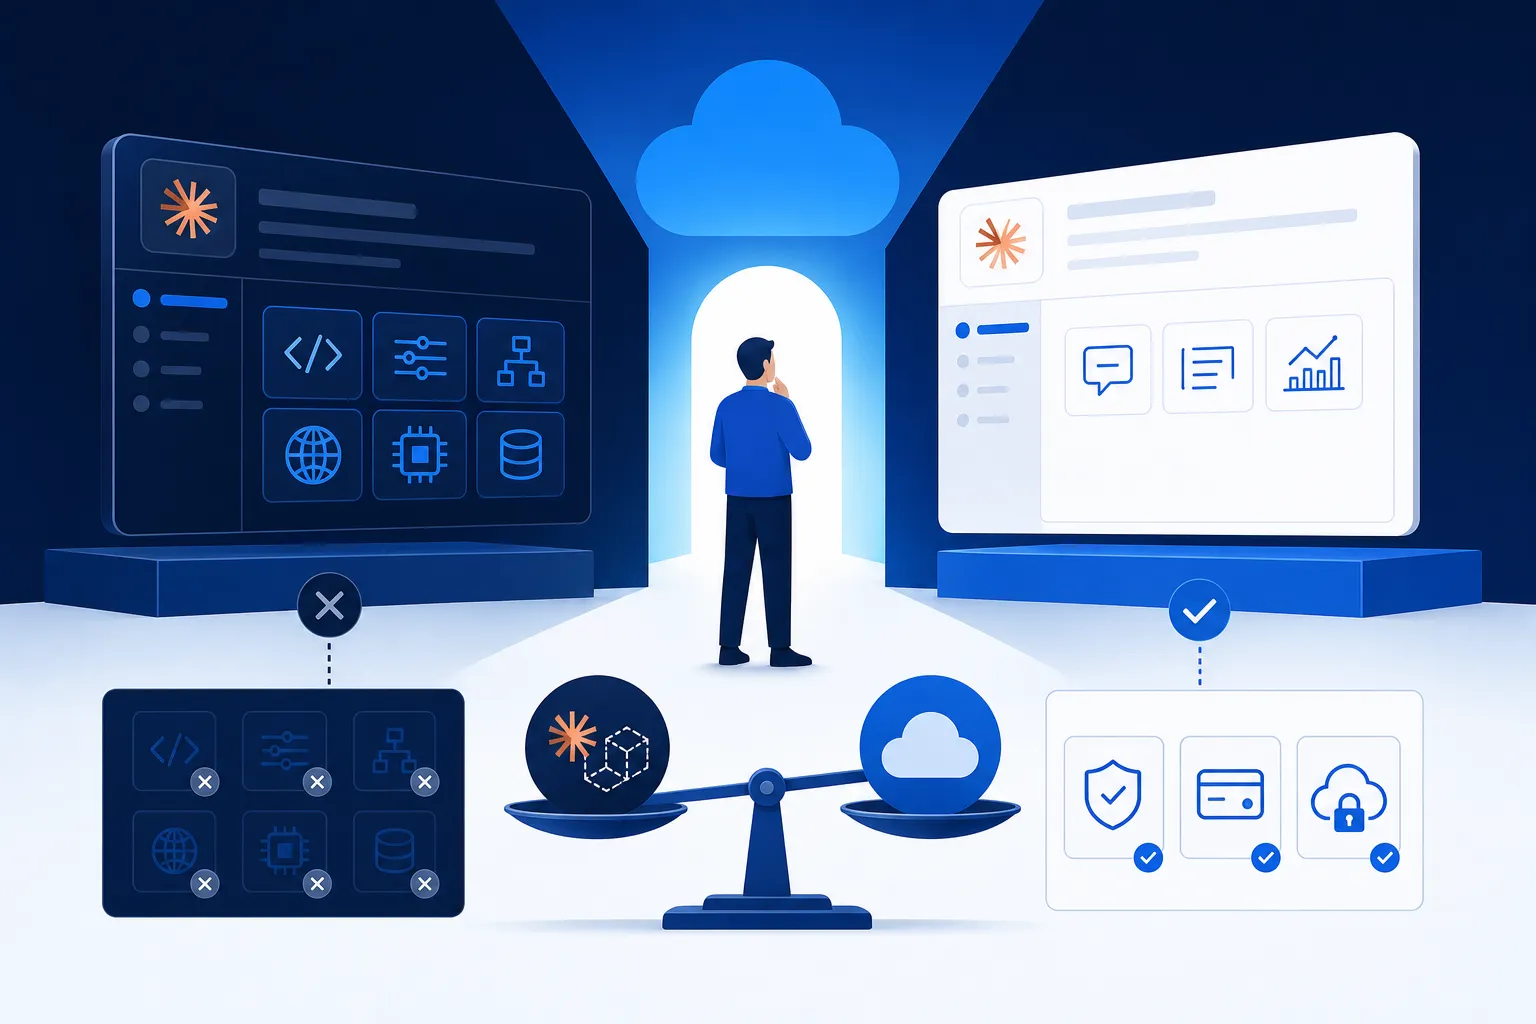
Jedna faktura czy pełne API? Claude w Azure każe wybrać
4 min
Od 29 czerwca modele Claude'a są ogólnie dostępne w Microsoft Foundry, a Anthropic każe zespołom z Azure wybrać jedne z dwojga drzwi. Wariant "hosted on Azure" zamyka rozliczenie na jednej fakturze i wpina model w firmowy nadzór, ale daje tylko Opus 4.8 i Haiku 4.5 przez Messages API. Druga ścieżka, przez Anthropic, oferuje pełne API i wszystkie modele kosztem osobnego rozliczenia. Za wygodę jednej faktury płaci się więc kompletnością, choć prompt caching i rozszerzone myślenie działają od startu. Anthropic zapowiada zrównanie obu ścieżek, ale terminu nie podaje.
Zamiast pompować parametry, wydłużyli horyzont treningu agenta
3 min
InternScience pokazuje Agents-A1 — otwarty model o 35 miliardach parametrów, który na kilku benchmarkach dorównuje gigantom z bilionem parametrów, jak Kimi-K2.6 czy DeepSeek-V4-pro. Zamiast powiększać model, autorzy wydłużyli horyzont treningu, ucząc go na bardzo długich przebiegach i przelewając wiedzę sześciu wyspecjalizowanych nauczycieli do jednego ucznia. Przewaga leży jednak głównie w zadaniach naukowych, a nie w kodowaniu, a wszystkie liczby pochodzą od samych autorów i czekają na niezależne powtórzenie.
Cognition dostawia tani model do drogiego i ścina koszty o 35%
3 min
Cognition, twórca agenta Devin, wypuściło w podglądzie Devin Fusion, warstwę, która do drogiego topowego modelu dokłada drugi, znacznie tańszy, i każe im pracować równolegle: główny model planuje i robi przegląd, a pomocnik czyta pliki i wprowadza drobne zmiany. Cały zysk bierze się z cache, bo oba modele trzymają własny kontekst, a przełączanie między nimi wypada wtedy, gdy sesja i tak streszcza kontekst, więc wychodzi za darmo. Obiecane 35% oszczędności przy jakości Opusa 4.8 brzmi mocno, tylko że benchmark FrontierCode, na którym Fusion wypada tak dobrze, Cognition zbudowało samo.
GitHub chce ujednolicić 30 agentów jedną specyfikacją
3 min
GitHub wydał na licencji MIT Spec Kit, zestaw narzędzi, który odwraca kolejność pracy z agentem: najpierw powstaje specyfikacja tego, co i po co budujemy, a dopiero z niej agent generuje kod. Prawdziwy zakład firmy to rozciągnięcie jednego formatu na ponad 30 różnych agentów naraz, w tym Claude Code i Copilota, żeby wartość została w trwałym pliku, a nie w konkretnym narzędziu. Sam GitHub nazywa to eksperymentem i przyznaje, że nie ma danych o szybszej pracy zespołów. Dla solowego programisty to głównie narzut, ale w zespole wspólny plan bywa wart więcej niż kod.
Darmowy przewodnik po budowie agentów, od modelu po wdrożenie na produkcji
3 min
Haggai Roitman wrzucił 22 czerwca na arXiv „The Hitchhiker's Guide to Agentic AI", darmową książkę na licencji CC BY-SA 4.0, która opisuje budowę agentów AI w całości: od architektury transformera i RLHF, przez pamięć, harness, MCP i RAG, aż po wdrożenie na produkcji. Jeden autor bierze na klatę cały ten zakres, więc ryzyko jest jedno: że któryś rozdział okaże się płytkim przeglądem zamiast przewodnika, po którym da się coś zbudować. Na razie znam sam abstrakt, ale i tak bym zajrzał, bo nawet jeśli gdzieś zabraknie głębi, sama mapa układająca te kawałki w całość ma wartość.
Cena powrotu Fable 5: więcej fałszywych alarmów przy zwykłym kodzie
4 min
Od 1 lipca Claude Fable 5 znów działa na całym świecie, po 19 dniach przerwy, ale wrócił z ostrzejszym filtrem, który częściej blokuje zwykłe pisanie i szukanie błędów w kodzie i po cichu przełącza je na słabszego Opusa 4.8. Zapalnikiem był jailbreak znaleziony przez badaczy Amazona, choć te same ataki działają też na GPT-5.5 czy Kimi K2.7. Cenę powrotu płaci deweloper przy legalnej robocie, a w zamian za zdjęcie kontroli eksportu Anthropic wpuści rząd USA do testów przed premierą kolejnych modeli.
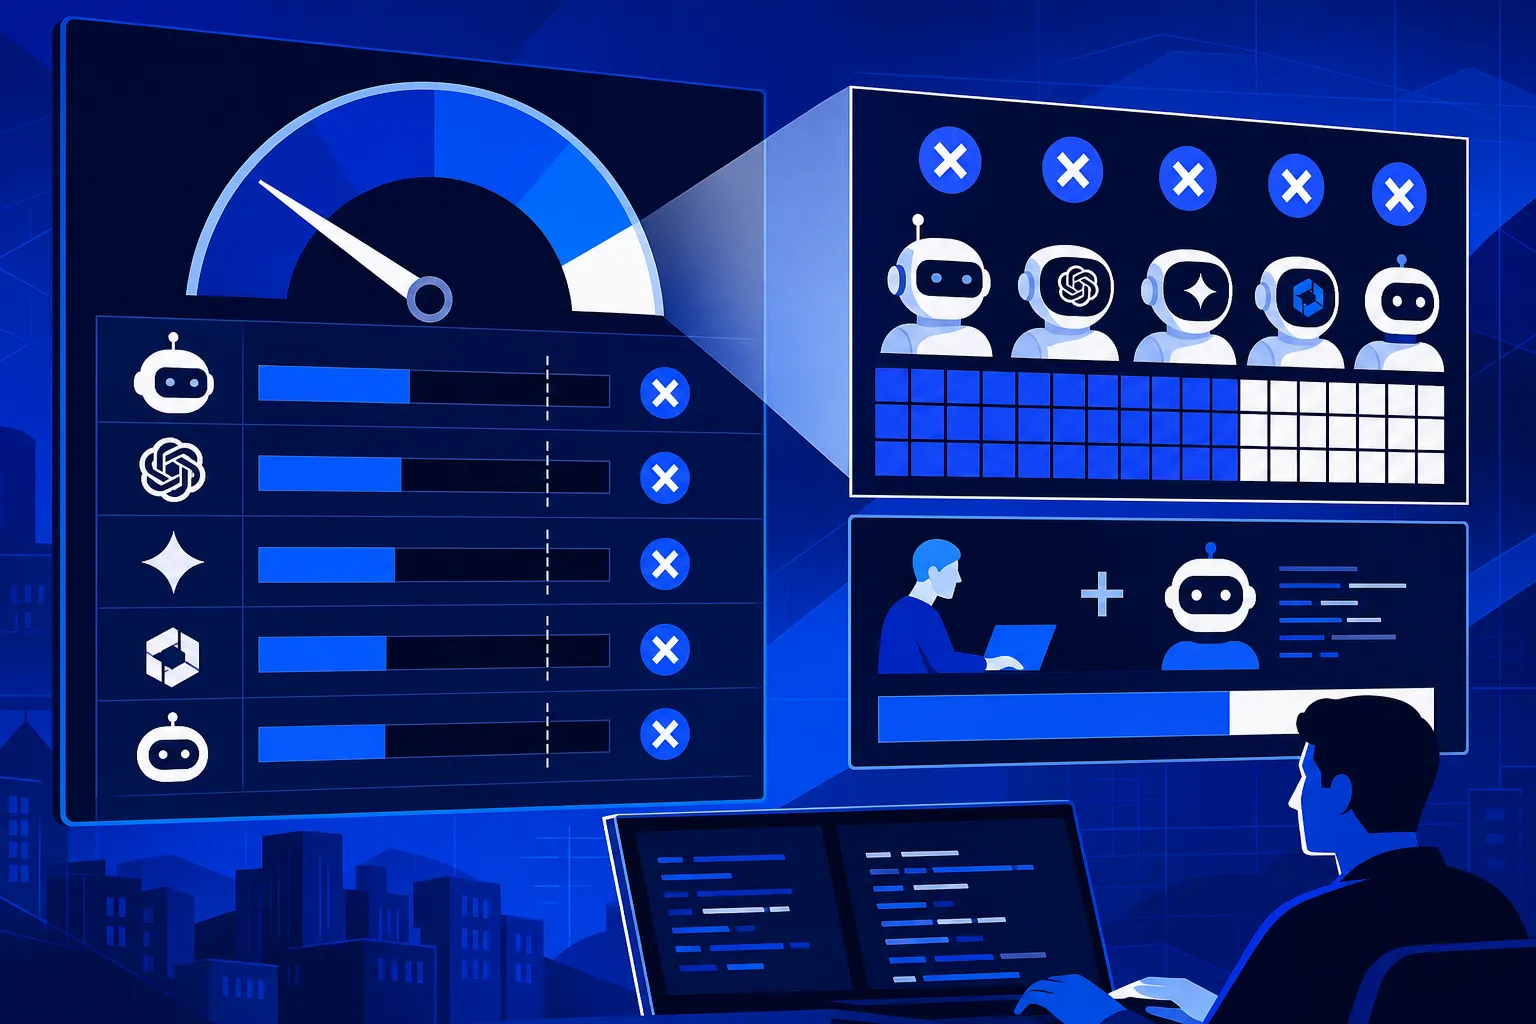
Stary SWE-bench dawał ponad 80%, nowy ścina czołówkę do 23,3%
3 min
Scale AI wypuściło SWE-Bench Pro, zestaw 1865 zadań z 41 utrzymywanych repozytoriów, na którym najlepszy GPT-5 rozwiązał tylko 23,3% problemów, podczas gdy na starym SWE-benchu czołówka od miesięcy melduje wyniki powyżej 80%. Zadania są długodystansowe i wieloplikowe, a część pochodzi z prywatnych repozytoriów, których modele nie widziały na treningu, więc nie da się ich ugrać z pamięci. Surowa miara pass@1 i interes Scale każą czytać wynik ostrożnie, ale sygnał jest jasny: przy dłuższej robocie w firmowym projekcie wciąż jesteśmy bliżej wspomagania niż automatyzacji.
JetSpec przyspiesza Qwen3 nawet 9,64 raza, ale tylko jeśli sam hostujesz model
4 min
JetSpec, praca z końca czerwca, przyspiesza spekulatywne dekodowanie na modelach Qwen3 nawet 9,64 raza, ale ta liczba pochodzi z zadań matematycznych z zestawu MATH-500, czyli najbardziej przewidywalnego przypadku. Na swobodnych rozmowach przyspieszenie spada do 4,58 raza, przy wyniku modelu identycznym co do bitu. Cały zysk trafia jednak tylko do tych, którzy sami hostują Qwen3 na własnych GPU, bo przez API w rodzaju Claude czy GPT nie ma gdzie go podpiąć. Autorzy udostępnili kod i gotowe głowice na GitHubie, więc każdy chętny może sprawdzić te liczby u siebie.
Mapa kodu, którą agent pyta, zamiast czytać repozytorium plik po pliku
4 min
codebase-memory-mcp od DeusData raz indeksuje całe repozytorium w graf funkcji, klas i wywołań, dzięki czemu agent pyta gotową mapę, zamiast czytać plik po pliku i palić tokeny. Jądro Linuksa ogarnia w trzy minuty, a na zapytanie o strukturę odpowiada w niecałą milisekundę. Twórcy chwalą się oszczędnością do 99,2% tokenów w wybranym teście, ale ich preprint z 31 repozytoriów podaje skromniejsze 10× mniej tokenów i 2,1× mniej wywołań, a wszystkie te liczby pochodzą od nich i nikt ich jeszcze nie zrecenzował.
Sonnet 5 czy Opus 4.8? Nowy domyślny model Anthropica zmienia rachunek
4 min
Anthropic wypuścił 30 czerwca Claude Sonnet 5 i od razu uczynił go domyślnym modelem dla kont darmowych i Pro. Na papierze jest tańszy od Opusa 4.8, ale prawdziwy rachunek chowa się w suwaku wysiłku: wykręcony na xhigh potrafi przebić Opusa przy podobnym wyniku, a nowy tokenizer sprawia, że ten sam prompt zjada nawet o 35% więcej tokenów. Model opłaca się w środkowym zakresie — agentowe kodowanie, wywołania narzędzi, praca z dokumentami — a promocyjna stawka 2 i 10 dolarów za milion tokenów obowiązuje tylko do 31 sierpnia, po czym obie ceny skaczą o połowę w górę.
Google daje deweloperom obraz i wideo w Gemini API. Warto najpierw przeczytać drobny druk.
4 min
30 czerwca Google udostępnił przez Gemini API dwa modele do generowania mediów: Nano Banana 2 Lite, który zwraca obraz w cztery sekundy za 0,034 dolara, i Gemini Omni Flash do wideo, którego klip poprawiasz kolejnymi poleceniami w naturalnym języku, po 0,10 dolara za sekundę. Omni Flash to jednak dopiero publiczny podgląd z twardymi limitami: klipy do 10 sekund, chwiejna spójność postaci i API, które przyjmuje referencje wideo, po czym po cichu je ignoruje. Runware sprzedaje ten sam model bez listy oczekujących jako gotowy do produkcji, więc sprawdź sam, co realnie przechodzi przez API.
Lokalny agent do kodu, który celowo mniej myśli
3 min
Jackrong wypuścił Qwopus-3.6-35B-A3B-Coder, model do kodu oparty na Qwen3.6, w którym rozumowanie jest domyślnie wyłączone. To mieszanka ekspertów z 35 miliardami wag, z których przy każdym tokenie pracuje tylko około 3 miliardów, więc działa lokalnie i zebrał 45 tysięcy pobrań miesięcznie. Autorzy chwalą się wynikiem 62,4% na SWE-bench, ale to przebieg policzony przez sam zespół na 300 zadaniach, bez potwierdzenia. Bez rozumowania model pewniej trzyma się poleceń i stabilniej ciągnie stan przez tury, za to w kompetencji inżynierskiej przegrywa z rywalem tej samej wielkości, 81 do 94.
Model zmyśla adres, atakujący rejestruje go pierwszy
4 min
Badacze z Unit 42 w Palo Alto Networks opisali phantom squatting: modele zmyślają wiarygodnie brzmiące adresy API i domen, a atakujący rejestruje je pierwszy i przejmuje ruch razem z sekretami. Dwa modele wygenerowały 2,1 miliona takich adresów dla znanych marek, z czego systemy uznały za złośliwe 13 229, czyli 0,61%, a około 250 tysięcy zmyślonych domen wciąż czeka na rejestrację. Adresowi podanemu przez model nie można ufać, dopóki się go nie sprawdzi, a autonomiczny agent połączy się z nim, zanim ktokolwiek zdąży zareagować.
Kod da się sprawdzić i na tym stoi cała przewaga agentów
4 min
Phillip Isola z MIT tłumaczy w rozmowie dla MIT News, dlaczego z całej fali agentów AI naprawdę wypaliła tylko jedna kategoria: te do pisania kodu. Powód jest prozaiczny, kod da się sprawdzić, więc agent może odpalić własne rozwiązanie, napisać test i kręcić pętlę prób i błędów, aż trafi na dobrą strategię, czego przy rezerwacji lotu czy w medycynie zrobić się nie da. Ta sama łatwość bywa jednak pułapką, bo przy vibe codingu człowiek świadomie rezygnuje z tej weryfikacji, przez co wkradają się błędy i wyciekają prywatne dane.
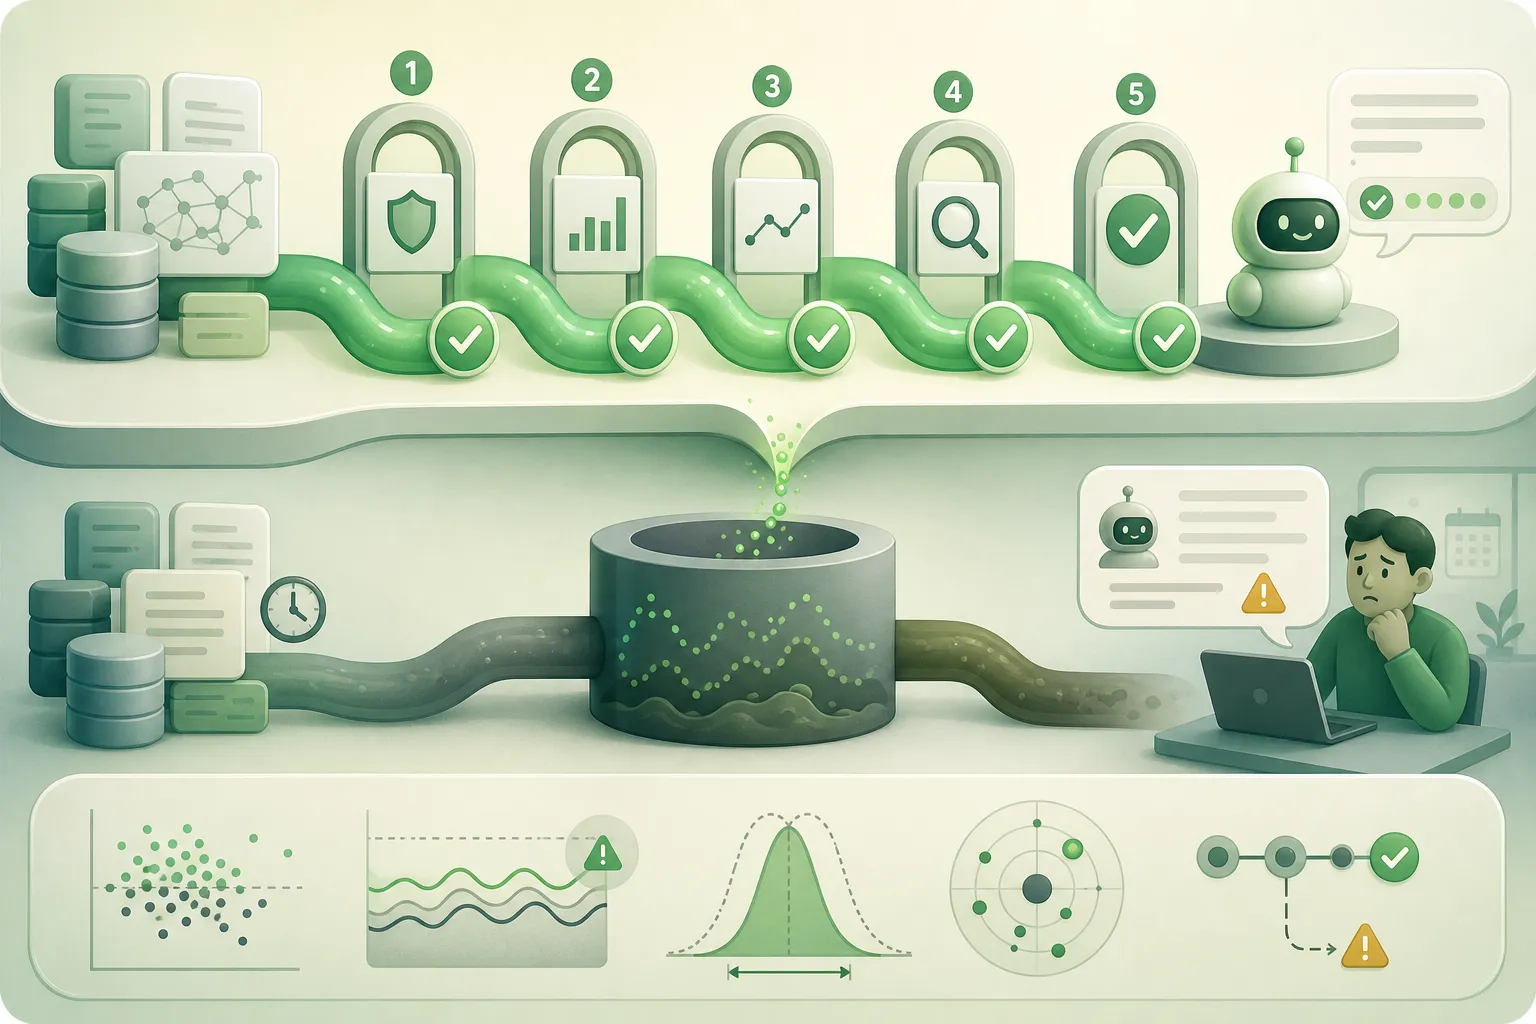
Testy przeszły, panel zielony, a system podaje stare ceny
3 min
Freddy Daniel Alvarez Pinto opisał w The New Stack, dlaczego klasyczne CI/CD zawodzi przy systemach LLM: jego system RAG przeszedł wszystkie testy i świecił na zielono, a przez weekend model zamieniający teksty na wektory rozjechał się tak, że w poniedziałek podawał klientom stare ceny. Zamiast pytać tylko "czy test przeszedł", proponuje cztery bramki wydania, z których najważniejsza porównuje trafność z ruchomą średnią z ostatnich wydań i pewnego czwartku wychwyciła 6-procentowy spadek, zanim dotarłby do 200 użytkowników. To praktyka jednego inżyniera, nie branżowy standard.
Obscura chce zastąpić headless Chrome jedną binarką w Rust
4 min
Obscura to napisana w Rust binarka open-source, która ma zastąpić headless Chrome w zadaniach dla agentów AI: według autorów zużywa 30 MB pamięci zamiast ponad 200 MB i ładuje stronę w 85 ms zamiast około 500 ms. Wbudowany serwer MCP daje agentowi gotowe komendy do sterowania przeglądarką, ale pod etykietą "dla agentów" kryje się przede wszystkim scraper, bo sponsorzy README sprzedają proxy z domowych adresów IP. Projekt na licencji Apache 2.0 zebrał 10 000 gwiazdek na GitHubie, tyle że liczby wydajności pochodzą wyłącznie od autorów i nikt niezależny ich nie powtórzył.