Programowanie AI
37,5 tysiąca dolarów za małego Qwena obudowanego konsolą Pythona
4 min
Tufa Labs wygrało pierwszy etap konkursu ARC-AGI-3 i pulę 37,5 tysiąca dolarów rozwiązaniem zaskakująco skromnym: małym, otwartym modelem Qwen obudowanym prostym agentem, którego jedynym narzędziem była interaktywna konsola Pythona. Pobiło tym podejścia oparte na modelach wizyjno-językowych, choć samą grę jako pierwszy przeszedł dopiero większy GPT-5.6 Sol. Sedno brzmi nie "mały bije dużego", tylko subtelniej: gdy modele do kodu stają się towarem, prawdziwą przewagą jest harness, czyli minimalna pętla sterująca wokół modelu, którą da się złożyć samemu na laptopie.
DeepSeek wypuszcza R1: rozumowanie, które pobierasz i uruchamiasz u siebie
4 min
DeepSeek wypuścił na Hugging Face model rozumujący R1 na licencji MIT, razem z sześcioma mniejszymi wariantami destylowanymi, które można pobrać i uruchomić na własnym sprzęcie. Według liczb podanych przez samego DeepSeeka R1 dorównuje o1 od OpenAI: 65,9% na LiveCodeBench i 49,2% na SWE Verified, choć niezależne testy dopiero to zweryfikują. Flagowy R1 ma 671 miliardów parametrów i nie zmieści się w domowej serwerowni, ale wersja 32B odpali na jednej stacji roboczej. Rozumowanie na poziomie o1 przestało istnieć wyłącznie za czyimś API.
Tanie półki GPT-5.6 zmieniają rachunek bardziej niż flagowy Sol
4 min
OpenAI wypuściło 9 lipca rodzinę GPT-5.6: flagowego Sola, tańszą Terrę i najtańszą Lunę, a najważniejsza liczba to nie "mądrzejszy", tylko "tańszy". Sol wypada o punkt poniżej Fable 5 na indeksie inteligencji, kończy jednak zadania w 61% krótszym czasie i za mniej więcej połowę kosztu, choć na SWE-Bench Pro zbiera tylko 64,6% wobec 80% konkurenta. Prawdziwą różnicę w rachunku robią dwie tanie półki: Terra i Luna biją Fable 5 przy około jednej szesnastej kosztu, a Luna startuje od 1 dolara za milion tokenów na wejściu. To nie przewrót, tylko przesunięcie stołu w stronę taniej.
SWE-1.7 dobija do czołówki modeli do kodu za ułamek jej ceny
3 min
Cognition wypuściło 8 lipca SWE-1.7, model napędzający agenta Devin, i reklamuje go ostrożnie: dobił do czołówki za ułamek jej ceny. Na własnym teście FrontierCode osiąga 42,3%, tuż pod GPT-5.5 i cztery punkty pod Opus 4.8, choć poprzednia wersja miała tu ledwie 9,4%. Model grzebie w kodzie dłużej i chętniej dopisuje testy, ale rusza więcej plików, niż trzeba. Haczyk w tym, że najtrudniejszy z benchmarków napisał sam Cognition, a konkretnej ceny w całym wpisie nie pada ani razu.
Leanstral 1.5 dowodzi twierdzeń matematycznych i przy okazji znajduje błędy w prawdziwym kodzie
3 min
Leanstral 1.5, wypuszczony 6 lipca przez Mistrala na licencji Apache-2.0, zachowuje się jak agent programistyczny, tylko że jego robotą są dowody w Lean 4: proponuje kod, czyta uwagi kontrolera i poprawia próbę, aż dowód przejdzie. Puszczony na 57 repozytoriów, wyłapał pięć błędów, których nikt wcześniej nie zgłosił na GitHubie. Mistral podaje komplet punktów na miniF2F i 587 z 672 zadań PutnamBench, a przede wszystkim około 4 dolary za zadanie wobec 300 dolarów u konkurencyjnego Seed-Prover 1.5. Tyle że nikt tych wyników jeszcze niezależnie nie powtórzył.
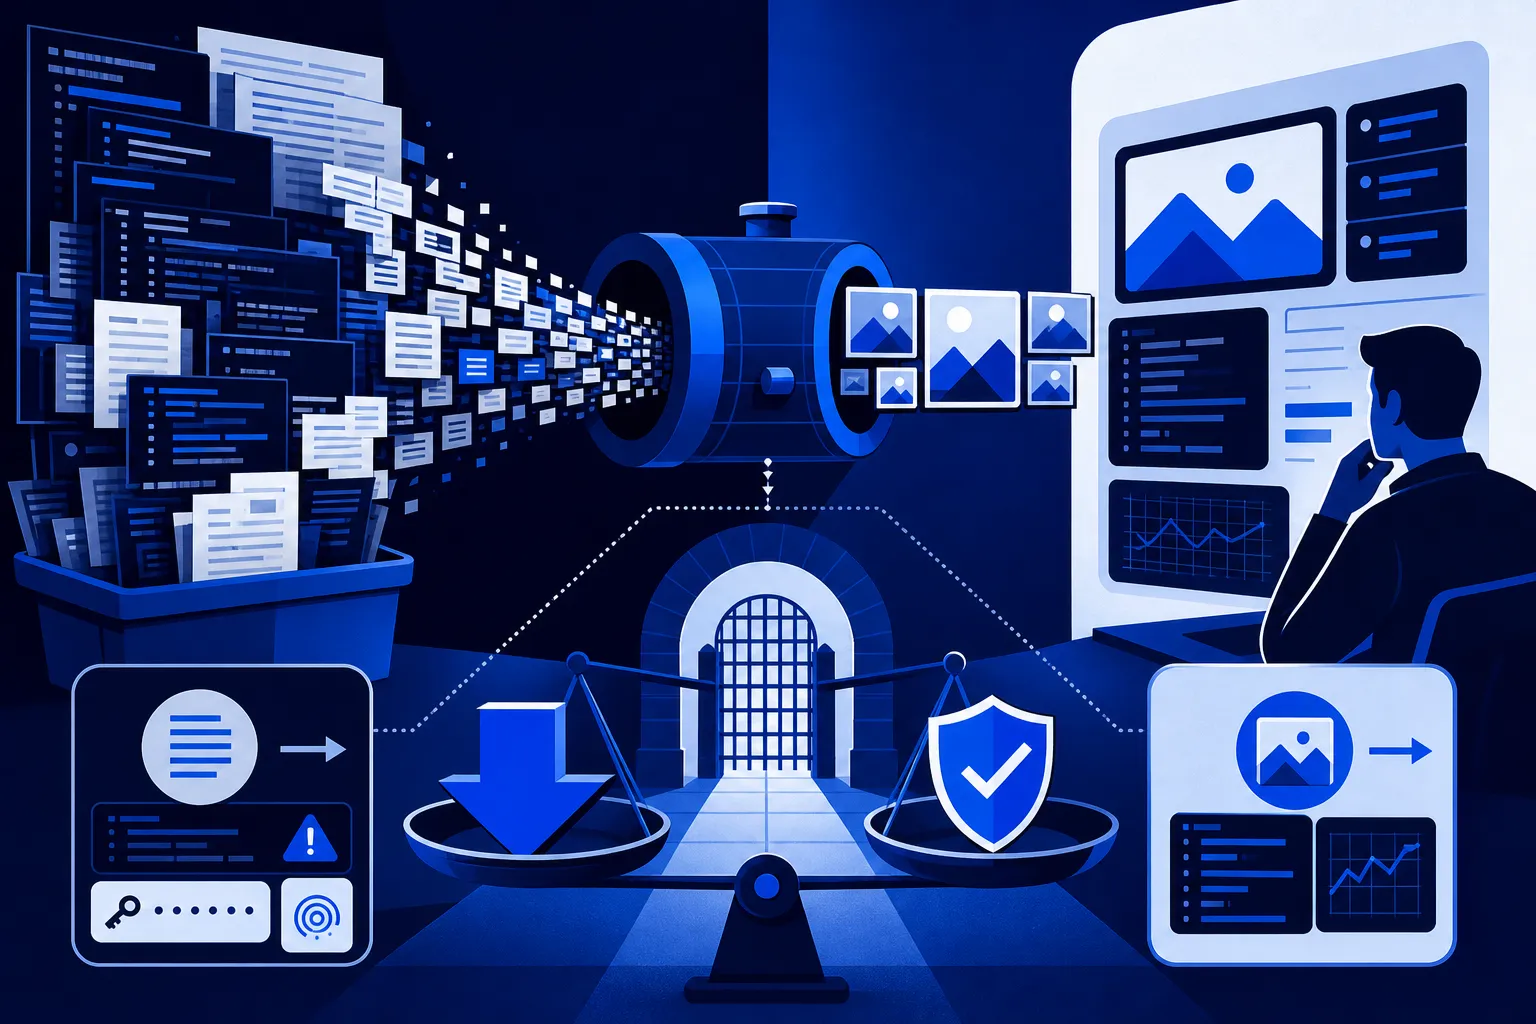
Obraz mieści trzy razy więcej treści na token, ale potrafi po cichu przekłamać identyfikator
5 min
pxpipe, otwartoźródłowe proxy dla Claude Code, przepisuje najcięższe fragmenty kontekstu na gęsto zadrukowane obrazy PNG, bo model płaci za obraz według pikseli, a nie tekstu: około 3,1 znaku na token obrazu wobec jednego na token tekstowy. Rachunek spada o 59-70% liczone od początku do końca, a w nagraniu demo sesja kończy się na 6,06 dolara zamiast 42,21. Problem w tym, że obrazowanie jest stratne i model po cichu zmyśla przekłamane znaki, więc identyfikatory, sekrety i najświeższe tury zostają tekstem.
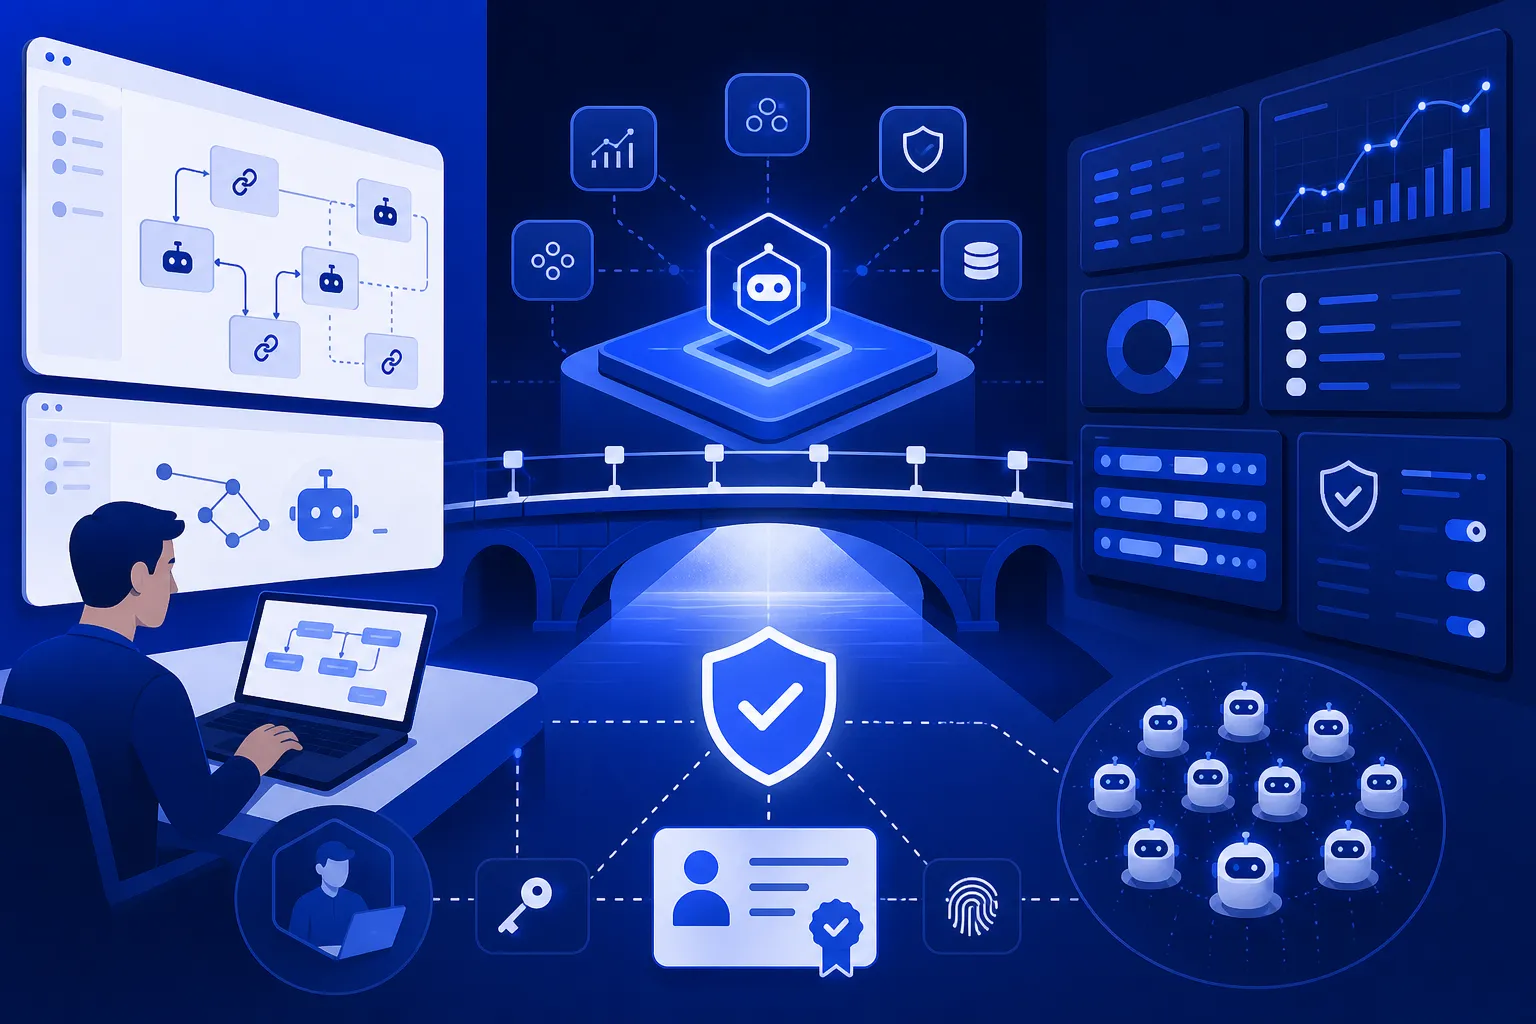
AgentField bierze na siebie to, czego frameworki agentowe nie robią: produkcję
3 min
AgentField, otwarty projekt na licencji Apache 2.0, nazywa siebie warstwą sterującą nad agentami: logikę piszesz jak zwykłą funkcję w Pythonie, Go albo TypeScripcie, a projekt bierze na siebie to, czego frameworki pokroju LangChain czy CrewAI nie robią, czyli kolejkowanie, ponawianie po awariach i wgląd w produkcję. Kolejka trzyma się na PostgreSQL, więc po restarcie robota wznawia się od miejsca, w którym stanęła, a każdy agent dostaje własną kryptograficzną tożsamość zamiast wspólnego klucza API. Twórcy chwalą się przepływem na ponad 10 000 wywołań, ale to na razie liczby producenta.
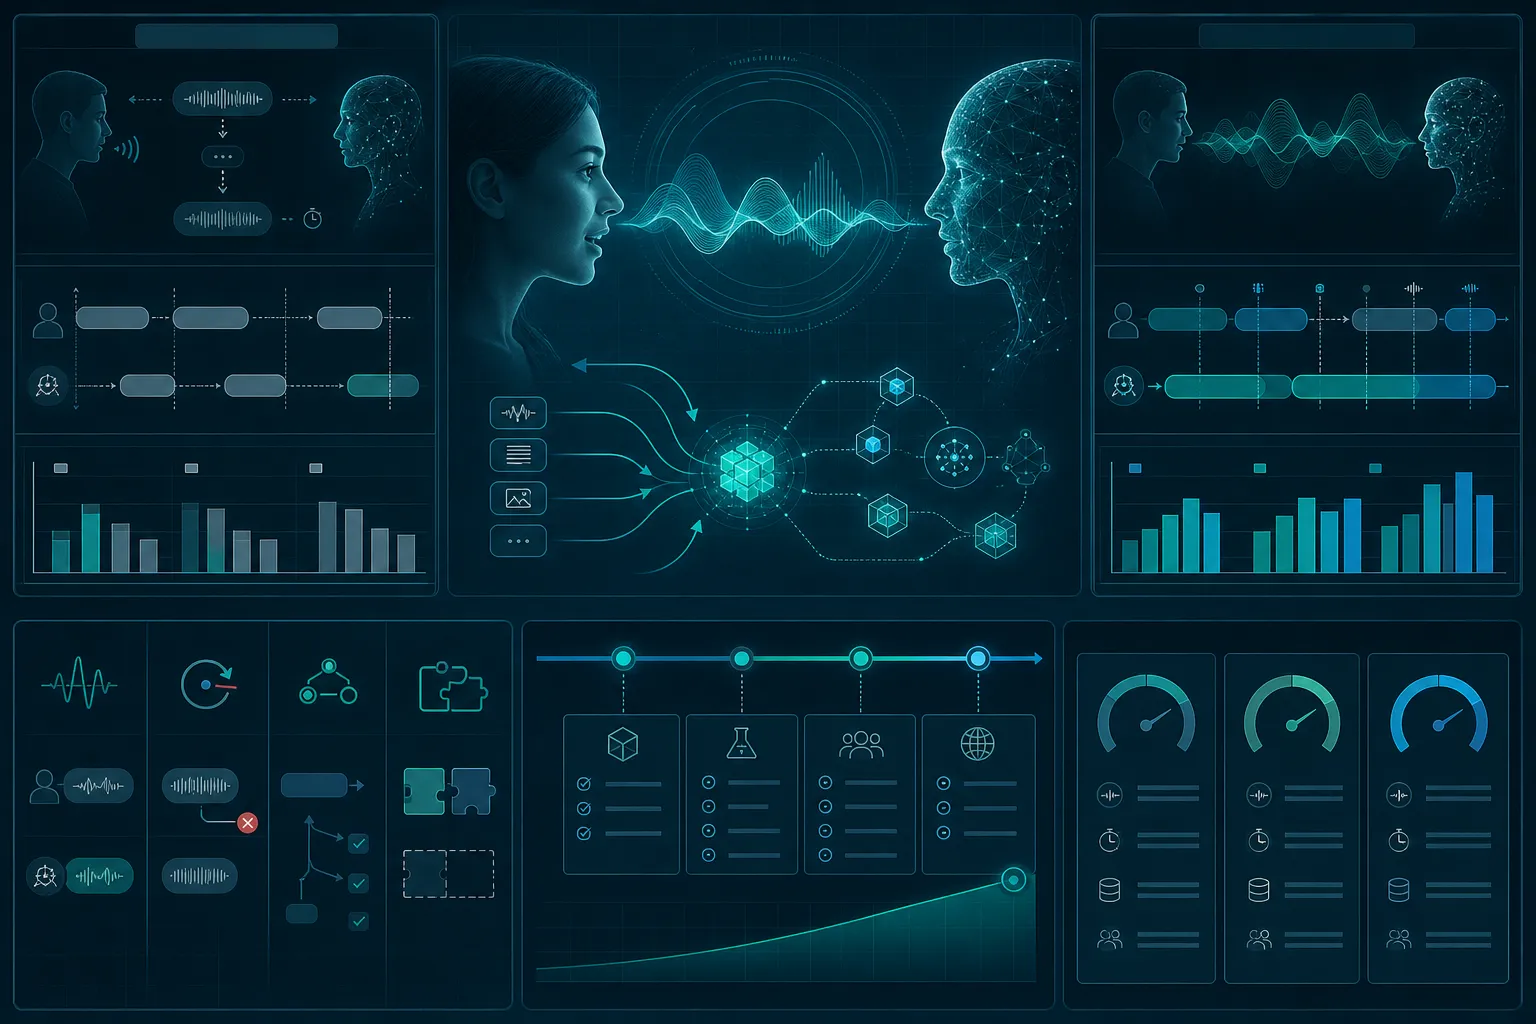
Nowy głos ChatGPT brzmi jak rozmowa, ale API dopiero w planach
3 min
OpenAI wymieniło silnik głosowy ChatGPT na nowy model GPT-Live, który od 8 lipca jest domyślnym trybem głosowym w konsumenckiej wersji, od darmowych kont po Pro. Nowość to full-duplex: model słucha i mówi jednocześnie, można mu przerwać w pół zdania, a ciężkie myślenie oddaje w tle mocniejszemu GPT-5.5, żeby rozmowa się nie zawieszała. Problem w tym, że cała architektura żyje wyłącznie w oknie czatu: API dopiero ma się pojawić, bez daty, cennika i limitów, więc programista nie postawi na niej na razie ani linijki.
Gemma 4 obiecuje rozumowanie w małym modelu z otwartymi wagami. Wag i liczb wciąż brak.
3 min
2 lipca Google wrzucił na arXiv 17-stronicowy raport zapowiadający Gemmę 4, nową rodzinę modeli z otwartymi wagami od 2,3 do 31 miliardów parametrów, w wariancie gęstym i Mixture-of-Experts. Ciekawie brzmi tryb myślenia w małym modelu, który postawisz u siebie, ale streszczenie nie podaje ani jednej liczby z benchmarku i ani słowem nie wspomina o kodowaniu, więc SWE-bench czy HumanEval tu nie znajdziesz. Wag do pobrania ani API na razie brak, więc to zapowiedź, a nie model, którego odpalisz w edytorze.
Zatwierdzasz edycję jednego pliku. Czy na pewno wiesz, dokąd trafi?
5 min
GhostApproval to wzorzec podatności, który firma Wiz ujawniła 8 lipca w sześciu asystentach do programowania, m.in. w Claude Code, Cursorze i Amazon Q Developer. Sztuczka jest stara jak Unix: niewinnie nazwany plik konfiguracyjny okazuje się dowiązaniem symbolicznym do celu poza projektem, na przykład do ~/.ssh/authorized_keys, a agent bez ostrzeżenia zapisuje tam dane. Sedno problemu to rozjazd między oknem zgody a rzeczywistością, bo agent zna prawdziwy cel zapisu, a użytkownik zatwierdza coś, czego nigdy nie zobaczył. Amazon, Cursor i Google wydały poprawki, Anthropic zgłoszenie odrzucił.
Self-Harness: agent czyta własne logi i sam łata swoje opakowanie
4 min
Self-Harness, opisany w pracy z arXiv z 8 czerwca, każe agentowi czytać własne logi z awarii i samodzielnie przepisywać reguły swojego opakowania w pętli: znajdź słabość, załataj, przepuść zmianę przez testy regresji. Na Terminal-Bench-2.0 największy skok zaliczył najsłabszy model, Qwen3.5, który z 23,8% doszedł do 38,1%, podczas gdy mocniejsze MiniMax M2.5 i GLM-5 podniosły się słabiej. Wygląda to więc na sposób, żeby tańszy albo hostowany lokalnie model podciągnąć do poziomu, na którym w ogóle nadaje się do roboty, choć zostaje pytanie, kto potem czyta reguły, które napisał model.
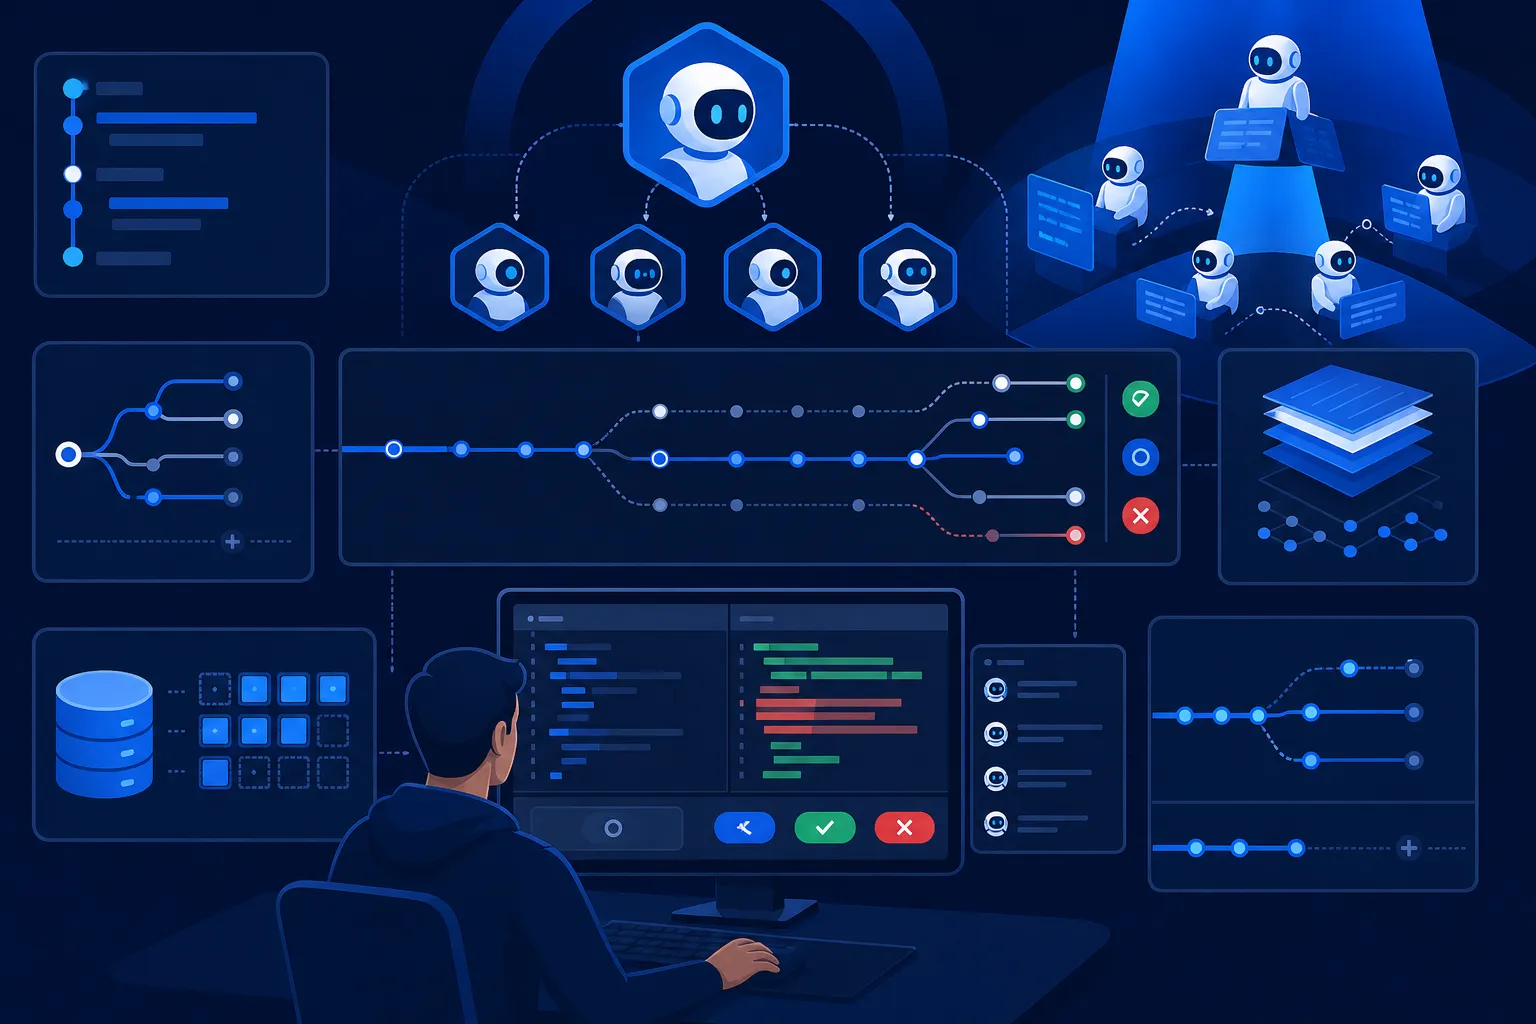
Agent pisze kod, a twoje pliki i tak zostają nietknięte
3 min
Shepherd, framework ze Stanforda, nagrywa uruchomienie agenta jako odwracalny zapis i odkłada wynik na bok, więc nie dotyka twoich plików, dopóki sam zmian nie zatwierdzisz. Uprawnienia deklarujesz w sygnaturze funkcji Pythona, a zakazu zapisu pilnuje samo jądro systemu, przez Seatbelt na macOS i Landlock na Linuksie. Rozgałęzianie pracy działa około pięć razy szybciej niż docker commit, a odtworzenie przebiegu odzyskuje jakieś 95% tego, co model już policzył. Docelowo mają z tego powstać metaagenci recenzujący swoją pracę, ale projekt jest we wczesnej alfie na licencji MIT, bez Windowsa.
Tencent wypuszcza Hy3 na Apache 2.0 i znosi barierę, która blokowała go w Europie
5 min
Tencent wydał Hy3, model typu mixture-of-experts o 295 miliardach parametrów, na licencji Apache 2.0 bez regionalnych wyłączeń, dzięki czemu znika bariera, która wcześniej blokowała chińskie modele w Unii, Wielkiej Brytanii i Korei. W kodowaniu Hy3 świadomie ustępuje o połowę większemu GLM-5.2, 78,0 do 84,2 na SWE-bench Verified, ale wśród otwartych wag prowadzi w agentowym przeszukiwaniu sieci i mieści się poniżej 300 GB zamiast 744 GB. Tencent chwali się też spadkiem halucynacji z 12,5% do 5,4%, choć niemal wszystkie te liczby zmierzył sam.
Skąd wiesz, że twój recenzent kodu AI jest dobry? Wskaźnik akceptacji kłamie
4 min
DoorDash pokazuje, dlaczego popularny wskaźnik akceptacji uwag kłamie przy ocenie recenzentów kodu opartych na AI: nie policzy błędu, którego agent w ogóle nie zgłosił. Ich odpowiedzią jest DashBench, wewnętrzny benchmark odtwarzający 105 dawnych PR-ów i zestawiający adnotacje inżynierów, zgłoszenia recenzenta i osąd modelu-sędziego. Para Kimi K2.6 i Claude Fable 5 wyłapała najwięcej, 65,2% ważonej wykrywalności za 3,81 dolara na PR-a, ale jednego zwycięzcy nie ma: wybór zależy od tego, co bardziej boli, przeoczony krytyczny błąd, szum fałszywych alarmów czy rachunek.
Agent Gemini może teraz działać w tle. Google nie mówi tylko, jak długo.
3 min
7 lipca Google dołożył do Managed Agents w Gemini API cztery możliwości, a najważniejsza pozwala odpalić agenta w tle parametrem `background: true` i odpytywać go po identyfikatorze, zamiast trzymać kruche otwarte połączenie HTTP przez cały czas pracy. Doszły też połączenie wprost ze zdalnym serwerem MCP, wywoływanie własnych funkcji i odświeżanie poświadczeń w locie. Fundament jest solidny, tyle że brakuje jednej liczby: Google nie mówi, jak długo takie zadanie może chodzić w tle, zanim się urwie — a to funkcja, która ma sens wyłącznie dla długiej roboty.
Osobista konfiguracja agenta jako publiczne repo na licencji MIT
3 min
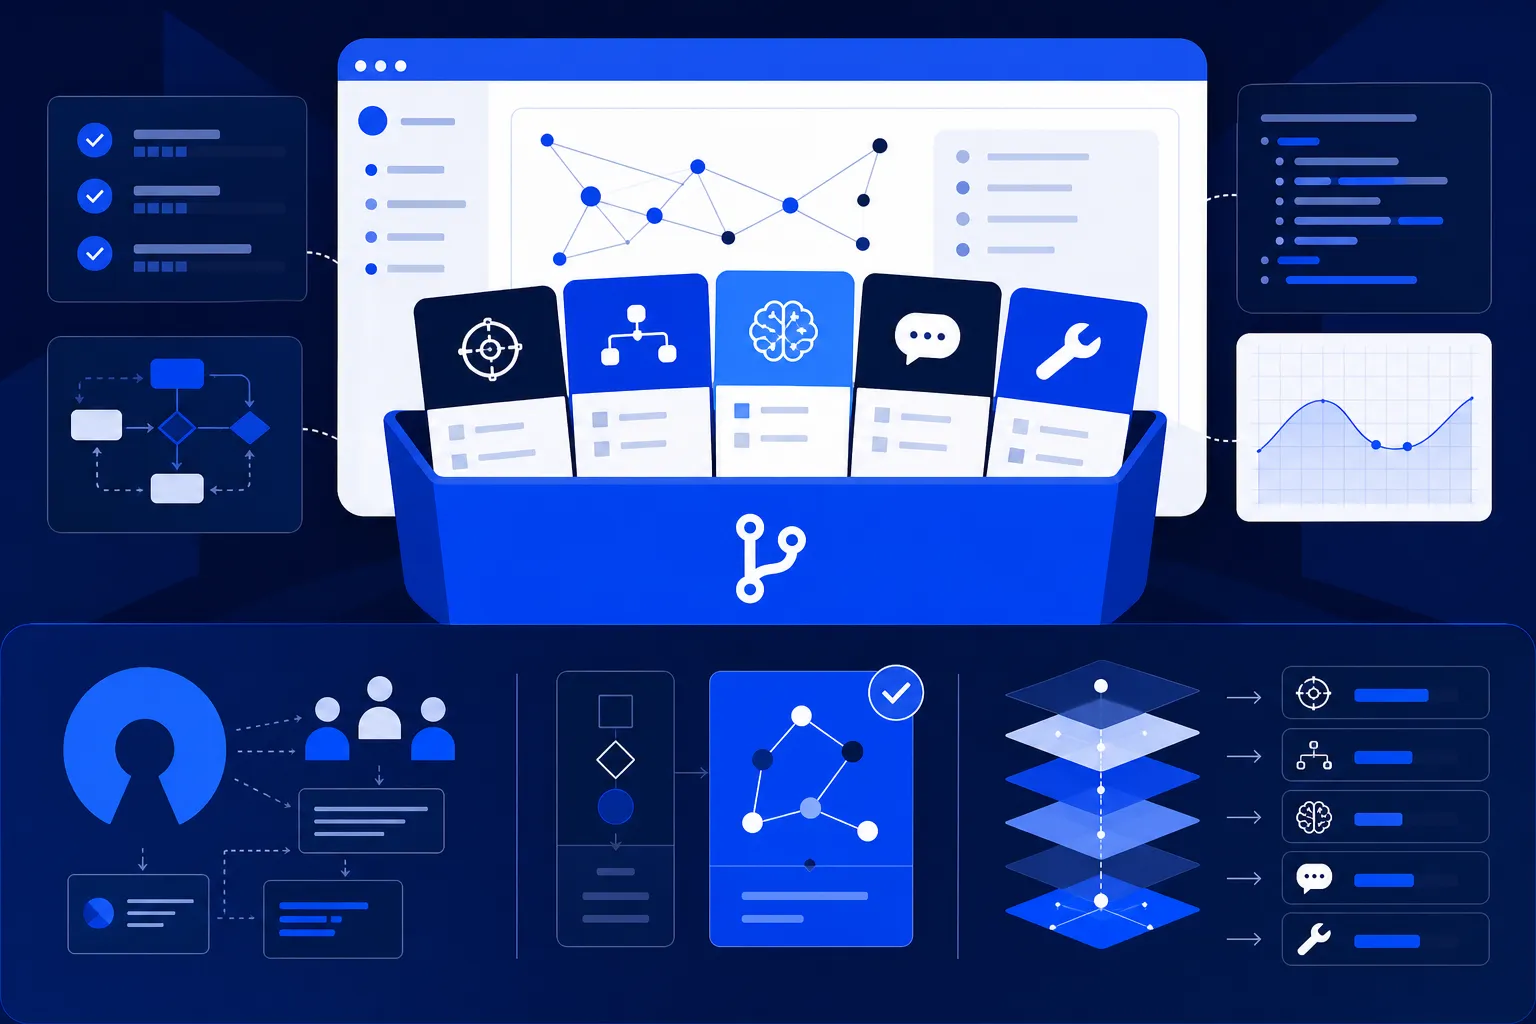
David Ondrej wrzucił 7 lipca na GitHuba repozytorium skills na licencji MIT: oczyszczony zrzut własnego zestawu procesów dla agentów. Każdy proces to osobny folder z plikiem SKILL.md, który mówi agentowi, kiedy go uruchomić, a całość dzieli się na pięć kategorii, w tym warstwę meta ze skillami do pisania kolejnych skilli. W kilka dni zebrało 1700 gwiazdek i 226 forków. Sedno leży we wzorcu: osobista konfiguracja agenta staje się publicznym, forkowalnym repo, jak dawniej dotfiles, tylko warstwę wyżej. Tyle że README to jeszcze nie dowód, że skille zadziałają u ciebie.
2,49 dolara za zadanie: nowy model SpaceXAI uderza w koszt agentów
4 min
SpaceXAI wypuściło Grok 4.5, swój pierwszy model zbudowany pod programowanie i pracę agentów, i celuje w rachunek: według Artificial Analysis jedno zadanie kosztuje na nim około 2,49 dolara, prawie pięć razy mniej niż 11,80 dolara na Fable 5 od Anthropica. Oszczędność bierze się z niższej ceny tokenów i mniejszej liczby kroków, a model trenowano razem z Cursorem, na danych o tym, jak programiści naprawdę piszą kod. Haczyk jest realny: tani token nie znaczy tani efekt, bo Grok 4.5 pewniej brnie w błąd, gdy się myli, a do połowy lipca w ogóle nie działa w Unii Europejskiej.
AWS pokazuje, ile naprawdę waży "produkcyjny" serwer MCP
4 min
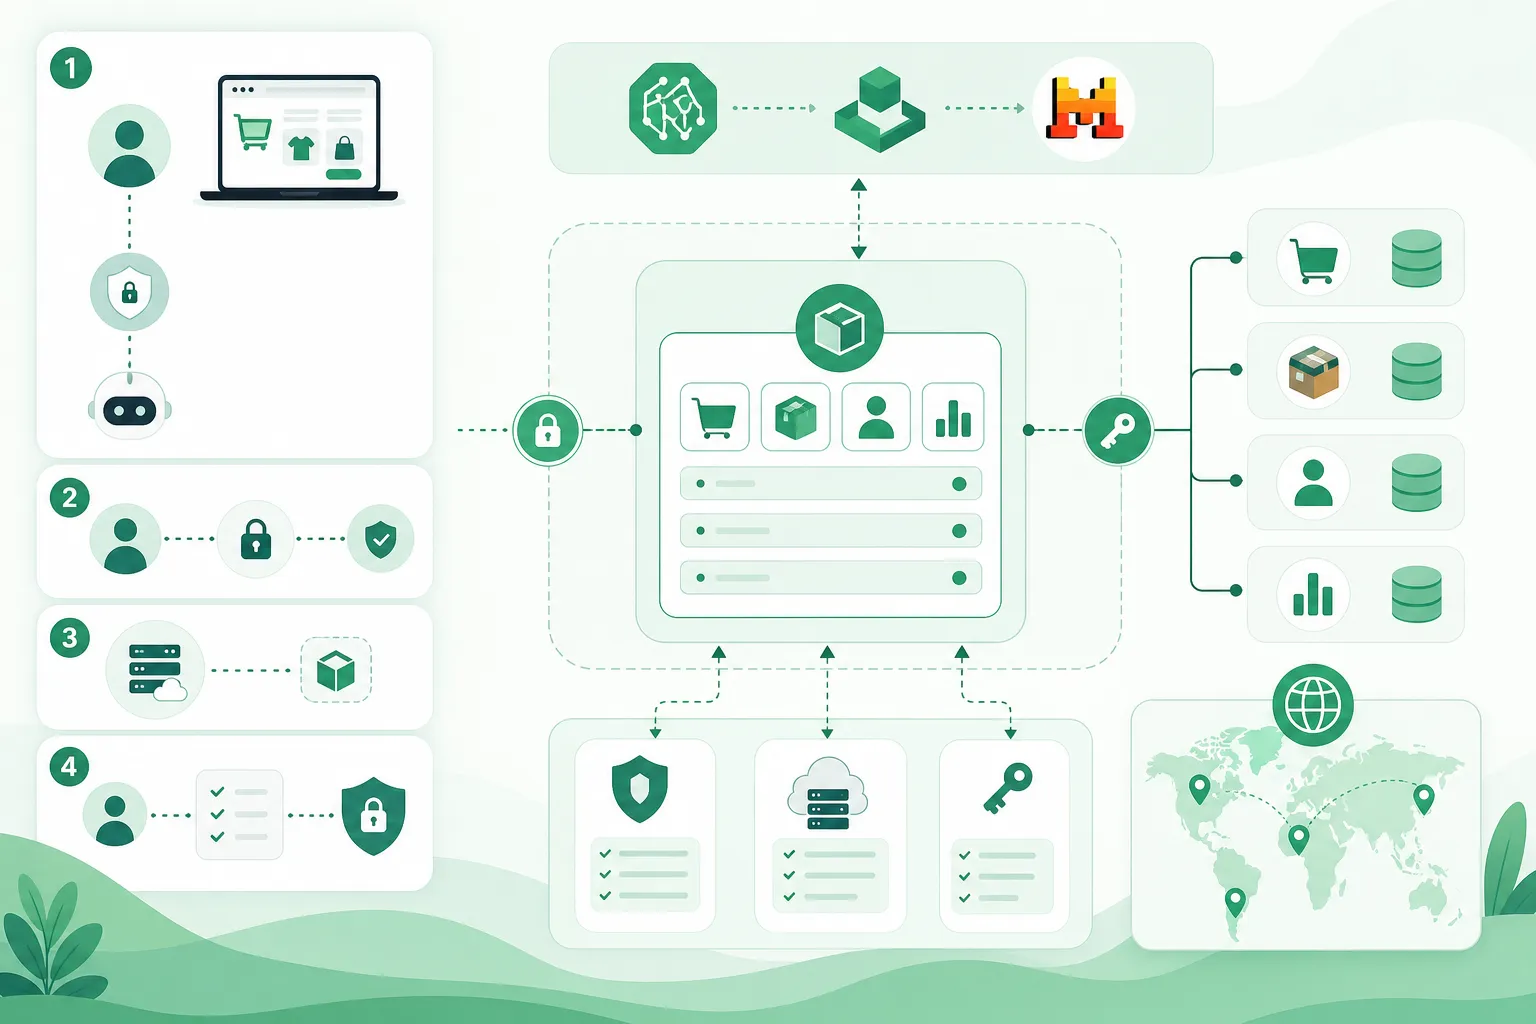
Opublikowany 30 czerwca przewodnik AWS buduje serwer MCP dla przykładowego sklepu i podłącza go do klienta Mistrala, ale prawdziwą treścią jest architektura bezpieczeństwa. Uwierzytelnianie rozkłada się na dwie warstwy: AgentCore Runtime sprawdza kryptograficznie token JWT z Cognito, zanim kod ruszy, a aplikacja zamienia go na tożsamość klienta i sięga w DynamoDB tylko po jego dane. Słowo "produkcyjny" waży tu tyle, że skrótu nie ma — dostajesz cztery pakiety infrastruktury w CDK, nie gotowy produkt, a najwięcej wynosi się z reguł: najmniejsze uprawnienia i limit ośmiu funkcji na serwer.
Publiczne API, agresywna cena i benchmarki, których nikt z zewnątrz nie widział
4 min
W czwartek 9 lipca Meta pokazała Muse Spark 1.1 i otworzyła publiczny podgląd Meta Model API, do którego zapisujesz się na listę oczekujących i budujesz za 1,25 dolara od miliona tokenów wejścia oraz 4,25 dolara od wyjścia, z 20 dolarami darmowych środków na start. Alexander Wang chwali cennik jako agresywny, taniej niż Grok 4.5 i Opus. Problem w tym, że jedyny wynik pochodzi z wewnętrznego Meta Internal Coding Bench, bez żadnej publicznej liczby na SWE-Bench, więc świetne kodowanie trzeba przyjąć na słowo. To na razie model do eksperymentu, nie do produkcji.
Co, jeśli lepszy agent nie potrzebuje większego modelu, tylko lepszego harnessu?
3 min
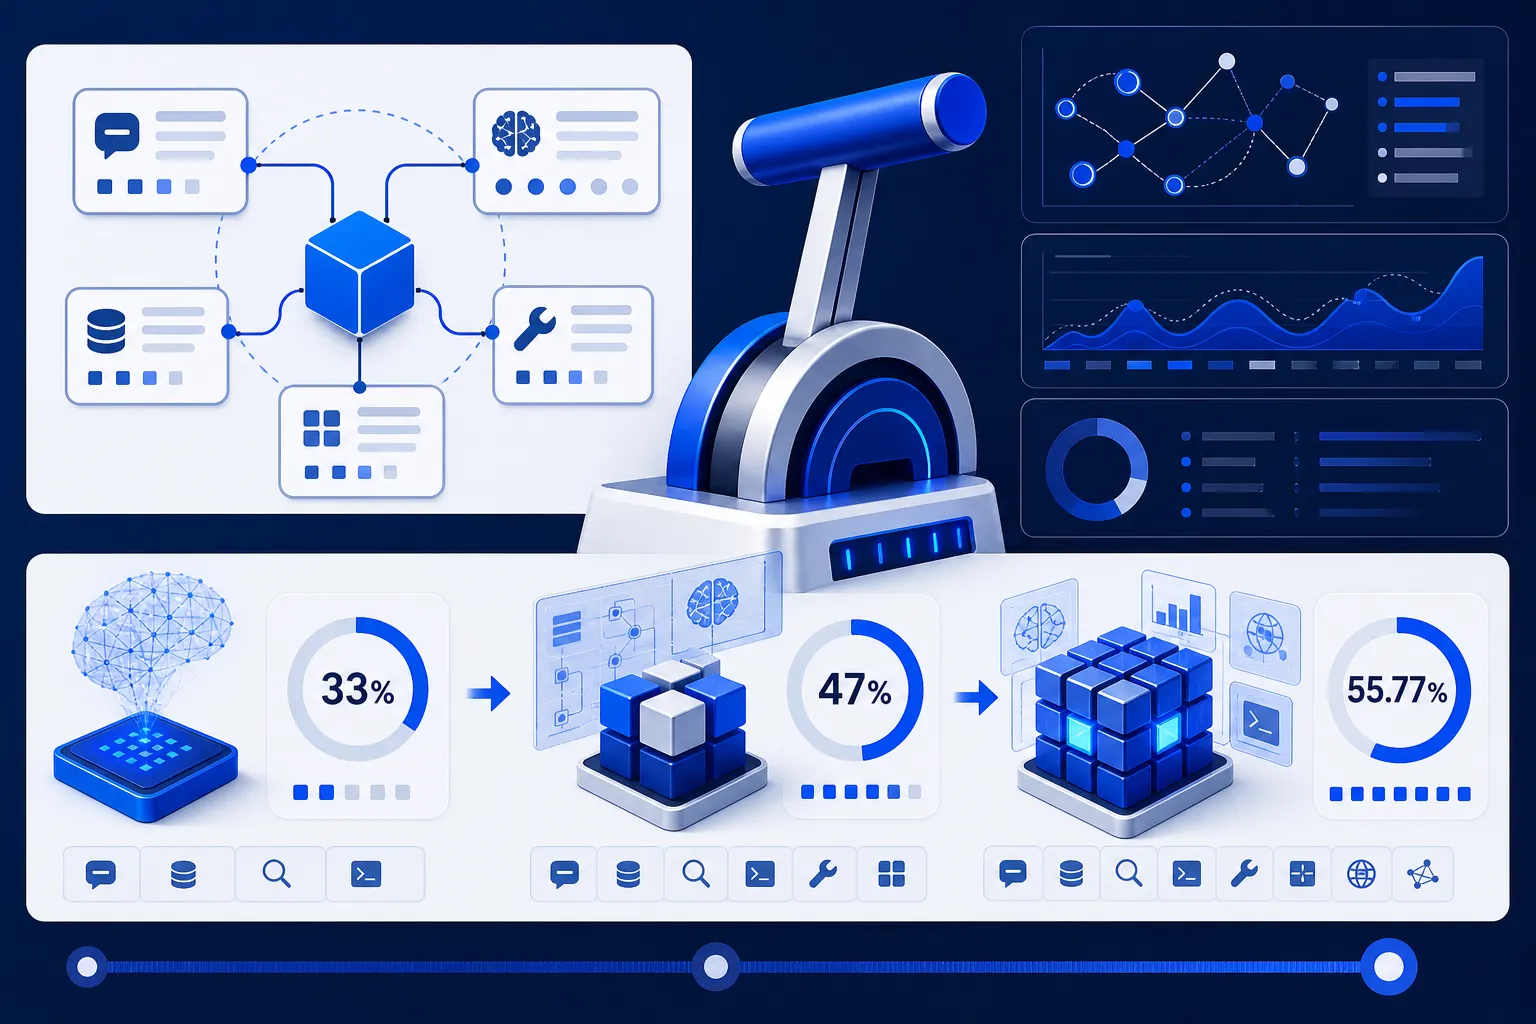
HarnessX, otwarty framework Darwin Agent na licencji MIT, traktuje harness — warstwę wokół modelu, która decyduje o narzędziach, pamięci i kontekście — jako wymienny klocek, ulepszany osobno od samych wag. Na Qwenie 3.5 9B sama przebudowa harnessu podnosi wynik na GAIA z 33,97% do 41,67%, a douczenie modelu RL-em dociąga go do 55,77%; ten sam schemat na GPT-5 idzie z 62% do 84%. Skłaniam się ku tezie, że architektura agenta to dźwignia, po którą sięga się za rzadko, ale liczby podał sam autor na jednym benchmarku, w wersji 0.1.0 beta, i wciąż czekają na niezależne powtórzenie.
Copilot dołożył pierwszy otwarty model, tańszy i wyraźnie słabszy
3 min
GitHub Copilot po raz pierwszy dopuścił do menu model z otwartymi wagami, Kimi K2.7 od chińskiego Moonshot AI, na razie na podstawie wpisu na blogu Microsoftu, a nie oficjalnego ogłoszenia GitHuba. Cała rzecz to jeden kompromis: taniej, ale słabiej, bo na testach kodowania model ustępuje czołówce, za to autonomiczna sesja agenta schodzi z około 0,55 do 0,07 dolara. Broni się jeden wynik, 60,4% na SWE-Bench Verified, ale uruchomienie pełnej wersji u siebie to około 577 GB pamięci, więc realną drogą i tak zostaje tańsze API.
Po co trzymać dwa modele naraz, skoro jeden potrafi podpowiadać sam sobie?
4 min
NVIDIA pokazała Nemotron-Labs-Diffusion, model, w którym jeden zestaw wag pełni obie role znane z dekodowania spekulacyjnego: sam sobie podpowiada blok tokenów i sam je weryfikuje, dzięki czemu nie trzeba trzymać w pamięci drugiego, pomocniczego modelu. W teście SPEED-Bench przyjmował średnio 6,82 tokenu na krok wobec 2,75 u Eagle3, a wariant 8B dawał czterokrotnie wyższą przepustowość niż Qwen3-8B przy niemal niezmienionej jakości, 62,81% wobec 63,61%. To na razie preprint samej NVIDIA, bez recenzji, ale wagi w wersjach 3B, 8B i 14B leżą już na Hugging Face na licencji komercyjnej.
Zamba2-7B-Instruct: szybki i oszczędny, ale słaby w rozumowaniu
3 min
Zyphra wypuściła Zamba2-7B-Instruct, czatowy model zbudowany głównie z bloków Mamba2, który stawia na szybkość i niskie zużycie pamięci zamiast na rozumowanie. Na IFEval, sprawdzającym trzymanie się instrukcji, dostaje 69,95, mocno jak na ten rozmiar, ale na MATH ma tylko 13,57, a na doktoranckim GPQA 10,28, poniżej progu samego zgadywania. Niskie opóźnienie dostaniesz dopiero po skompilowaniu bibliotek mamba-ssm i causal-conv1d, bez nich przewaga architektury znika. To wąskie narzędzie do wykonywania poleceń tam, gdzie liczy się pamięć i każda milisekunda, a nie do rozwiązywania łamigłówek.
Dlaczego otwarty GLM-5.2 tak dobrze pisze kod? Zhipu uchyla przepis
3 min
Zhipu AI opublikowało na arXiv pracę opisującą SAO, metodę trenowania przez uczenie ze wzmocnieniem, która stoi za dobrymi wynikami otwartego modelu GLM-5.2 na zadaniach kodowania. SAO rezygnuje z grupowego porównywania prób znanego z GRPO, bierze jedną próbę na zadanie i wraca do osobnego modelu wartości, dzięki czemu asynchroniczne trenowanie ma być stabilne i lepsze niż GRPO na benchmarkach kodowania. Autorzy nie podają jednak liczb ani marginesu przewagi, a nikt z zewnątrz wyników nie odtworzył. Najciekawsze jest to, że chińska firma w ogóle wyłożyła swój przepis na RL.