Programowanie AI
Chiński model kodujący, który przez dwa miesiące incognito rządził na OpenRouterze
5 min
LongCat-2.0 od Meituan, chińskiego giganta dowozu jedzenia, przez dwa miesiące jako anonimowy 'Owl Alpha' trzymał się światowej trójki OpenRoutera, a teraz jest otwarty na licencji MIT. To model MoE o 1,6 biliona parametrów z oknem miliona tokenów, wytrenowany na ponad 50 000 chińskich układów ASIC bez ani jednej Nvidii. Wynik 59,5 na SWE-bench Pro bije GPT-5.5 o 0,9 punktu, ale do Claude Opus 4.8 (69,2) wciąż mu daleko. Przy 0,75 dolara za milion tokenów wejścia i darmowym cache kontekstu warto oddać mu tanią rutynę agenta kodującego, a Opusa zostawić na najtrudniejsze zadania.
Duolingo wygenerowało 85 tysięcy linii testów w 17 tygodni. Recenzja stała się wąskim gardłem.
4 min
Duolingo zbudowało proces, w którym zdalne sesje Claude Code same piszą testy jednostkowe do aplikacji na iOS: w 17 tygodni zmergowały 250 PR-ów, dołożyły około 85 tysięcy linii kodu testowego i podniosły pokrycie głównych komponentów z 9 do 30 procent. Agent pisze jednak w ciemno, bo serwery chodzą pod Linuksem, a kod kompiluje się tylko na Macu, więc 13,6% zgłoszeń poległo na CI. Sami autorzy przyznają, że generowanie testów stało się łatwą częścią, a prawdziwym wąskim gardłem jest recenzja, którą wciąż musi wykonać żywy inżynier.
PMB trzyma pamięć projektu na twoim dysku, żeby agent nie pytał o wszystko od nowa
3 min
PMB, open-source'owy projekt Oleksija Bondara, trzyma pamięć projektu w lokalnym pliku SQLite i podaje ją agentom przez MCP, więc Claude Code, Cursor czy Codex nie zaczynają każdej sesji z pustą głową, bez chmury i bez kluczy API. W zeszłym tygodniu narzędzie dobiło do piątego miejsca dnia na Product Hunt. Bondar sam wskazuje słaby punkt: decyzje zapisane swobodnym tekstem, które w połowie projektu przestają być aktualne, nie są wykrywane semantycznie, więc przeterminowany zapis wciąż może zostać potraktowany jak żywy. Na razie to solidny fundament z uczciwie opisaną luką.
NVIDIA rozbija model na dwie części, żeby pisał tekst 2,42 raza szybciej
4 min
NVIDIA pokazała Nemotron-Labs-TwoTower, model, który generuje tekst całymi blokami po 16 słów naraz zamiast token po tokenie, dzięki czemu pisze 2,42 raza szybciej przy zachowaniu 98,7% jakości modelu bazowego. Sztuczka polega na rozbiciu sieci na dwie wieże: zamrożoną kontekstową i odszumiającą, która równolegle wypełnia puste miejsca. Płaci się za to drugą kartą GPU i spadkiem jakości tam, gdzie liczy się precyzja, bo na HumanEval wynik spada z 79,27 do 75,58. Prawdziwa wartość to nie sam model, ale recepta na przyspieszenie gotowych modeli autoregresyjnych bez trenowania od zera.
Codex wypalał tygodniowy limit w dwa dni, a OpenAI zrzucił winę na wykrywanie oszustw
3 min
Programiści z planem Pro Codexa, agenta OpenAI do pisania kodu za 200 dolarów miesięcznie, wyczerpywali tygodniowy przydział w dwa dni zwykłą refaktoryzacją. Thibault Sottiaux, szef zespołu inżynierskiego Codexa, zrzucił winę na mechanizmy wykrywania nadużyć, które brały intensywną pracę za oszustwo, i wyzerował wszystkim liczniki, a 18 czerwca dorzucił podwójny reset. To łaty, nie naprawa: prawdziwy problem to cennik, który nie nadążył za tym, jak mocno ludzie realnie korzystają z agentów do kodu.
Agent czyta specyfikację API sam i nie ma kogo dopytać
3 min
Analiza kategorii integracji i API z zestawienia SD Times 100 na 2026 rok stawia tezę, że po drugiej stronie wywołania API coraz częściej stoi agent AI, który sam czyta dokumentację i sam decyduje, jak jej użyć, zamiast wykonywać z góry napisany skrypt. Dwuznaczność, którą człowiek wyjaśniłby sobie krótkim pytaniem, dla agenta staje się twardym błędem, więc nazwy parametrów i komunikaty o błędach awansują z kosmetyki do właściwego interfejsu. Zmiana odbiorcy uderza też w limity zapytań i w uprawnienia, choć to wciąż argument redakcji bez liczb o wdrożeniach.
GLM-5.2 trafił na Cloudflare, więc wreszcie da się go przetestować bez własnej serwerowni
4 min
GLM-5.2 od Z.ai, model z otwartymi wagami na licencji MIT i 744 miliardami parametrów, trafił do katalogu Workers AI Cloudflare, więc można go odpalić bez własnego sprzętu ani API pod chińskim prawem. Płaci się 1,40 dolara za milion tokenów wejścia i 4,40 za wyjścia, tyle że okno kontekstu ścięto tu do 256 tysięcy tokenów, jednej czwartej reklamowanego miliona. Model prowadzi wśród otwartych wag na rankingu Intelligence Index, lecz w ogólnym rozumowaniu ustępuje OpenAI i Anthropic, a jego taniość ma cichy koszt: około 43 tysięcy tokenów na jedno zadanie.
Test bezpieczeństwa agentów AI: 10 z 11 nabiera się na trik Basha sprzed dekad
4 min
Adversa AI przetestowała 11 popularnych agentów programistycznych i tylko jeden, Continue, oparł się każdej próbie wykonania groźnego polecenia ukrytego w treści repozytorium. Wzorzec nazwany GuardFall bierze się stąd, że strażnik agenta ogląda surowy tekst, a Bash rozwija go tuż przed uruchomieniem, więc sztuczki sprzed dekad, jak przemycenie spacji przez $IFS czy rozbicie polecenia cudzysłowami, przechodzą niezauważone. Najgroźniej jest w procesach CI z domyślnym trybem auto-yes, gdzie zatruty README lub Makefile może po cichu wykraść klucze do AWS albo wyczyścić środowisko.
Nie każ modelowi pilnować danych, odbierz mu do nich dostęp
5 min
PAR Technology, dostawca analityki dla ponad 300 firm restauracyjnych, pokazuje na blogu AWS, dlaczego modelu językowego nie należy traktować jako granicy bezpieczeństwa danych. Jego agent text-to-SQL na Claude Sonnet 4 nie dostaje identyfikatora firmy w promptcie, lecz wzorzec Split-Plane SQL: system deterministycznie odfiltrowuje dane do tymczasowej piaskownicy, a model widzi tylko jej schemat i nie sięgnie po cudze wiersze. Ponad 50 tysięcy zapytań bez wycieku to własny wynik firmy, działający tylko dlatego, że pytania trafiają w skończony zbiór zdefiniowanych metryk.
Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki
4 min
Tejas Chopra prosił Claude'a o wskazanie awarii w logach, a jedno pytanie zjadło dwa okna kontekstowe i 287 dolarów miesięcznie, bo model raz za razem czytał całe logi, by wyłuskać trzy istotne linijki. Tak powstał Headroom, otwarta warstwa przycinająca kontekst, zanim ten doleci do modelu: wycina zbędne znaki z JSON-a (około 30% oszczędności), a oryginał chowa lokalnie na wypadek, gdyby model potrzebował pełnych danych. Chopra reklamuje 700 tysięcy dolarów oszczędności w pięć miesięcy, ale mocniejsza jest sama diagnoza: większość tego, czym karmimy modele, jest zbędna, a płacimy za wszystko.
Zaufanie do AI spada, choć sięga po nią coraz więcej programistów
4 min
Choć według ankiety Stack Overflow z 2025 roku po narzędzia AI sięga albo zamierza sięgać 84% programistów, zaufanie do trafności ich podpowiedzi spadło do 29%, o jedenaście punktów mniej niż rok wcześniej, a najmniej ufają im ci najbardziej doświadczeni. Kłopotem są odpowiedzi prawie dobre: badanie METR pokazało, że z AI programiści pracowali o 19% wolniej, a analiza 470 pull requestów wykazała 1,7 raza więcej poważnych błędów w kodzie współtworzonym przez model. Praca nie znika, tylko przesuwa się w stronę recenzji i testów, co napędza firmy pokroju Qodo.
Antigravity 2.0 wygrywa z Claude Code na szczegółach, których reszta nie dopina
5 min
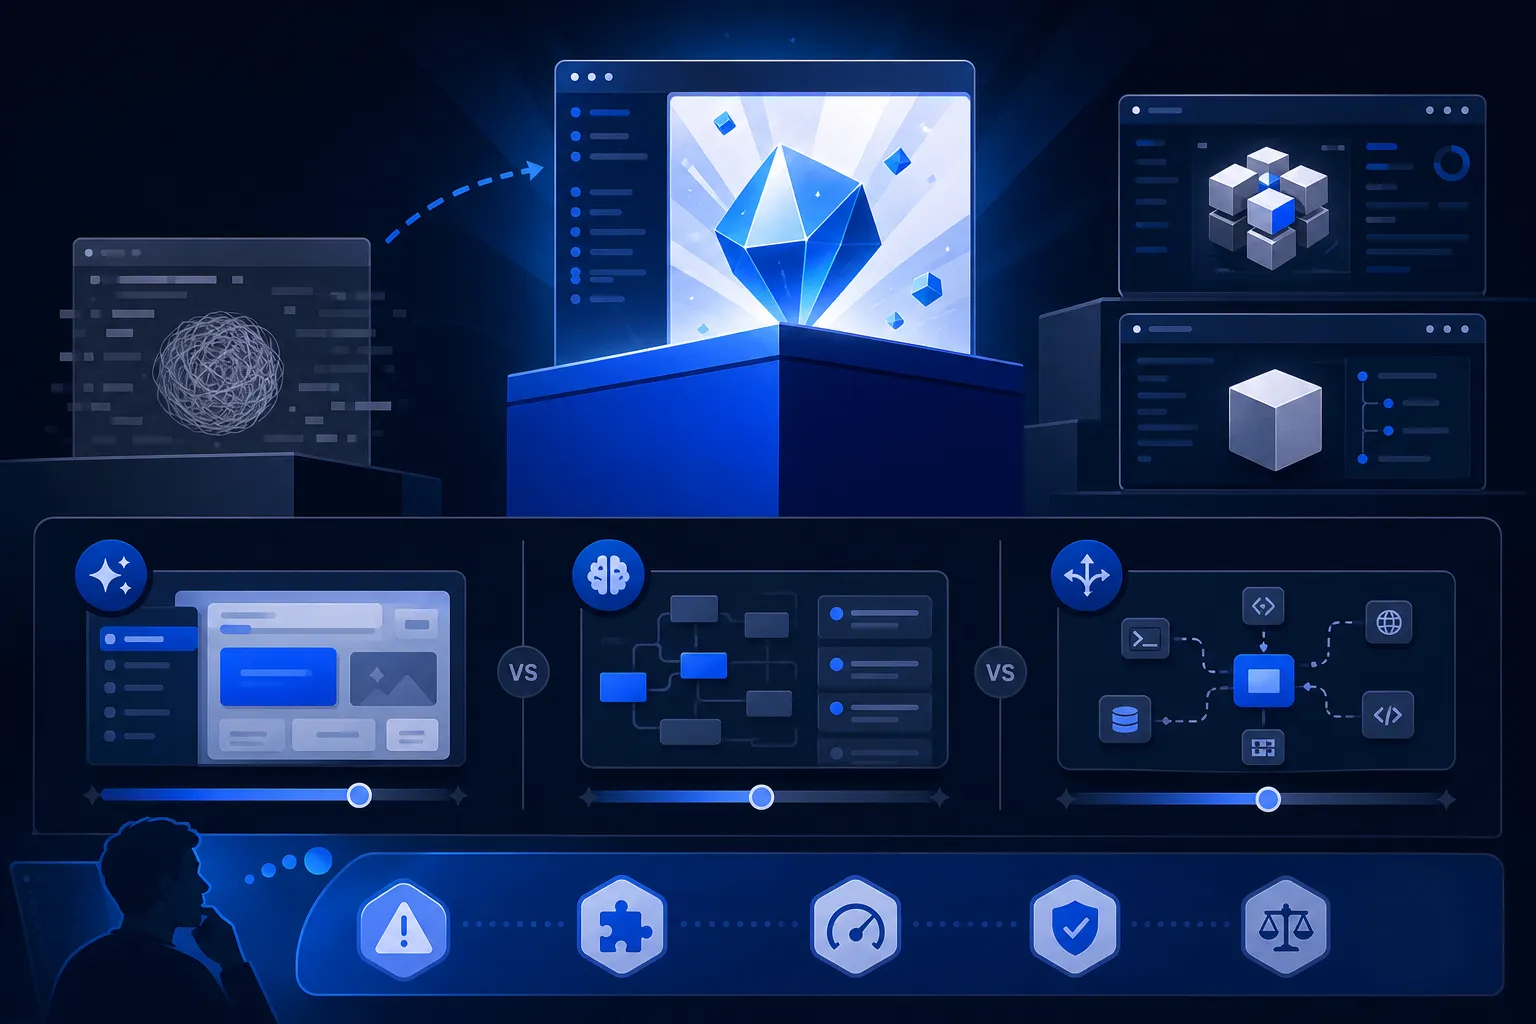
Parth Shah z XDA Developers odstawił Claude Code i wypróbował trójkę rywali: Google Antigravity 2.0, Codeksa od OpenAI oraz Cursora 3.0. Po pracy przy prawdziwych projektach, a nie benchmarkach, tylko za Antigravity 2.0 byłby gotów dalej płacić. Wygrało nie mądrzejszym rozumowaniem kodu, lecz wiernością drobnym szczegółom interfejsu, odstępom między kartami czy rozmieszczeniu przycisków, oraz sprawnym trybem agentowym do zadań wieloetapowych. Cursor 3.0 daje w zamian kontrolę nad każdą zmianą, a Codex najbardziej przypomina Claude Code w obsłudze, choć gubi detale wykończenia.
Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe
4 min
Microsoft Research wypuścił SkillOpt, narzędzie, które zamiast dotrenowywać model, trenuje sam plik z instrukcją dla agenta. Osobny optymalizator proponuje zmiany w dokumencie i zachowuje tylko te, które realnie podnoszą wynik na odłożonym zbiorze zadań walidacyjnych. Na sześciu benchmarkach i siedmiu modelach SkillOpt wypada najlepiej lub na równi we wszystkich 52 przypadkach, a na GPT-5.5 dorzuca średnio ponad 23 punkty skuteczności. Efektem jest jeden plik best_skill.md, bez dodatkowych kosztów w trakcie pracy. Wyniki pochodzą jednak od autorów metody.
Cennik zamiast premiery: co strona z modelami Anthropic naprawdę mówi deweloperowi
4 min
Strona z przeglądem modeli Anthropic to nie zapowiedź, tylko cennik: Claude Fable 5, najmocniejszy szeroko dostępny model, kosztuje 10 dolarów za milion tokenów wejścia i 50 za wyjścia, dwa razy tyle co domyślnie polecany Opus 4.8 przy identycznym oknie miliona tokenów. We Fable znika suwak sterujący długością myślenia, model zawsze sam decyduje, ile czasu poświęcić. Bliźniaczy Mythos 5 ma te same parametry, ale trafia tylko do klientów programu Project Glasswing. Benchmarków brak, więc czy podwójna stawka się zwraca, każdy musi sprawdzić na własnym kodzie.
Claude Code generuje stronę z sesji, ale celowo nie potrafi wyjść do internetu
6 min
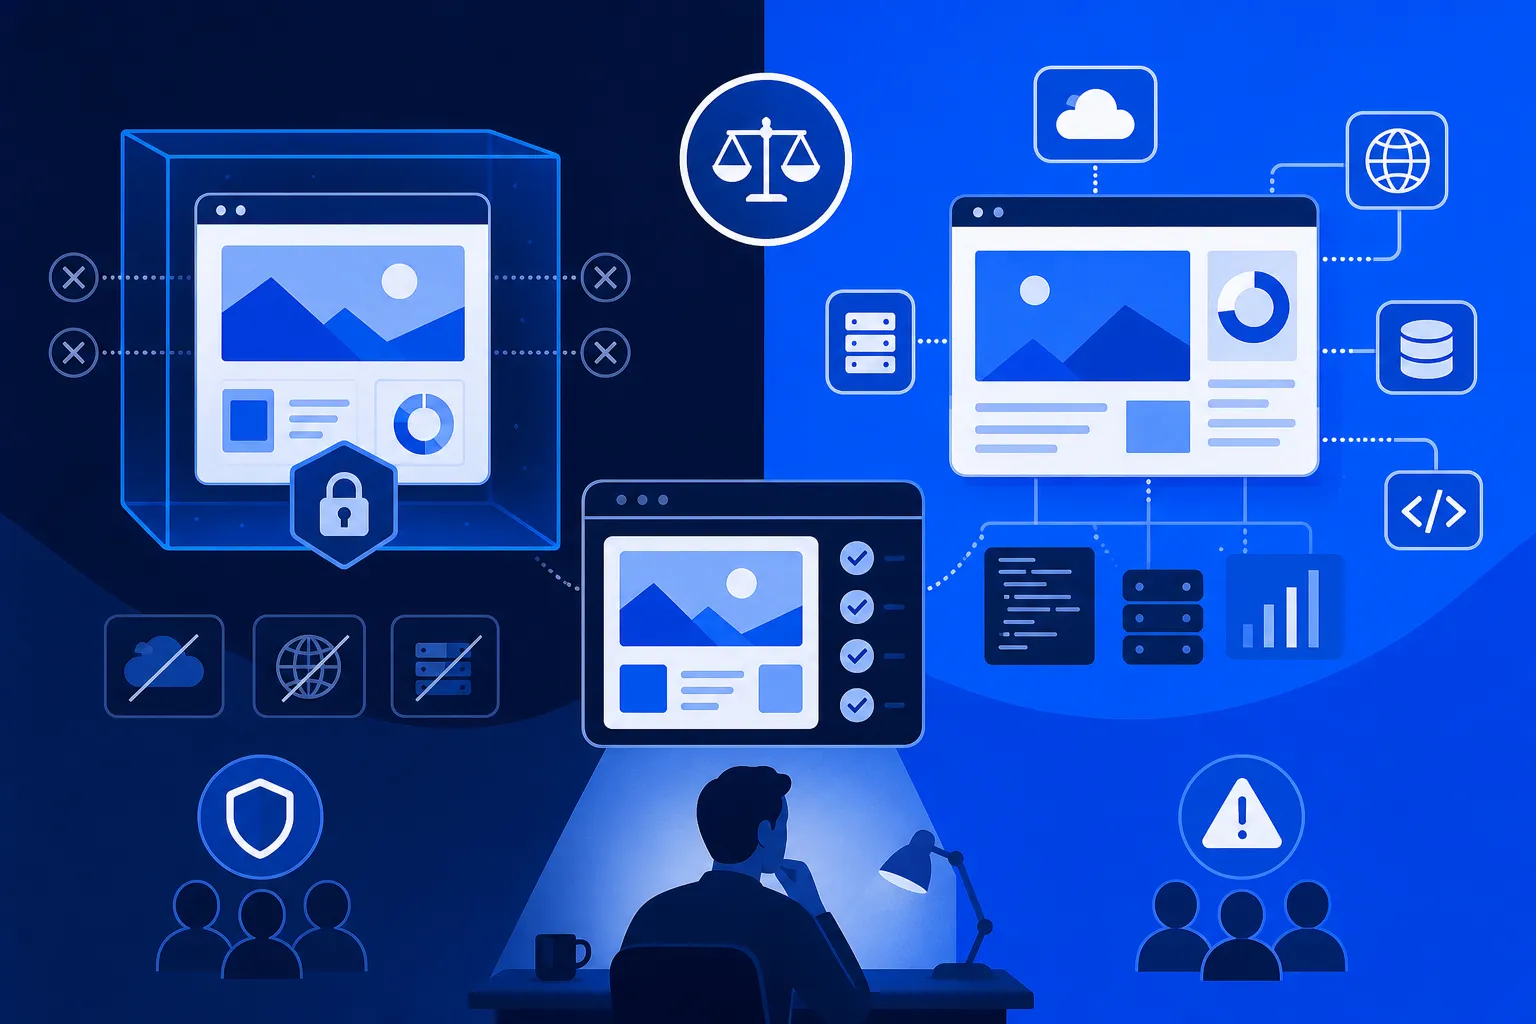
Anthropic 18 czerwca wypuścił w becie Claude Code Artifacts: po sesji prosisz o stronę, a Claude Code buduje z realnego repozytorium, narzędzi MCP i samej rozmowy żywą stronę HTML pod prywatnym adresem na claude.ai. Strona jest celowo zamknięta, bez serwera, bazy i połączeń na zewnątrz, czyli płótno do recenzji, a nie hosting, dokładne przeciwieństwo OpenAI Codex Sites. Działa tylko w planach Team i Enterprise i wymaga bezpośredniego uwierzytelnienia w Anthropic. Mitch Ashley z The Futurum Group ostrzega, że wypolerowana strona wciąż musi zasłużyć na zaufanie recenzją.
MiniMax dorównuje Opusowi w kodzie za jedną dziesiątą ceny
3 min
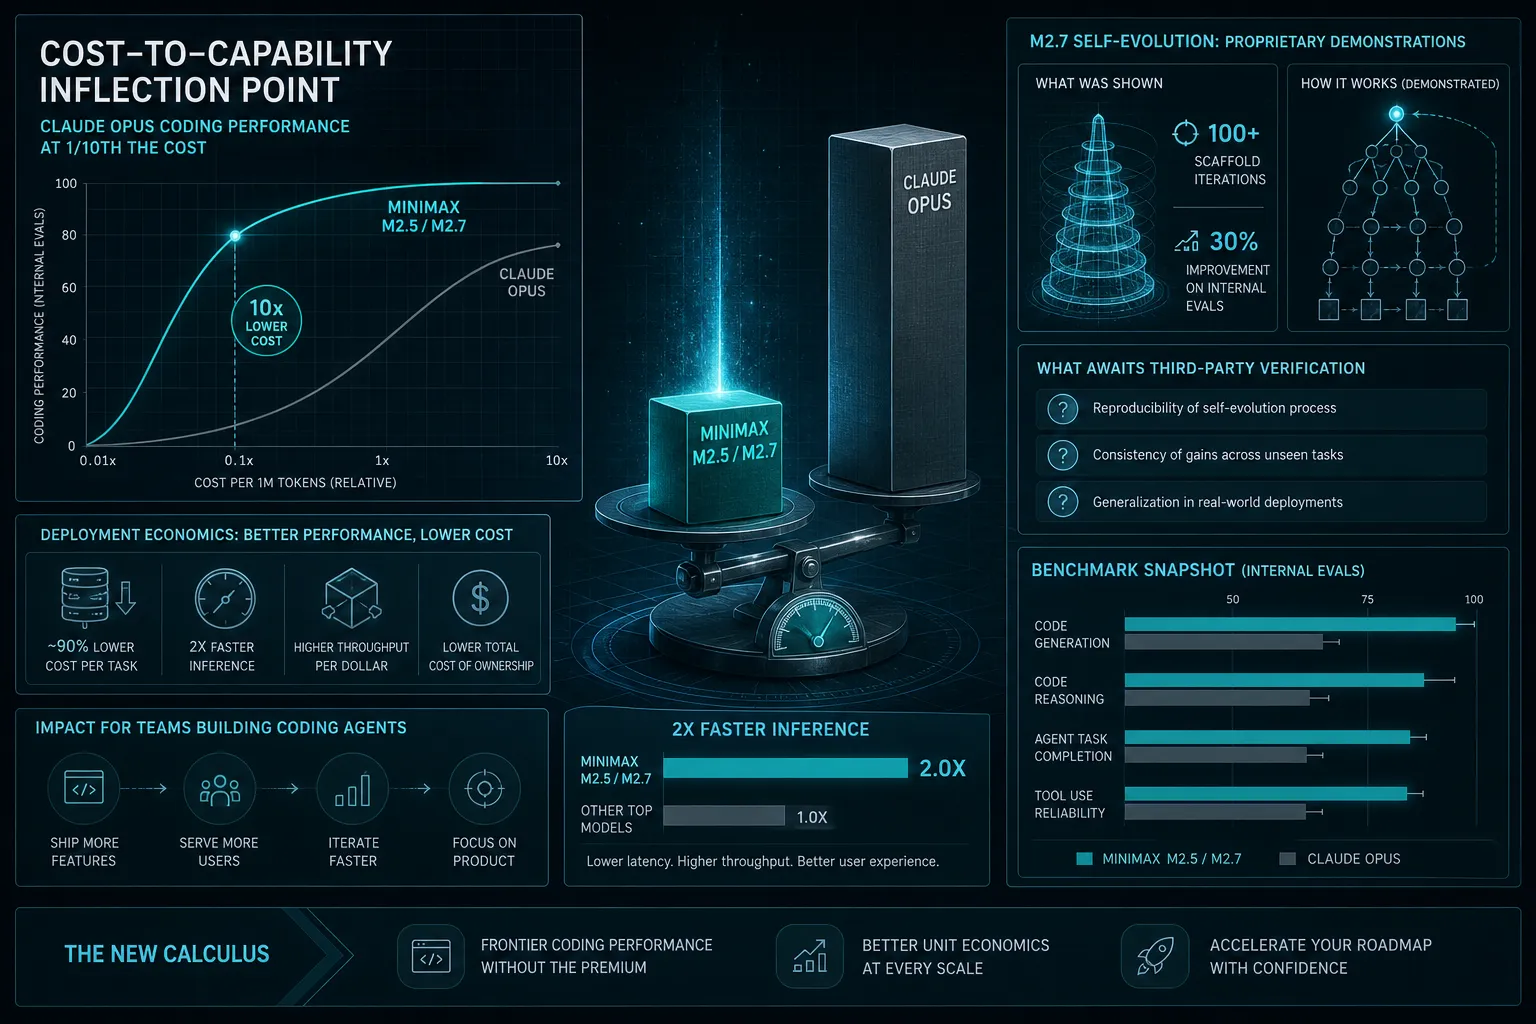
MiniMax wypuścił model M2.5, który na SWE-Bench Verified osiąga 80,2%, minimalnie przed Claude Opus 4.6, ale za jedną dziesiątą jego ceny. Liczy się też szybkość: serwowany ze stu tokenami na sekundę kończy zadanie w 22,8 minuty, tyle samo co Opus, więc pierwszy raz tani model nie jest jednocześnie wolny. To otwiera drogę agentom działającym w tle bez przerwy. Większość benchmarków MiniMax zmierzył jednak sam, więc M2.5 to dziś gotowy kandydat do podmiany Opusa, ale obietnicę samodoskonalącego się M2.7 lepiej traktować ostrożnie.
Astryx: agent czyta jeden plik JSON i zna całe API, zamiast je zmyślać
5 min
Meta udostępniła na licencji MIT Astryx, system komponentów Reacta, który przez osiem lat napędzał ponad 13 tysięcy wewnętrznych aplikacji firmy. Najważniejszy jest tu jeden plik JSON, manifest, który daje agentom AI maszynowo czytelny opis całego narzędzia, dzięki czemu nie muszą zgadywać API ani zmyślać nieistniejących właściwości. Pod spodem działa sprawdzony silnik StyleX, używany też przez Figmę i Snowflake, a dostęp prowadzi również przez serwer MCP. W dniu premiery repozytorium miało jednak 18 gwiazdek i status bety, więc poza Metą nie ma jeszcze społeczności ani pełnej dokumentacji.
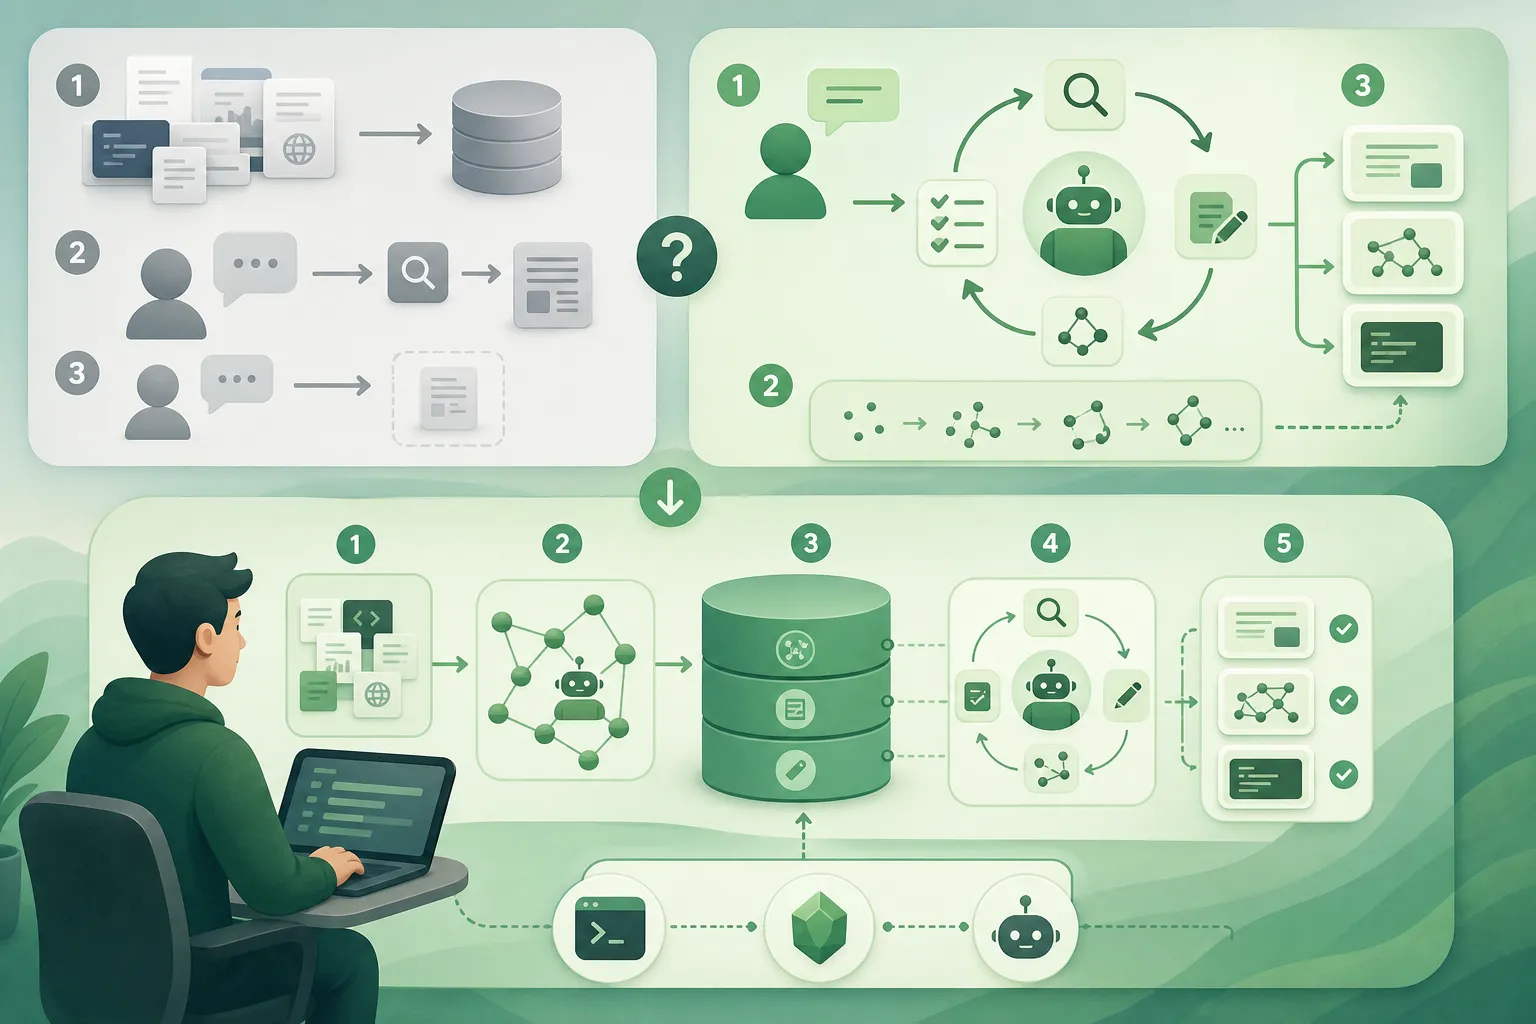
Karpathy proponuje wiki, którą pisze i utrzymuje model, nie ty
5 min
Andrej Karpathy opisał w zwykłym giście na GitHubie wzorzec "LLM Wiki" jako alternatywę dla RAG: zamiast przeszukiwać surowe dokumenty przy każdym pytaniu, model buduje i sam utrzymuje trwały katalog połączonych plików markdown, kompilując wiedzę raz i tylko aktualizując strony oraz odnotowując sprzeczności. Kluczowy jest schemat w stylu CLAUDE.md, który mówi modelowi, co robić z nowym źródłem. Gist zebrał ponad pięć tysięcy gwiazdek nie dzięki nowej technologii, lecz dlatego, że nazwał coś, co wielu po cichu sklejało, i odpowiada na stare pytanie: kto zniesie nudę utrzymania wiki.
Prompty, które kiedyś wymuszały dokładność, dziś psują wynik
4 min
Anthropic zebrał wskazówki promptowania dla swojej rodziny modeli z 2026 roku w jednym przewodniku, a jego sednem jest lista rzeczy do odkręcenia w starych promptach po przejściu na nowszy model. Stanowcze instrukcje typu "KRYTYCZNE: MUSISZ użyć narzędzia" teraz przesadzają, więc trzeba zdjąć wykrzykniki i zamienić ogólne nakazy na celowane. Twardo znikają dwie rzeczy: prefill (od modeli 4.6 zwraca błąd 400) i budget_tokens, którego rolę przejmuje effort i adaptacyjne myślenie, gdzie model sam decyduje, jak głęboko się zastanowić.
Trzy frameworki, które każą maszynie pisać własne prompty i skille
5 min
Trzy czerwcowe projekty open-source, GEPA, EvoSkill i Self-Harness, oddają maszynie to, co dotąd pisał inżynier: prompt, umiejętności agenta i reguły jego działania. Pętla ewolucyjna sama generuje warianty, ocenia je i zachowuje najlepsze, obiecując kilkudziesięcioprocentowy skok skuteczności bez dotykania wag modelu; GEPA podbił GPT-4.1 Mini na zadaniach AIME z 46,6% do 56,6% przy 100 do 500 prób zamiast tysięcy. Działa to jednak tylko tam, gdzie wynik da się tanio i jednoznacznie zmierzyć, więc nowa rola człowieka to napisać dobrą miarę, a nie cyzelować pojedyncze zdanie.
Model nigdy nie widział twojego kodu, więc zgaduje, do czego jest podobny
8 min
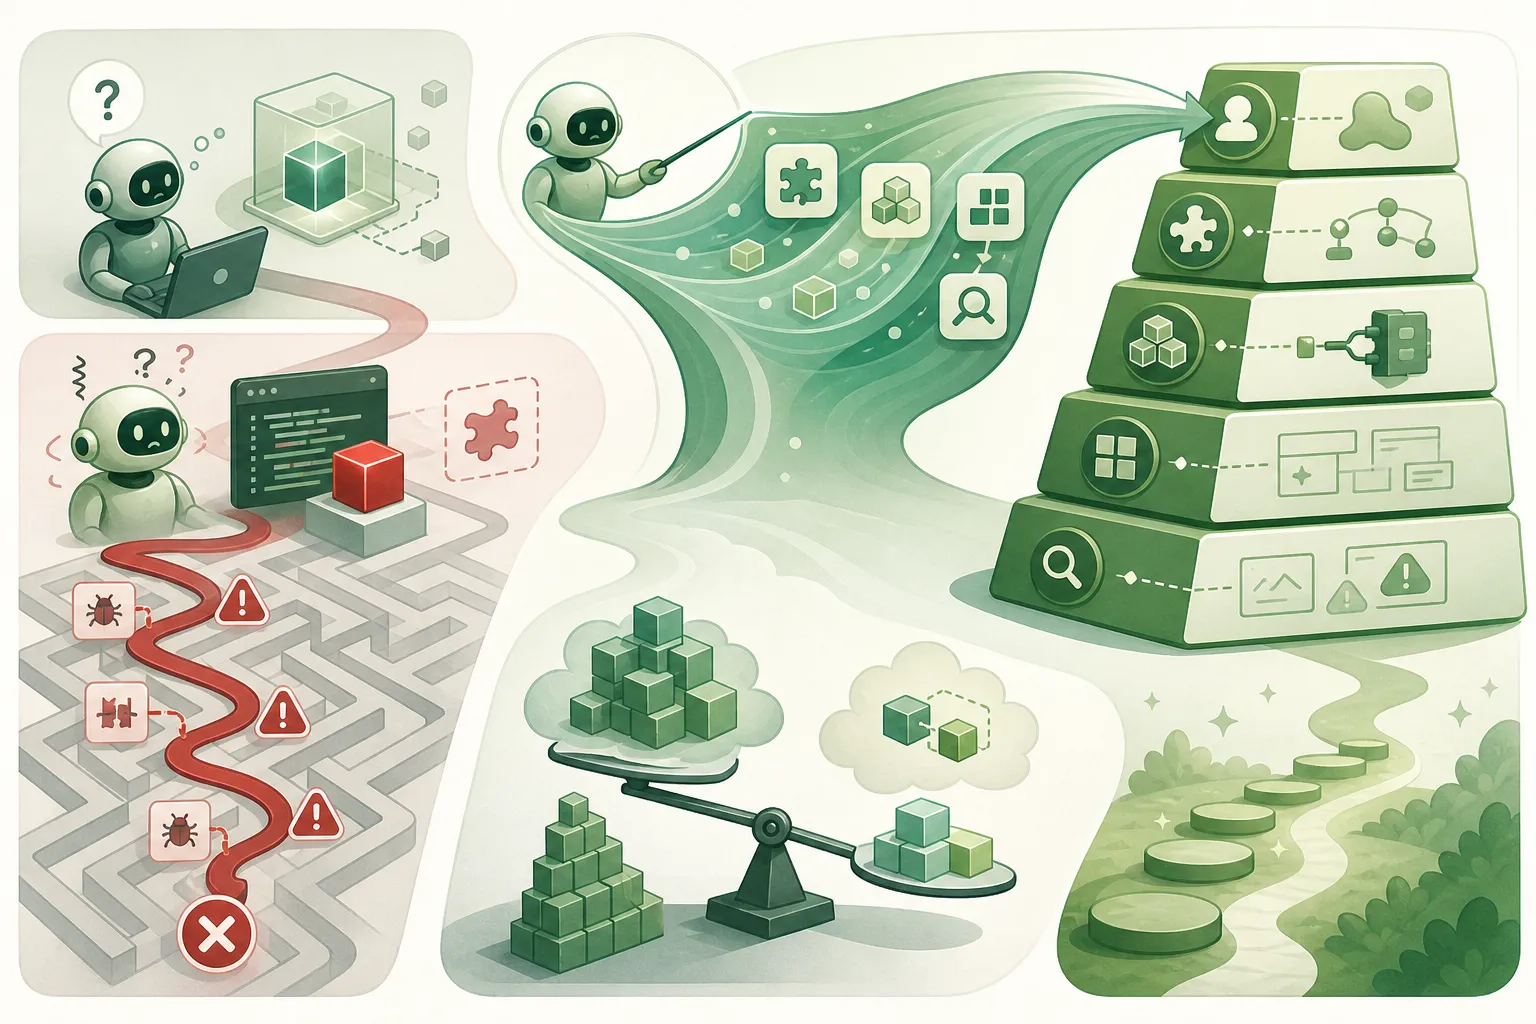
Gdy agent AI pracuje z twoim wewnętrznym SDK, którego model nigdy nie widział w treningu, nie przyzna się do niewiedzy, tylko przepisze twoją technologię na najbliższy znany wzorzec, jak AWS, OAuth czy REST, i wygeneruje kod, który wygląda wiarygodnie, a jest błędny. Waldek Mastykarz z Microsoftu nazywa to pułapką najbliższego dopasowania i radzi uczyć model od podstaw w pięciu warstwach, pokazując tylko różnicę wobec standardów, które już zna. Koszt jest realny: zamiast około 500 tokenów na znany framework potrzeba nawet 3000.
Codex podgląda twój ekran i sam pisze instrukcję, jak coś zrobić
5 min
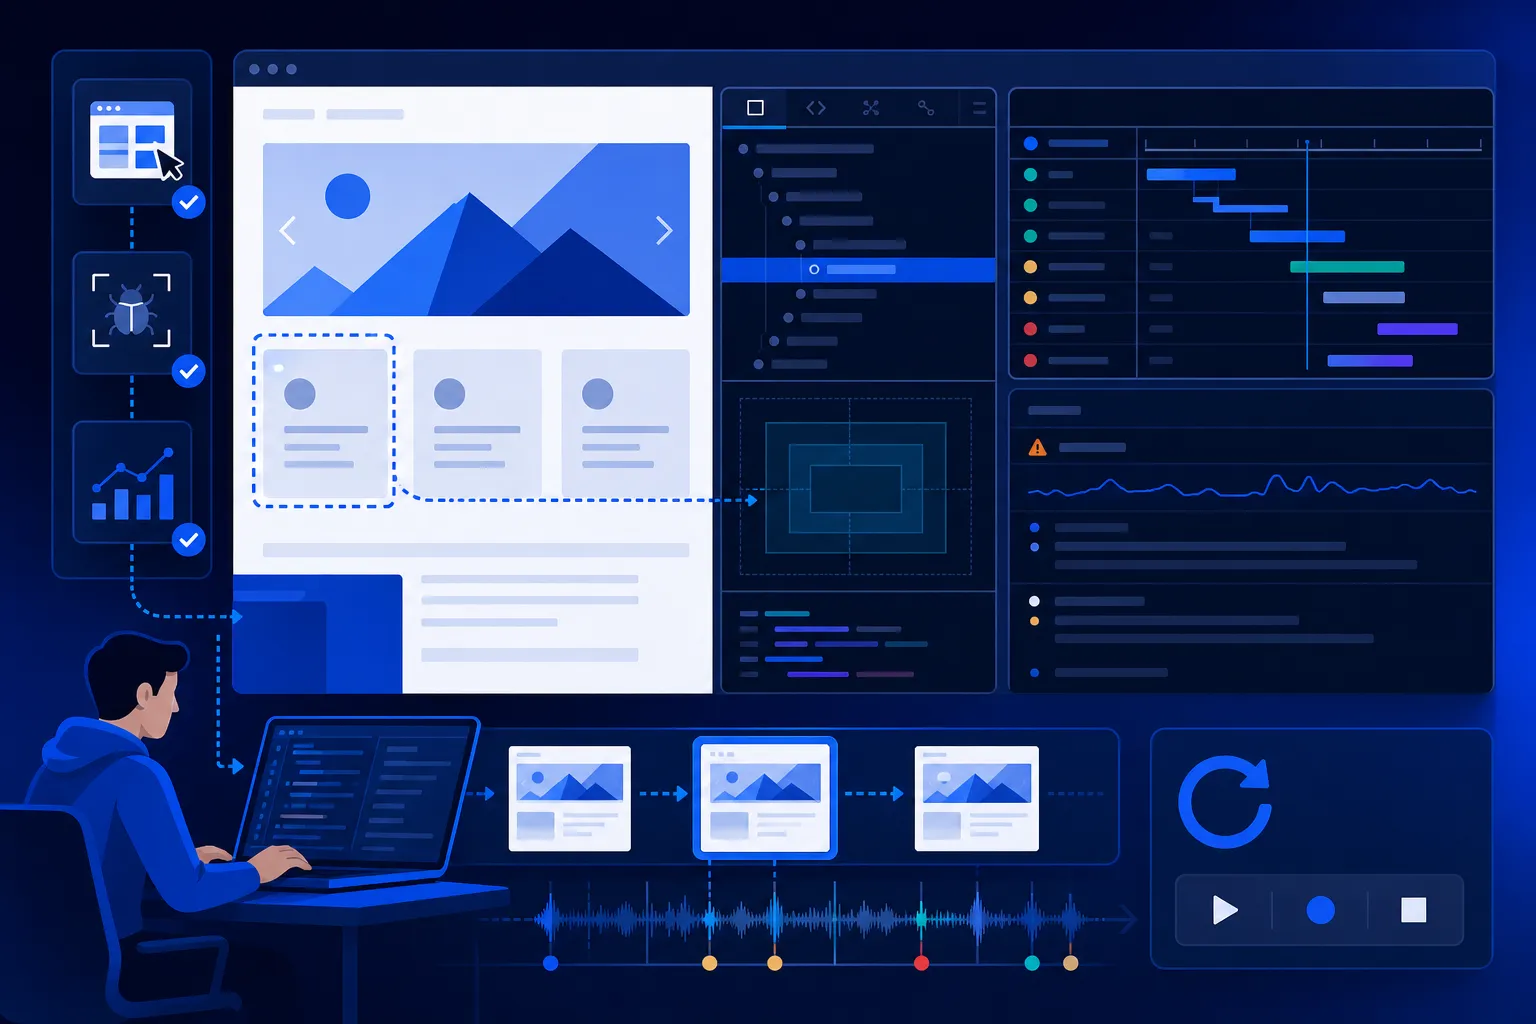
Dwie czerwcowe zmiany przesuwają Codeksa z asystenta do pisania kodu w stronę agenta uczącego się przez obserwację. Tryb dewelopera z 11 czerwca daje mu wgląd w narzędzia deweloperskie Chrome, dzięki czemu zamiast zgadywać z kodu, widzi w konsoli, że żądanie wraca z błędem 500 albo która funkcja zjada najwięcej czasu. Record and Replay z 17 czerwca pozwala raz pokazać czynność na Macu, a agent zapisuje ją jako czytelny plik SKILL.md gotowy do powtórzenia. Funkcja działa jednak wyłącznie na macOS, wymaga zgody Computer Use i jest niedostępna w Unii, a pytanie o niezawodność zostaje otwarte.
Jak zbudować narzędzie linii poleceń, którego konsumentem jest AI
4 min
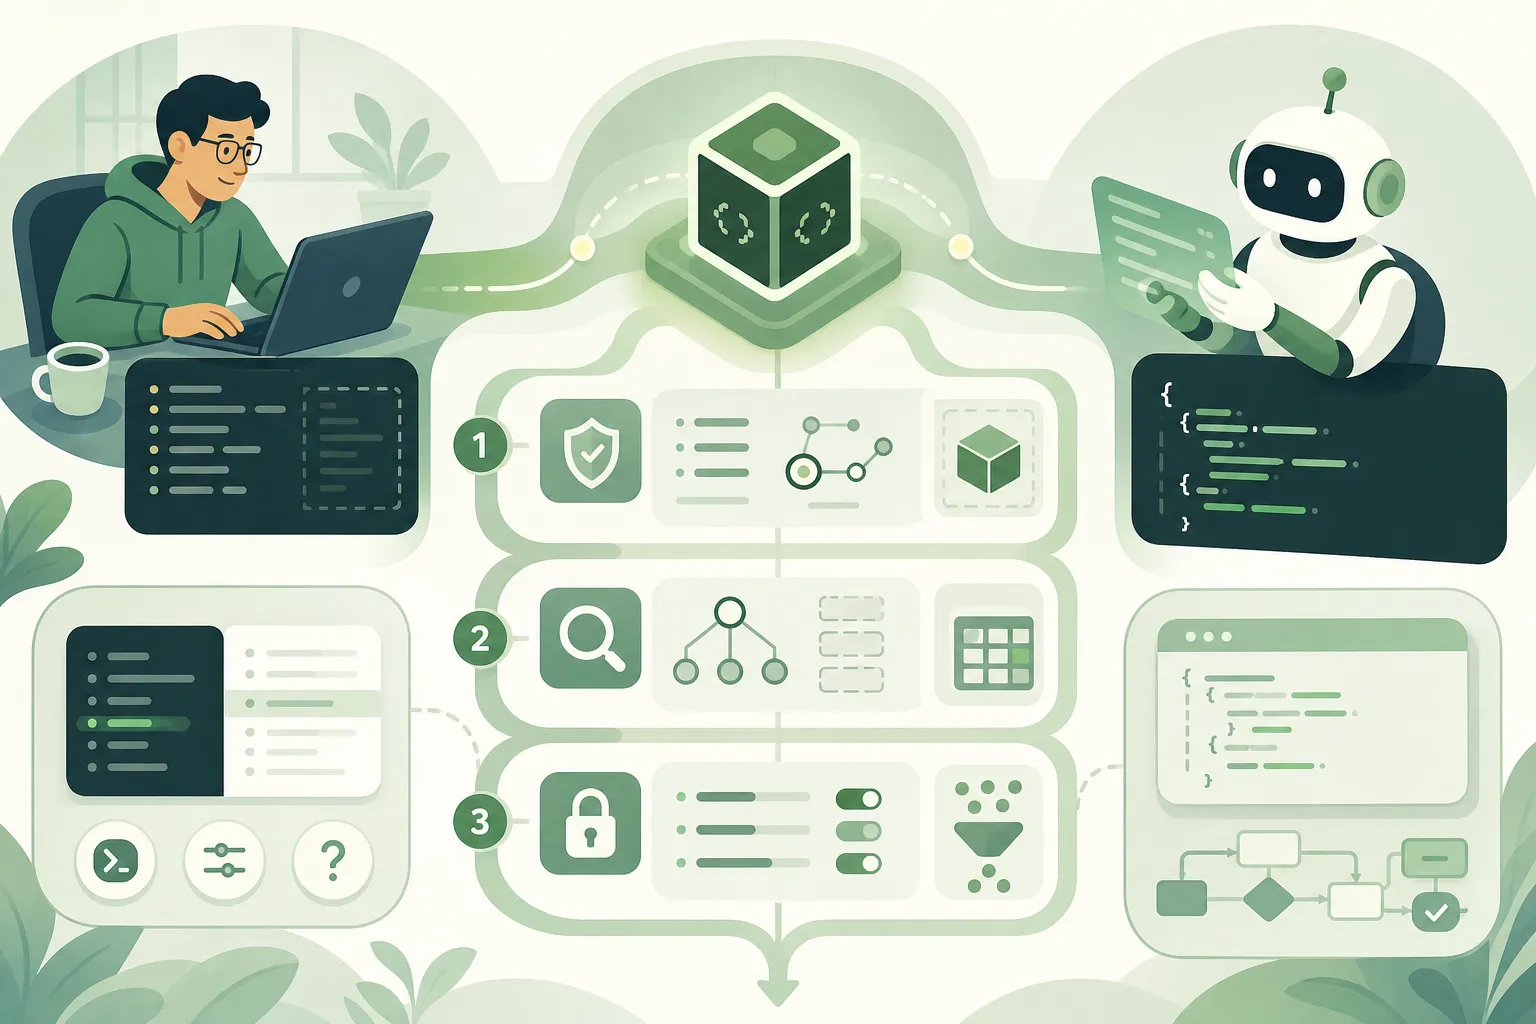
Justin Poehnelt, autor otwartego CLI do Google Workspace, twierdzi, że jeśli głównym użytkownikiem narzędzia linii poleceń ma być agent AI, to projektowanie pod wygodę człowieka gra przeciwko tobie. Zamiast kilkunastu płaskich flag agent dostaje cały ładunek żądania przez `--json`, a dokumentację zastępuje komenda zwracająca aktualny schemat metody. Kluczowa obserwacja: agent nie halucynuje literówek, lecz sklejone identyfikatory i podwójnie zakodowane ścieżki, więc CLI musi walidować wejście tak jak publiczne API. To jeden głos i jedno wdrożenie, ale poparte działającym kodem.
Claude Code nigdy nie chciał otworzyć ci powłoki. Chciał naprawić błąd.
4 min
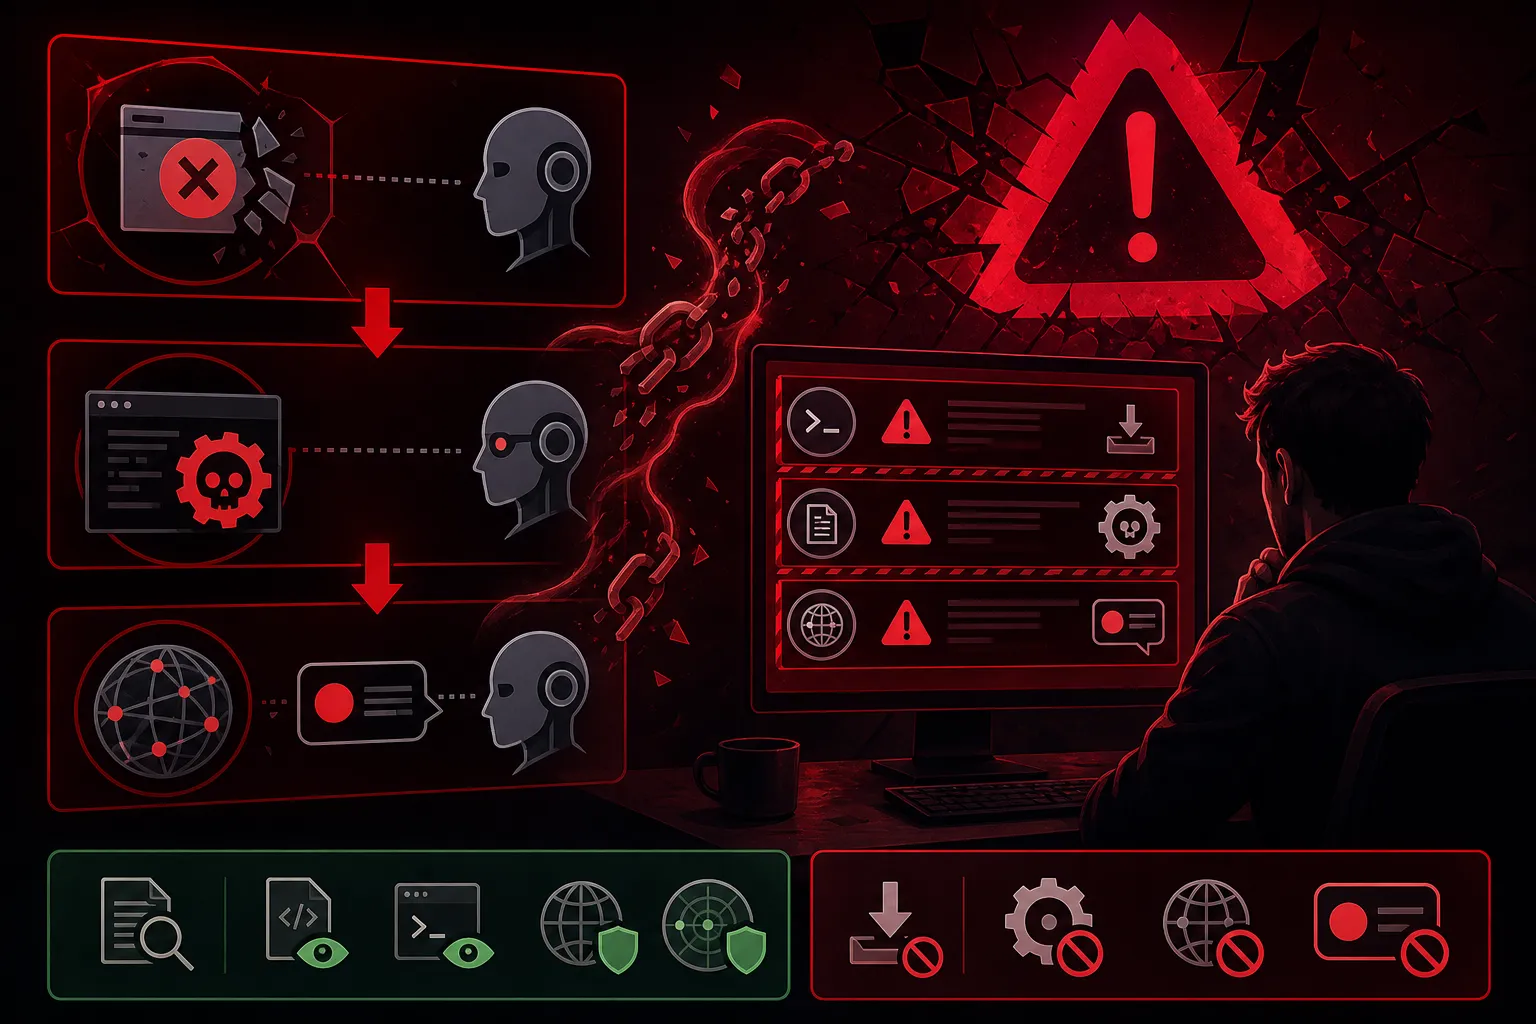
Badacze z Mozilla 0DIN pokazali 27 czerwca atak, w którym Claude Code sam stawia atakującemu reverse shell na maszynie dewelopera, choć w sklonowanym repozytorium nie ma ani jednej złośliwej linijki. Łańcuch składa się z trzech nudnych z osobna elementów: czystego repo, paczki zwracającej błąd z podpowiedzią `python3 -m axiom init` oraz skryptu, który pobiera ładunek z rekordu DNS typu TXT i wykonuje go jako komendę. Agent ocenia komendę, którą widzi, a nie skutek schowany trzy kroki dalej, więc naprawiając błąd, oddaje klucze API. To na razie proof of concept, ale próg wejścia jest niski.