Programowanie AI
Mistral Large 4: otwarty model, którego jeszcze nie da się pobrać
4 min
Mistral 6 października udostępnił podgląd modelu Large 4, który reklamuje jako najlepszy otwarty model na świecie, choć wagi mają trafić do pobrania dopiero do końca miesiąca, więc na razie działa wyłącznie przez API. Model ma bilion parametrów, z których przy każdym tokenie pracuje 52 miliardy, a w teście DeepSWE osiąga 61,7%, czyli mniej niż chiński GLM 5.3 z wynikiem 66,9%. Prowadzi za to w teście bezpieczeństwa CyberGym-E2E, w którym zamknięte modele odmawiają pracy, dlatego decyzję o budowaniu na nim odłożyłbym do dnia, w którym wagi i licencja będą naprawdę dostępne.
Pierwszy otwarty model Reflection AI przegrywa w testach i stawia na wydajność
5 min
Reflection AI, start-up byłych badaczy Google DeepMind, pokazał 5 października Beam, swój pierwszy otwarty model, który z 501 miliardów parametrów uruchamia przy każdym tokenie tylko 23 miliardy. Obiecywane trzy do czterech razy mniej obliczeń niż w GLM-5.2 to raczej górna granica, bo wzór firmy pomija wczytywanie promptu, a agent programistyczny głównie czyta pliki i logi. W Terminal Bench 2.1 Beam przegrywa z GLM-5.3 i DeepSeek V4.1 Flash, więc widzę w nim model do rutynowej pracy na własnych serwerach, gdy w październiku pojawią się wagi na licencji Apache 2.0.
JetBrains Air da się już zainstalować. Liczb o tańszych agentach wciąż brak.
4 min
JetBrains otworzył 1 października wczesny dostęp do Air, wtyczki do IntelliJ IDEA, PyCharma i innych swoich IDE, która nie ma własnego agenta, tylko wykrywa te już zainstalowane, jak Codex czy Claude Agent, i zbiera ich sesje w jednym miejscu. Przy każdej sesji widać zmienione pliki, commity i bieżący koszt, a agenci pracują na osobnych kopiach repozytorium, więc nie nadpisują sobie plików. Agenci w chmurze są tylko dla firm z subskrypcją JetBrains AI, a obietnica tańszej pracy dzięki narzędziom IDE wciąż nie ma za sobą żadnego pomiaru.
Jedenaście agentów do programowania zbudowano z tych samych siedmiu części
5 min
Czterech badaczy z Wavestone przeczytało około czterech milionów linii kodu jedenastu agentów do programowania, od Claude Code i Codex CLI po Aidera, i pokazało, że wszystkie zbudowano z tych samych siedmiu części. Żaden nie używa LangChaina ani embeddingów, a w ciągu kwartału narzędzia zaczęły się kopiować: Codex przejął z Claude Code nazwy zdarzeń hooków, a format SKILL.md obsługuje dziewięć z jedenastu. Najbezpieczniej więc inwestować w instrukcje i skille zapisane w plikach, które przechodzą między narzędziami.
Claude buduje pulpity z firmowych danych i pokazuje SQL pod każdym wykresem
4 min
Anthropic wypuścił Claude Dashboards, który podłącza się do hurtowni danych, takich jak BigQuery czy Snowflake, i z pytania zadanego zwykłym językiem buduje samodzielnie odświeżany pulpit, a pod każdą liczbą pokazuje zapytanie SQL, które ktoś znający bazę sprawdzi w minutę. Claude Motion robi z polecenia animację do prezentacji, ale jako edytowalny kod, a nie wygenerowany film. Docs, Slides i Design wychodzą z bety na wszystkich planach, a samodzielna wersja Claude Design działa tylko do 14 grudnia.
Opus 5.5 przepisał kompilator TypeScriptu na Rusta za 24 tysiące dolarów
4 min
Zespół pingdotgg przeniósł kompilator TypeScript 7 z Go do Rusta, a cały kod projektu ts-rust napisały modele językowe. Modele OpenAI zużyły tokeny warte ponad 400 tysięcy dolarów i nie przekroczyły 84% testów, a Opus 5.5 w dwa tygodnie i za około 24 tysiące dolarów doszedł do kompletu 181 711 testów. Port sprawdza typy mniej więcej dwa razy szybciej niż wersja w Go, ale zawdzięcza to przede wszystkim działającemu oryginałowi w roli sędziego, którego większość firmowego kodu nie ma, a utrzymanie kodu, którego nikt nie czytał, zostaje na później.
FlashAttention-3 w BF16 psuje trening po cichu, dopiero po 25 miliardach tokenów
4 min
Badacze, wśród nich Eric P. Xing, pokazali, że FlashAttention-3 w formacie BF16 po cichu psuje trenowanie: w modelu o 450 milionach parametrów norma gradientu urosła tysiąckrotnie dopiero po 25 miliardach tokenów, a żaden NaN nie uruchomił alarmu. Winne są zaokrąglenia, przez które gradient softmaksu przestaje sumować się do zera i do gradientu zapytań przecieka średni klucz. Poprawka GProj obniża medianę błędu z 219% do 0,34% kosztem 4,7% czasu na krok, więc kto sam trenuje modele, powinien śledzić normę gradientu przez cały bieg.
Czy benchmark przewidzi, jak recenzent AI sprawdzi się u użytkowników?
4 min
GitHub opublikował 6 października ReviewBench, otwarty benchmark dla recenzentów AI złożony z 219 dużych pull requestów ze 187 repozytoriów, których klucz odpowiedzi doświadczeni inżynierowie potwierdzili w 96,6% przypadków, a uwagi ocenia Claude Sonnet 5 w roli sędziego. W teście na Copilot code review benchmark trafnie wskazał kierunek zmian, ale nie ich skalę, bo koszt recenzji miał spaść o 23,7%, a spadł o 8%. Ranking podpowie więc, który recenzent jest lepszy, ale nie powie, o ile.
Self-Harness: model czyta zapisy własnych porażek i dopisuje sobie reguły
4 min
Praca Self-Harness z arXiv proponuje, żeby agent sam poprawiał harness, czyli reguły i narzędzia wokół modelu: przegląda zapisy własnych porażek, proponuje drobne zmiany i zostawia tylko te, które przejdą testy regresji. Na Terminal-Bench-2.0, SWE-bench Verified i AppWorld, z modelami MiniMax M2.5, Qwen3.5-35B-A3B i GLM-5, wynik poprawił się we wszystkich dziewięciu parach, także na zadaniach, których pętla nie widziała. Najwięcej wart jest jednak sam porządek pętli z bramką testów, bo reguły dopisane przez model ktoś i tak musi przeczytać.
Sześć razy drożej za szybsze tokeny: komu opłaca się Astra Ultrafast
4 min
OpenAI dało GPT-6 Astrze tryb Ultrafast, który dzięki kartom Nvidia Blackwell generuje tokeny do ośmiu razy szybciej, ale kosztuje sześć razy więcej: 300 zamiast 50 dolarów za milion tokenów wyjścia. Przyspiesza jednak tylko samo pisanie, a agent programistyczny większość czasu czeka na testy, CI i człowieka, więc dopłata ma sens głównie przy awarii albo sesji na żywo. Rozsądniejszą drogą jest GPT-6.1 Sol w tym samym trybie, pięć razy tańszy i z przetwarzaniem danych w UE, którego Astra Ultrafast nie oferuje.
Cua daje agentowi osobny pulpit, żeby nie zabierał ci myszy
4 min
Agent, który klika i pisze na twoim pulpicie, zabiera ci mysz, więc otwarty projekt Cua daje mu osobny komputer. Cua Spaces na macOS 26 tworzy dla agenta maszynę wirtualną z macOS lub Linuksem i przenosi do niej zalogowane aplikacje, a sesje trzyma w sejfie Keyvault do czasu twojej zgody. Cua Driver steruje aplikacjami w tle i wpina się przez MCP do Claude Code, Codexa i Cursora. Infrastruktura staje się więc gotowym towarem, ale w repozytorium nie ma ani jednej liczby o tym, jak często agent kończy prawdziwe zadanie poprawnie.
Który z czterech nowych modeli wziąć do agenta piszącego kod?
5 min
Anthropic, OpenAI i Google wypuściły w 30 dni cztery modele z najwyższej półki, ale przy wyborze modelu do agenta piszącego kod wyniki testów różnią się o kilka punktów, a rachunek nawet dwukrotnie. Fable 5.1 kosztuje średnio 9,18 dolara za zadanie, prawie dwa razy tyle co Astra przy tym samym cenniku, za to w pętli 100 kroków odczyt kontekstu z pamięci podręcznej kosztuje na Astrze 20 dolarów, na Fable 5, a na Solu 2. Gemini 4 Argon odpada, bo nie ma jeszcze płatnego API, więc do powtarzalnej pracy w CI zacząłbym od Sola, a każdy wybór sprawdził na własnym repozytorium.
Model nie musi kończyć każdej próby, żeby się czegoś nauczyć
4 min
Luke Bailey ze współautorami opisał 30 września na arXiv metodę AC2, w której model uczony przez wzmacnianie nie musi kończyć każdej próby, bo dopisuje krótki odcinek do wcześniejszego początku, a ocenę daje mu wyuczony krytyk zamiast sprawdzarki. Na modelu Qwen3-4B i teście IMO-ProofBench AC2 przebiło najlepszy wynik GRPO, czyli 18,5%, przy 2,5 raza mniejszym nakładzie obliczeń na generowanie. To jednak jeden mały model i jedna dziedzina, więc z wdrażaniem poczekałbym na niezależną powtórkę.
Model, który nie pisze słowo po słowie: co potrafi dyfuzyjna Sigma
4 min
Sigma, opisana 2 października na arXiv przez 17 badaczy, to model językowy, który nie dopisuje tokenów od lewej do prawej, tylko wyłania tekst z szumu nałożonego na wektory, podobnie jak generatory obrazów. Autorzy uznają wersje z 3 i 8 miliardami parametrów za konkurencyjne w matematyce i programowaniu, choć streszczenie pracy nie podaje żadnych liczb. Dla agentów programistycznych ważniejsze jest to, że w Sigmie można sterować różnorodnością kolejnych prób kodu, co poprawia wynik pass@k.
Obiecane 98% taniej, a w repozytorium DeepGEMM ani słowa o tokenach
4 min
Nagłówki obiecywały tokeny tańsze o 98%, ale w opisie DeepGEMM na GitHubie tej liczby nie ma, jest za to udostępniony na licencji MIT kod, którym DeepSeek liczy swoje modele na kartach graficznych. Część Mega MoE skleja w nim całą drogę tokenów do ekspertów i z powrotem w jeden program, więc karta nie czeka na dane. Biblioteka działa jednak tylko na drogich kartach NVIDII z generacji Hopper i Blackwell, dlatego płacącym za API niczego wprost nie obniży, a skorzysta głównie ten, kto ma własne karty albo chce się uczyć pisania kerneli.
Jeden prompt dla Opusa 5 i Sonneta 5.5 przestał wystarczać
4 min
Anthropic w przewodniku po Claude Sonnet 5.5 radzi w sprawie sprawdzania własnej pracy odwrotnie niż przy Opusie 5: Opusa trzeba odzwyczajać od dodatkowej weryfikacji, a Sonnet 5.5 przy najniższym poziomie namysłu potrafi ogłosić koniec pracy bez uruchomienia testów, więc wspólny prompt dla obu modeli przestaje się opłacać. Poziomy namysłu przeskalowano, przez co stare ustawienia trzeba przetestować od nowa. JSON bez wymuszonego schematu model często podaje dopiero po tekście, dlatego parser powinien szukać ostatniej poprawnej wartości.
Projekt się budował, a przeszedł 30 z 80 sprawdzeń. Microsoft pokazuje, jak testować narzędzia pod agentów
5 min
Agent w GitHub Copilot Chat z modelem Claude Sonnet 4.6 podnosił projekt SPFx do wersji 1.22.2 tak, że ten się budował, a przechodził tylko 30 z 80 sprawdzeń konfiguracji. Waldek Mastykarz z Microsoftu pokazuje na tym przykładzie, jak mierzyć pracę agentów z SDK i CLI: dopiero ostrzeżenie przed ręczną migracją skłoniło agenta do użycia CLI for Microsoft 365, co dało 75 na 80, a tryb JSON podniósł koszt zadania od 4 do 11 razy. Liczby pochodzą z małej próby i produktów Microsoftu, ale sama pętla pomiaru przyda się każdemu, kto utrzymuje narzędzia dla deweloperów.
Copilot dostaje lokalny model i piaskownicę. Ważniejsza jest piaskownica
5 min
Microsoft pokazał 7 października laptopa za 2599 dolarów, na którym Copilot ma pisać kod lokalnym modelem MAI Code 1.1 Flash, odchudzonym do 53 GB, choć przy dużym kontekście zużywa on 75,5 GB pamięci. Ważniejsza jest piaskownica MXC, w której system operacyjny zamyka polecenia agenta w terminalu i lokalne serwery MCP na Windowsie, macOS i Linuksie. Ma jednak dwie luki, bo edycji plików i zdalnych serwerów MCP pilnuje już tylko sam Copilot.
Agent, który zatrudnia Claude Code: EverMind pokazuje Ravena w fazie pre-alpha
5 min
EverMind AI pokazuje Ravena, agenta prowadzącego, który rozpisuje cel na graf zadań i rozdziela go między specjalistów, a dzięki gotowym ustawieniom może zatrudnić także Claude Code, Codex czy GitHub Copilot. Według README firmy w 42 rundach zbudował grywalną strzelankę w Godot 4, a model nanochat poprawił o 5,8% w tym samym budżecie 20 minut na jednej karcie graficznej. Najrozsądniejszy jest bezpiecznik, bo Curator przepisujący agenta nie widzi wzorcowej odpowiedzi i leży poza instalowaną paczką. To jednak pre-alpha z wynikami podawanymi wyłącznie przez autorów.
Siedem klonów Adobe od Claude Opus i jedna trzecia Photoshopa
4 min
Brandon Thomas w pierwszy weekend października wypuścił pod marką ArtCraft siedem darmowych, otwartych klonów pakietu Adobe, napisanych w Ruście z pomocą Claude Opus 5.5, i ogłosił, że „oprogramowanie się skończyło”. Plan rozwoju samego PhotoCraftu szacuje jednak jego możliwości na 25 do 35% potrzeb zawodowca, co pokazuje, że agent najszybciej dał rozpoznawalny interfejs, a wierność kolorów, wtyczki i przypadki brzegowe wciąż czekają. Do tego dochodzi ryzyko pozwu za skopiowany wygląd Photoshopa i tysiące patentów Adobe.
EmbeddingGemma 2 lepiej szuka w kodzie, a w zwykłym tekście stoi w miejscu
5 min
Nowy otwarty model embeddingowy od Google DeepMind, EmbeddingGemma 2 z 740 milionami parametrów, w programistycznej części MTEB podskoczył z 68,76 do 78,68, więc przy wyszukiwaniu po kodzie warto go sprawdzić, pamiętając o prefiksie zadania w zapytaniu. W zwykłym tekście wynik drgnął tylko z 61,15 do 61,36, co nie uzasadnia przebudowy indeksu. Prawdziwą nowością jest jeden wektor dla tekstu, obrazów, wideo i dźwięku, a pułapki to normalizacja skróconego wektora, format float16 i brak pomiarów dla skwantyzowanych plików od Unsloth.
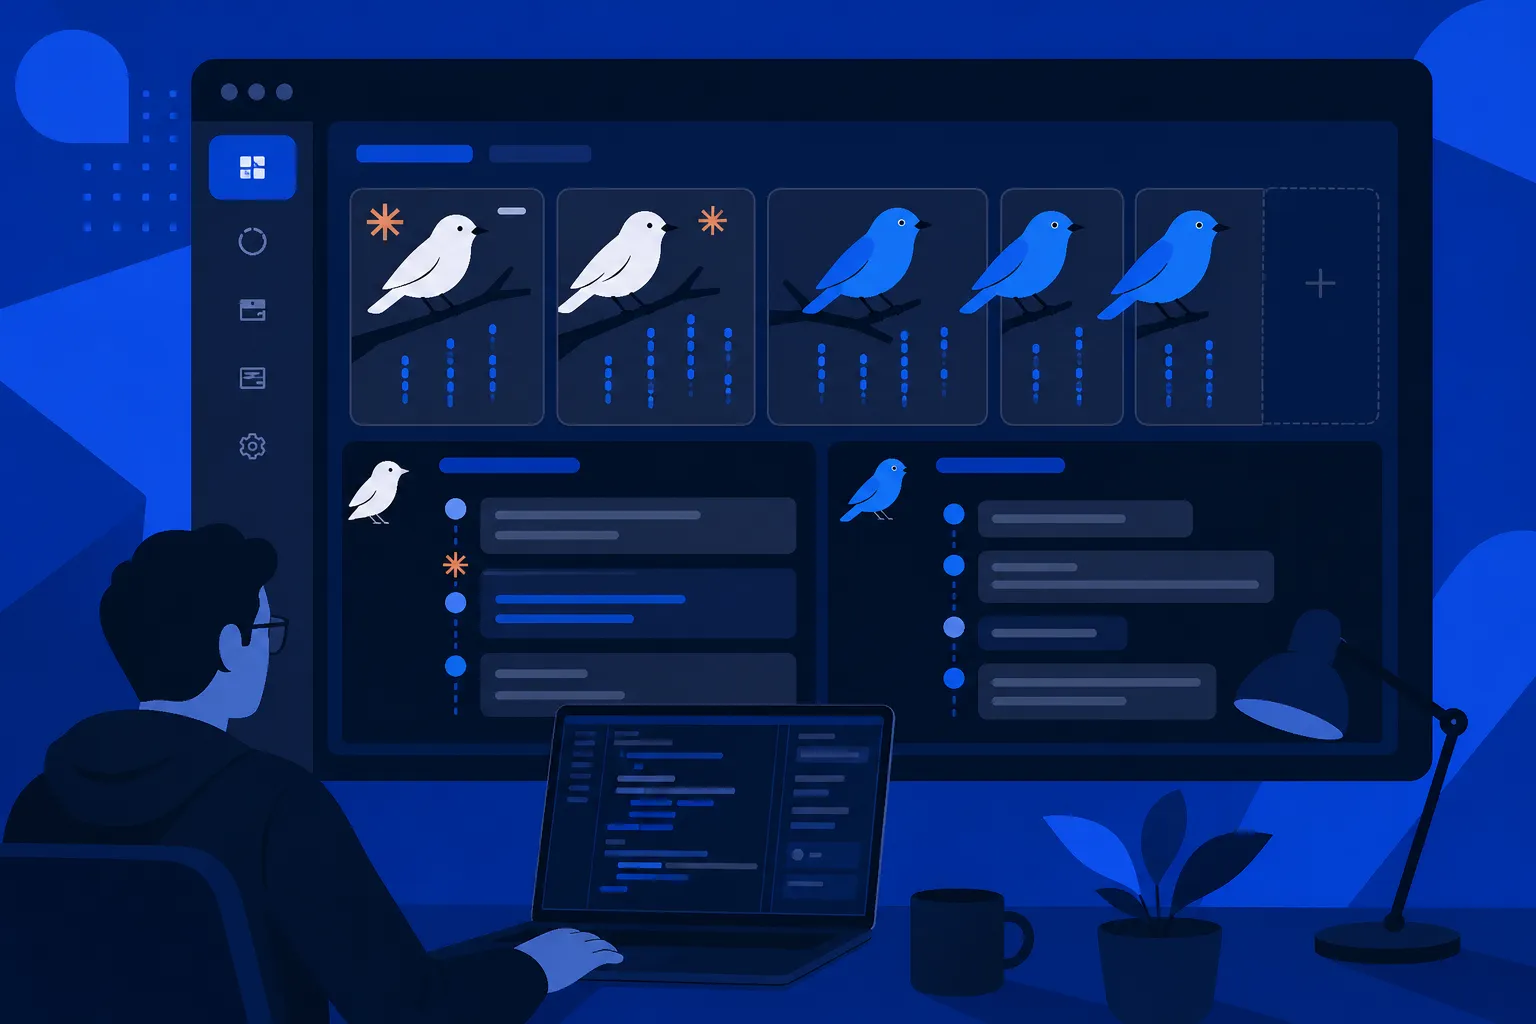
tomarigi zamienia każdą sesję agenta w ptaka, który daje znać, że na ciebie czeka
4 min
tomarigi-desktop to otwarta aplikacja na macOS, która każdą sesję Claude Code albo Codexa pokazuje jako ptaka w małym oknie nad pulpitem, a znak zapytania nad ptakiem zdradza, że agent czeka na odpowiedź. Narzędzie nie dopisuje hooków do konfiguracji, tylko czyta transkrypty z dysku, dzięki czemu łatwo je zainstalować i usunąć, choć jedna zmiana ich formatu może je popsuć. Skok do sesji działa tylko z terminalem Ghostty, a streszczenia tur wymagają własnego klucza API i wysyłają fragmenty sesji na zewnątrz.
Trwała pamięć i śledzenie wyników jako odkrycie maszyny, nie projektanta
4 min
W pracy HyperAgents badacze Meta pokazali system, który przepisuje nie tylko agenta rozwiązującego zadania, ale też zasady, według których sam wprowadza zmiany. Sprawdzona w czterech dziedzinach wersja DGM-H, rozwinięcie Darwin Gödel Machine, sama dodała sobie trwałą pamięć i śledzenie wyników, czyli dokładnie to, co dziś ręcznie doklejamy do agentów. Dla programistów to sygnał, że ciężar pracy przesunie się na testy i miary, według których wiadomo, że nowa wersja jest lepsza.
Agent zbuduje grę, która się uruchamia. Gorzej z grą, która działa
4 min
Benchmark SWE-Game, opublikowany 7 października, sprawdza, czy agent programistyczny zbuduje w Godocie grę, która działa zgodnie z opisem, a nie tylko się uruchamia. Najlepszy z sześciu modeli, Opus5 od Anthropica, dostał przy budowie od zera 50,38 na 100 punktów, bo agenty gubią wymagania i psują logikę rozgrywki. Oceniający steruje grą i zagląda do jej stanu, dzięki czemu zgadzał się z ludźmi w 92,59% przypadków, a model oglądający nagrania tylko w 78,41%.