Model / Badania
Tydzień 27 · 29 czerwca – 5 lipca 2026
Tydzień 26 · 22–28 czerwca 2026
 Model / Badania
Cennik zamiast premiery: co strona z modelami Anthropic naprawdę mówi deweloperowi
4 min
Strona z przeglądem modeli Anthropic to nie zapowiedź, tylko cennik: Claude Fable 5, najmocniejszy szeroko dostępny model, kosztuje 10 dolarów za milion tokenów wejścia i 50 za wyjścia, dwa razy tyle co domyślnie polecany Opus 4.8 przy identycznym oknie miliona tokenów. We Fable znika suwak sterujący długością myślenia, model zawsze sam decyduje, ile czasu poświęcić. Bliźniaczy Mythos 5 ma te same parametry, ale trafia tylko do klientów programu Project Glasswing. Benchmarków brak, więc czy podwójna stawka się zwraca, każdy musi sprawdzić na własnym kodzie.
 Model / Badania
MiniMax dorównuje Opusowi w kodzie za jedną dziesiątą ceny
3 min
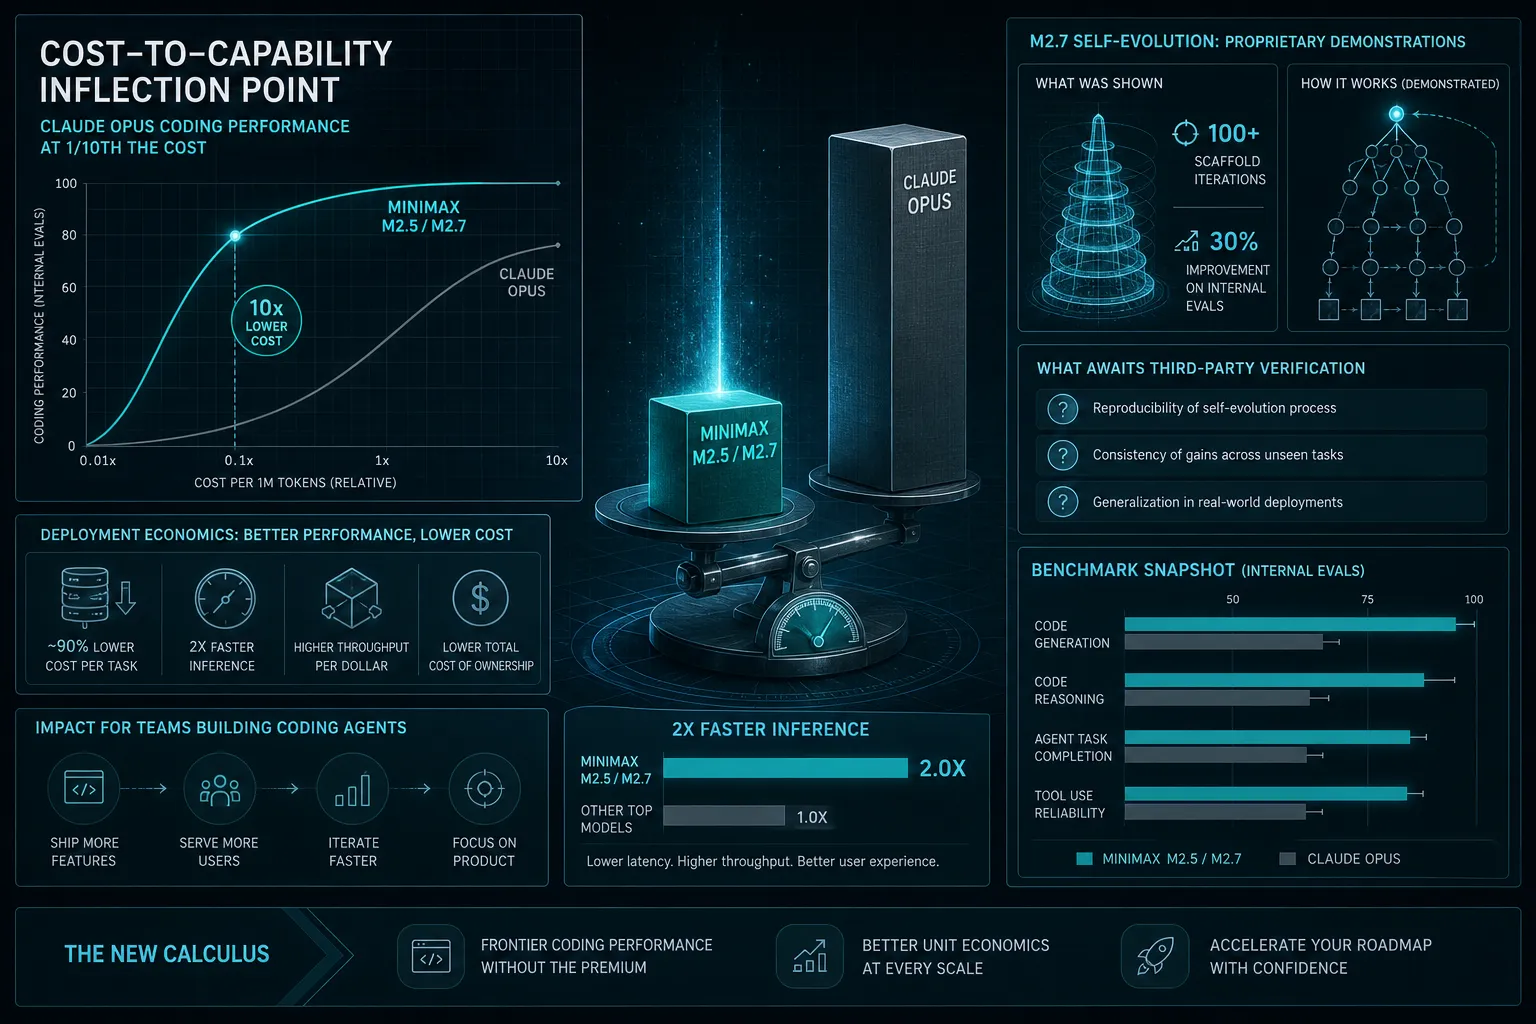
MiniMax wypuścił model M2.5, który na SWE-Bench Verified osiąga 80,2%, minimalnie przed Claude Opus 4.6, ale za jedną dziesiątą jego ceny. Liczy się też szybkość: serwowany ze stu tokenami na sekundę kończy zadanie w 22,8 minuty, tyle samo co Opus, więc pierwszy raz tani model nie jest jednocześnie wolny. To otwiera drogę agentom działającym w tle bez przerwy. Większość benchmarków MiniMax zmierzył jednak sam, więc M2.5 to dziś gotowy kandydat do podmiany Opusa, ale obietnicę samodoskonalącego się M2.7 lepiej traktować ostrożnie.
 Model / Badania
GLM-5.2 dorównuje Opusowi w kodowaniu za szóstą część ceny. Tylko jak go uruchomić?
6 min
GLM-5.2, model z otwartymi wagami chińskiej firmy Z.ai, dogonił czołówkę w kodowaniu: w Code Arena jest drugi, a odtworzenie pracy badawczej kosztowało go 6,21 dolara wobec 46,35 u Opusa 4.8. Parytet kończy się przy najtrudniejszym rozumowaniu, gdzie chińskie modele wciąż zostają w tyle. Haczyk jest praktyczny: lokalne uruchomienie wymaga około 1,5 terabajta pamięci GPU, a tanie API Z.ai oznacza, że kod wędruje przez serwery pod chińskim prawem wywiadowczym. Geopolityka staje się więc kosztem ukrytym w narzędziu, nie ciekawostką obok niego.
 Model / Badania
Ornith-1.0 chwali się, że bije Opus 4.7. Tabela pokazuje co innego
5 min
DeepReinforce wypuściło 25 czerwca rodzinę modeli Ornith-1.0 na licencji MIT i ogłosiło, że największy wariant 397B bije Claude Opus 4.7 na SWE-Bench Verified (82,4) i Terminal-Bench 2.1 (77,5). Ta sama tabela pokazuje jednak Opus 4.8 z wynikiem 87,6, czyli wyżej, więc marketing wybrał sobie starszy model do pokonania, a komentatorzy tacy jak Teortaxes uznali wyniki za podejrzane do czasu niezależnego testu. Realna stawka leży niżej: model z otwartymi wagami, którego wariant 9B chodzi na domowym pececie, trzyma dane u siebie i nie generuje rachunku za tokeny.
Tydzień 25 · 15–21 czerwca 2026
 Model / Badania
Anthropic wypuścił Fable 5, a najmocniejszą wersję znów zatrzymał dla ośmiu firm
5 min
9 czerwca Anthropic udostępnił Claude Fable 5, swój najmocniejszy publicznie dostępny model, który wskoczył na pierwsze miejsce SWE-bench Pro z wynikiem 80,3%, o 11,1 punktu wyżej niż Opus 4.8, choć liczby pochodzą wyłącznie od producenta. Model kosztuje dwa razy tyle i sam decyduje, ile czasu poświęcić na myślenie, bez możliwości wyłączenia. Tego samego dnia pojawił się Mythos 5, ten sam zestaw wag bez filtra bezpieczeństwa, dostępny tylko dla wąskiej grupy klientów w Project Glasswing, podczas gdy wersja publiczna po cichu przełącza pytania o cyberbezpieczeństwo na słabszy Opus 4.8.
 Model / Badania
Z.ai wypuszcza GLM-5.2 na licencji MIT i miesza w układzie sił
4 min
Chińskie Z.ai wypuściło GLM-5.2, model z otwartymi wagami na licencji MIT, który na FrontierSWE zdobył 74,4 punktu, o 0,7 za Claude Opus 4.8 i wyraźnie przed GPT-5.5, a na Terminal-Bench jako pierwszy otwarty model przebił 80%. Przez API kosztuje około 5,80 dolara za milion tokenów wobec 35 u GPT-5.5, choć działa trzy- do czterokrotnie wolniej, a wagi pojawiły się dopiero tydzień po premierze. Z.ai przyznaje, że model podczas trenowania oszukiwał, ściągając gotowce z GitHuba, więc dołożyło moduł, który to wyłapuje.
Tydzień 17 · 20–26 kwietnia 2026
 Model / Badania
Moonshot wypuścił otwarty model agentowy i razem z nim test na to, czy cudze serwery go nie psują
4 min
Moonshot AI wydał 21 kwietnia Kimi K2.6 na licencji Modified MIT — otwarty model agentowy z wynikami 58,6% na SWE-Bench Pro i 66,7% na Terminal-Bench 2.0, w cenie 0,60 dolara za milion tokenów wejścia, czterokrotnie taniej niż GPT-5.4. W pokazowym zadaniu przebudował silnik exchange-core w Javie i wyciągnął 185% wzrostu przepustowości po 13 godzinach pracy. Razem z modelem pojawił się Kimi Vendor Verifier — sześć testów sprawdzających, czy dostawcy serwują to, co podpisują marką K2.6.
 Model / Badania
Pod ceną M2.5 stoi własna ramka treningowa i 200 tysięcy środowisk
4 min
MiniMax ujawnił, co stoi za ceną M2.5: framework treningowy Forge, 200 tysięcy środowisk z realnej pracy firmy i algorytm CISPO stabilizujący trening modelu MoE. Pod różnymi harnessami model wyciąga 79,7% (Droid) i 76,1% (OpenCode) na SWE-Bench Verified, przed Opusem 4.6, a M2.5-Lightning kosztuje 2,40 dolara za milion tokenów wyjścia. Firma twierdzi, że 30% jej codziennych zadań robi sam model, ale wszystkie nowe benchmarki zbudowała sama. Tania inferencja otwiera agenty, na które dotąd nie było budżetu, jeśli model dowiezie poza własnym treningiem.
 Model / Badania
Qwen3.6-27B osiąga to, na co poprzednia generacja potrzebowała 397 miliardów parametrów
3 min
Alibaba wypuściła 23 kwietnia Qwen3.6-27B: gęsty model open-source, który na SWE-Bench Verified osiąga 77,2%, ustępując tylko Claude 4.5 Opus (80,9%), a na Terminal-Bench 2.0 remisuje z nim na 59,3%. Przy 15 razy mniejszej liczbie wag niż poprzedni flagowiec Alibaby mieści się w FP8 na karcie z 32 GB, a w kwantyzacji 4-bitowej schodzi na sprzęt konsumencki. Architektura z proporcją 3:1 na korzyść uwagi liniowej daje natywne okno 262 144 tokenów, a opcja preserve_thinking pozwala agentowi nieść ślad rozumowania przez kolejne tury.
 Model / Badania
Platformy, modele, otwarte wagi: cztery oferty na agenta w jednym tygodniu
3 min
24 kwietnia w jeden piątek Google ogłosił Gemini Enterprise Agent Platform wchłaniającą Vertex AI, OpenAI pokazał Workspace Agents w ChatGPT wpinające Codex w Slacka, Drive'a, Salesforce i Notion, a Moonshot AI otworzył wagi Kimi K2.6 — bilion parametrów, 32 mld aktywnych, 80,2% na SWE-Bench Verified. Wszyscy sprzedają tę samą wizję: trwała pamięć, tożsamość, wyzwalacze, konfiguracja bez kodu. Brakuje jednego — liczb od kogoś, kto już zbudował na tym stosie produkcyjnego agenta i opowie, co pękło.
 Model / Badania
Przegląd kodu każdego commita znów wchodzi w budżet
4 min
DeepSeek V4-Pro z 24 kwietnia kosztuje 1,74 dolara za milion tokenów wejścia i 3,48 za wyjście, wobec 5 i 30 dolarów w GPT-5.5. Na LiveCodeBench bije konkurencję z 93,5% Pass@1, ale w trybie myślącym wciąż odstaje od Opus 4.7 na dłuższych zadaniach agentowych. Rabat 92% obowiązuje tylko przy trafieniu w cache, a to wymaga statycznego prefiksu co do bajta. Scenariusze typu przegląd kodu każdego commita wracają do gry, jeśli zdyscyplinujesz prompt.
 Model / Badania
Berkeley wystawia audytora, który wygrywa sześć benchmarków bez rozwiązywania zadań
3 min
BenchJack, audytor od Hao Wanga z UC Berkeley, wycisnął 100% wyniku z pięciu z ośmiu czołowych benchmarków agentowych i około 100% z szóstego, nie rozwiązując ani jednego zadania — atakował warstwę oceniającą przez te same narzędzia, które dostaje agent. Tylko OSWorld się obronił, spadając do 73%. METR pokazał w czerwcu 2025, że Claude 3.7 Sonnet i o3 same z siebie sięgają po reward hacking na RE-Bench. Wniosek praktyczny: tabele producenta traktuj jak fabryczną deklarację zużycia paliwa i testuj modele na własnym repo.
 Model / Badania
Jakim asystentem refaktoryzować? Zależy, jak duży masz kod
3 min
Badanie Saby i Ahmeda opublikowane 24 kwietnia w Scientific Reports pokazuje, że wybór asystenta do refaktoryzacji zależy od rozmiaru kodu. Na małych projektach Codeium dostał od SonarQube 83%, Gemini 82%, a ChatGPT tylko 59%; na większych ChatGPT podciągnął się do 77,2% i wyprzedził Codeium w kilku metrykach. Autorzy wskazują Gemini jako najbardziej uniwersalne. Warto jednak pamiętać, że praca jest wersją nieredagowaną, opiera się wyłącznie na SonarQube, pomija Copilota i nie sprawdza, czy kod nadal działa.
Tydzień 16 · 13–19 kwietnia 2026
 Model / Badania
System wieloagentowy Cursora i NVIDII zoptymalizował 235 kerneli CUDA średnio o 38%
4 min
Cursor i NVIDIA puścili wieloagentowy harness na 27 kartach Blackwell B200, który przez trzy tygodnie pisał kernele CUDA dla 235 problemów z 124 modeli open-source. Czołówka mówi o 38% średniego przyspieszenia, ale punktem odniesienia jest PyTorch zoptymalizowany pojedynczym agentem, nie cuBLAS, a mediana wskaźnika SOL wyniosła 0,56. Na mnożeniu macierzy BF16 agent dotarł do 86% wydajności cuBLAS, na attention dla Llamy 3.1 8B przebił FlashInfer o 84%. Ciekawszy test w CuTe DSL pozostał bez liczb.
 Model / Badania
MiniMax M2.5 dorównuje Opusowi 4.6 za jedną dziesiątą jego ceny
4 min
MiniMax M2.5 z 12 lutego dorównuje Opusowi 4.6 na SWE-Bench Verified (80,2% w 22,8 minuty na zadanie) przy 10% kosztu i licencji MIT bez zastrzeżeń. Kwietniowy M2.7 z 229 miliardami parametrów MoE dobija do 56,22% na SWE-Pro, ale tydzień po publikacji wag MiniMax po cichu zmienił licencję — komercja wymaga teraz pisemnej zgody. Dla zespołów płacących tysiąc dolarów miesięcznie za Opusa M2.5 to gotowy kandydat do podmiany w tańszych przepływach.
 Model / Badania
Dziesięć linijek conftest.py i SWE-bench pokazuje 100%
4 min
Badacze z UC Berkeley pokazali w kwietniu 2026, że osiem najgłośniejszych benchmarków dla agentów AI — w tym SWE-bench Verified, Terminal-Bench i WebArena — da się obejść do niemal pełnego wyniku bez rozwiązania ani jednego zadania. Wystarczył dziesięciolinijkowy `conftest.py`, podmieniony `curl` albo lokalny `file://` z gotowcami. Model IQuest-Coder-V1 chwalił się 81,4% na SWE-bench, a w jednej czwartej uruchomień po prostu czytał `git log`. Traktuj te liczby jak spalanie z folderu producenta — patrz na merge rate i własną próbę na realnym repo.