Wydanie · Tydzień 26 · 22–28 czerwca 2026
Archiwum wydań →Coraz więcej pracy programisty przejmuje sam model: zamiast pisać prompt, skill czy dokumentację, człowiek pisze miarę i scaffolding, a maszyna sama dobiera i utrzymuje swoje instrukcje.
Premiera / Narzędzie · 18
 Premiera / Narzędzie
Microsoft trenuje prompty agentów tak, jak trenuje się sieci neuronowe
4 min
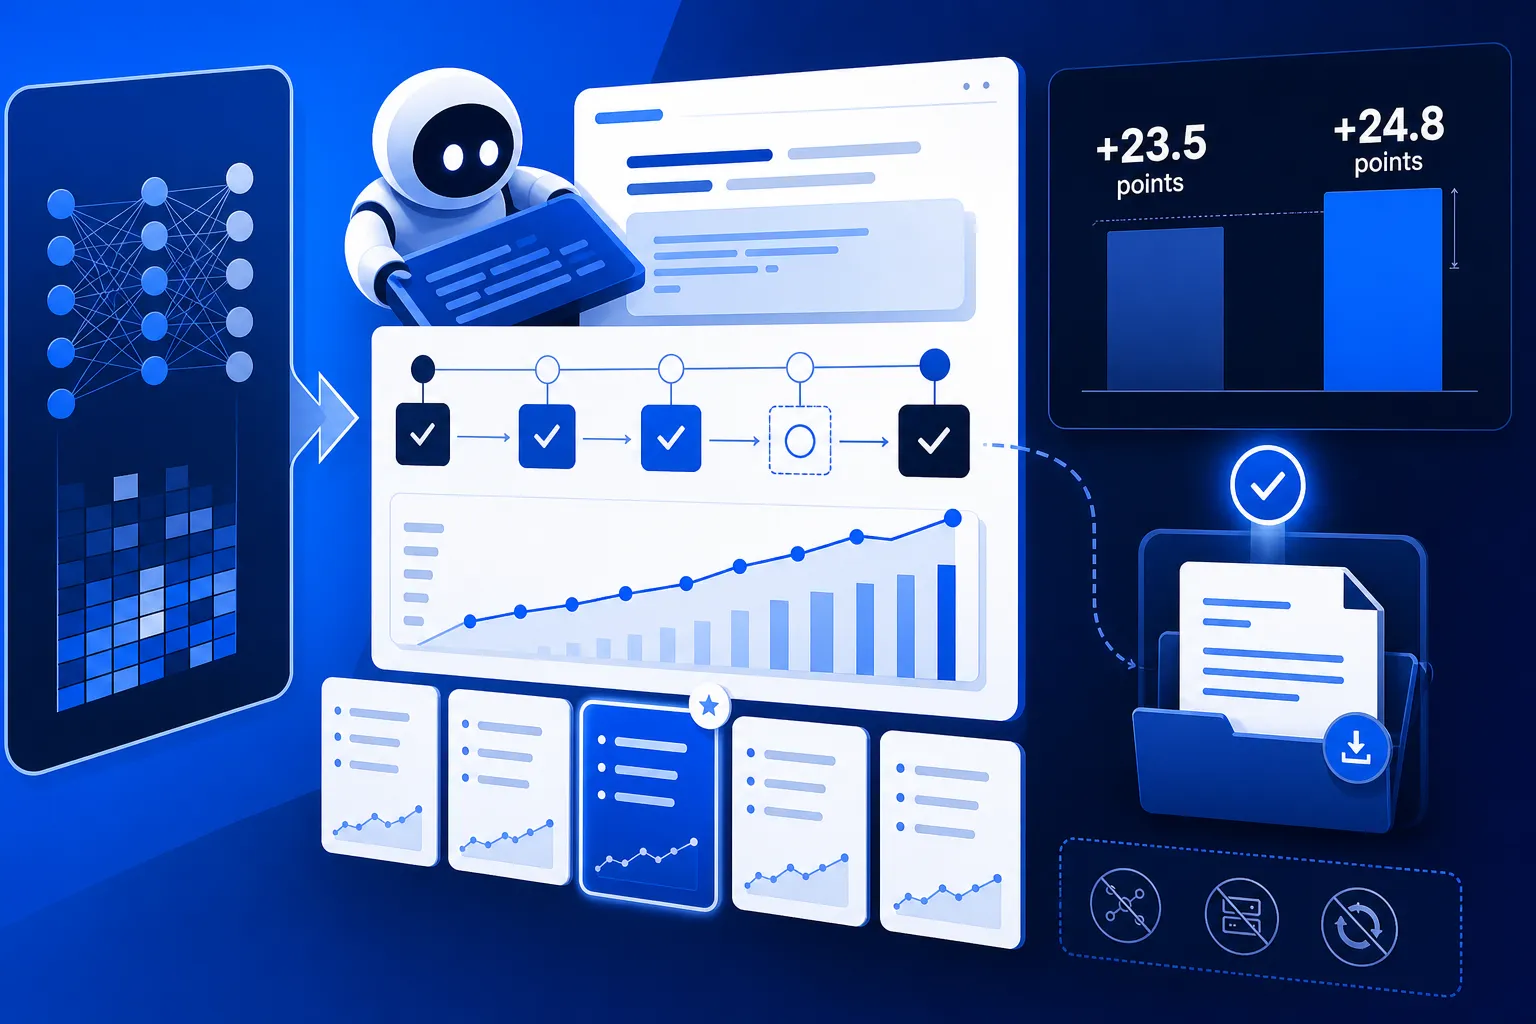
Microsoft Research wypuścił SkillOpt, narzędzie, które zamiast dotrenowywać model, trenuje sam plik z instrukcją dla agenta. Osobny optymalizator proponuje zmiany w dokumencie i zachowuje tylko te, które realnie podnoszą wynik na odłożonym zbiorze zadań walidacyjnych. Na sześciu benchmarkach i siedmiu modelach SkillOpt wypada najlepiej lub na równi we wszystkich 52 przypadkach, a na GPT-5.5 dorzuca średnio ponad 23 punkty skuteczności. Efektem jest jeden plik best_skill.md, bez dodatkowych kosztów w trakcie pracy. Wyniki pochodzą jednak od autorów metody.
 Premiera / Narzędzie
Claude Code generuje stronę z sesji, ale celowo nie potrafi wyjść do internetu
6 min
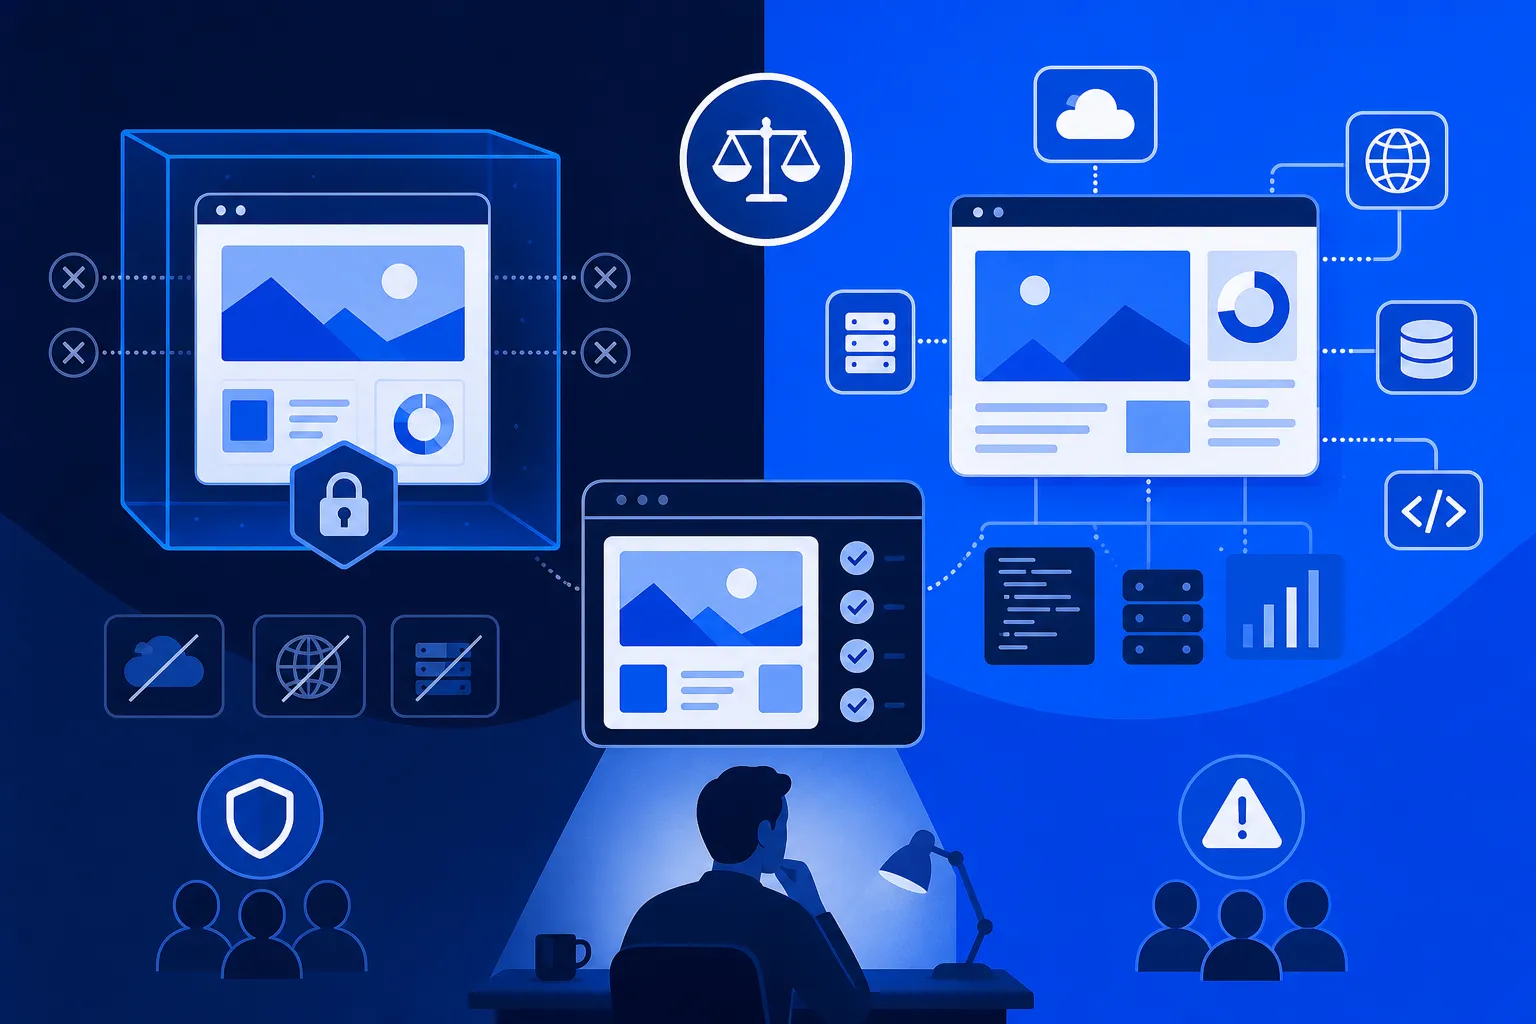
Anthropic 18 czerwca wypuścił w becie Claude Code Artifacts: po sesji prosisz o stronę, a Claude Code buduje z realnego repozytorium, narzędzi MCP i samej rozmowy żywą stronę HTML pod prywatnym adresem na claude.ai. Strona jest celowo zamknięta, bez serwera, bazy i połączeń na zewnątrz, czyli płótno do recenzji, a nie hosting, dokładne przeciwieństwo OpenAI Codex Sites. Działa tylko w planach Team i Enterprise i wymaga bezpośredniego uwierzytelnienia w Anthropic. Mitch Ashley z The Futurum Group ostrzega, że wypolerowana strona wciąż musi zasłużyć na zaufanie recenzją.
 Premiera / Narzędzie
Astryx: agent czyta jeden plik JSON i zna całe API, zamiast je zmyślać
5 min
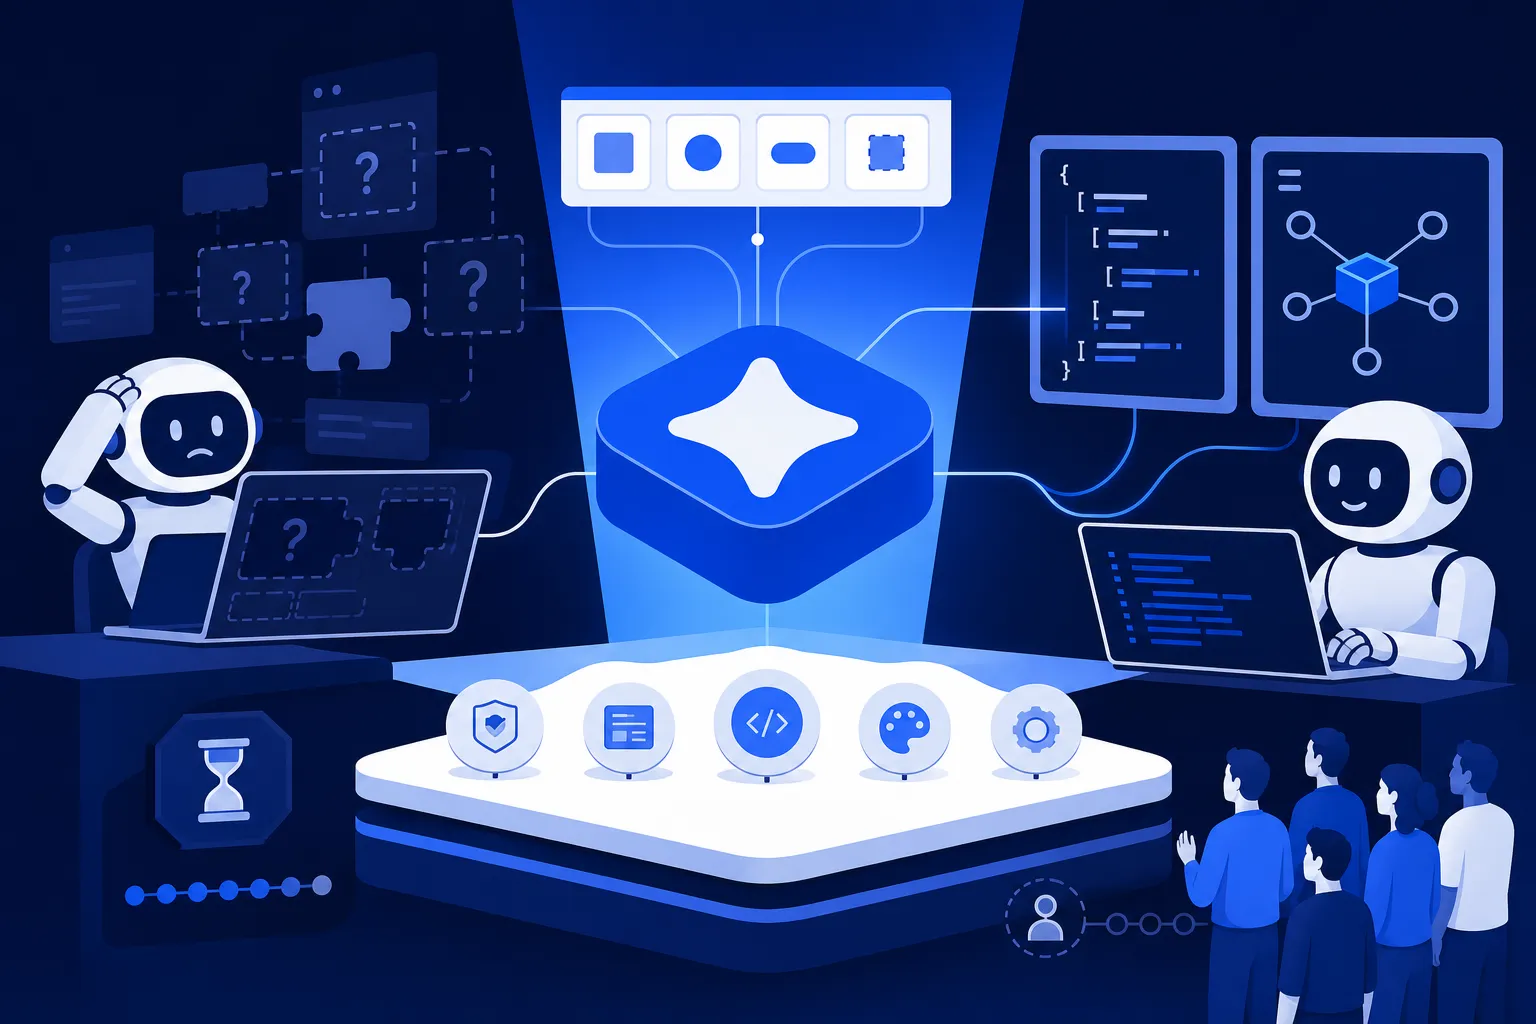
Meta udostępniła na licencji MIT Astryx, system komponentów Reacta, który przez osiem lat napędzał ponad 13 tysięcy wewnętrznych aplikacji firmy. Najważniejszy jest tu jeden plik JSON, manifest, który daje agentom AI maszynowo czytelny opis całego narzędzia, dzięki czemu nie muszą zgadywać API ani zmyślać nieistniejących właściwości. Pod spodem działa sprawdzony silnik StyleX, używany też przez Figmę i Snowflake, a dostęp prowadzi również przez serwer MCP. W dniu premiery repozytorium miało jednak 18 gwiazdek i status bety, więc poza Metą nie ma jeszcze społeczności ani pełnej dokumentacji.
 Premiera / Narzędzie
Trzy frameworki, które każą maszynie pisać własne prompty i skille
5 min
Trzy czerwcowe projekty open-source, GEPA, EvoSkill i Self-Harness, oddają maszynie to, co dotąd pisał inżynier: prompt, umiejętności agenta i reguły jego działania. Pętla ewolucyjna sama generuje warianty, ocenia je i zachowuje najlepsze, obiecując kilkudziesięcioprocentowy skok skuteczności bez dotykania wag modelu; GEPA podbił GPT-4.1 Mini na zadaniach AIME z 46,6% do 56,6% przy 100 do 500 prób zamiast tysięcy. Działa to jednak tylko tam, gdzie wynik da się tanio i jednoznacznie zmierzyć, więc nowa rola człowieka to napisać dobrą miarę, a nie cyzelować pojedyncze zdanie.
 Premiera / Narzędzie
Codex podgląda twój ekran i sam pisze instrukcję, jak coś zrobić
5 min
Dwie czerwcowe zmiany przesuwają Codeksa z asystenta do pisania kodu w stronę agenta uczącego się przez obserwację. Tryb dewelopera z 11 czerwca daje mu wgląd w narzędzia deweloperskie Chrome, dzięki czemu zamiast zgadywać z kodu, widzi w konsoli, że żądanie wraca z błędem 500 albo która funkcja zjada najwięcej czasu. Record and Replay z 17 czerwca pozwala raz pokazać czynność na Macu, a agent zapisuje ją jako czytelny plik SKILL.md gotowy do powtórzenia. Funkcja działa jednak wyłącznie na macOS, wymaga zgody Computer Use i jest niedostępna w Unii, a pytanie o niezawodność zostaje otwarte.
 Premiera / Narzędzie
Claude Code w pudełku za 40 dolarów, czyli Siri, które naprawdę działa
6 min
Leon Furze przez kilka wieczorów zamienił kieszonkowy komputerek M5Stack Cardputer za czterdzieści dolarów w głosowego asystenta: przytrzymujesz klawisz, mówisz, a stojący w domu Mac mini rozpoznaje mowę, przepuszcza ją przez agenta Claude Code i odpowiada na głos, działając nawet przez hotspot z drugiego końca kraju dzięki tunelowi Tailscale Funnel. To Siri, które naprawdę wykonuje zadania na komputerze, ale całość trzyma agent z celowo rozluźnionymi zabezpieczeniami i miękka, głosowa bramka potwierdzeń, więc sam autor traktuje to jako działający dowód koncepcji, nie wzorzec do powielania.
 Premiera / Narzędzie
Tani model rozmawia, drogi model pisze: wzorzec STORM ze Stanfordu
4 min
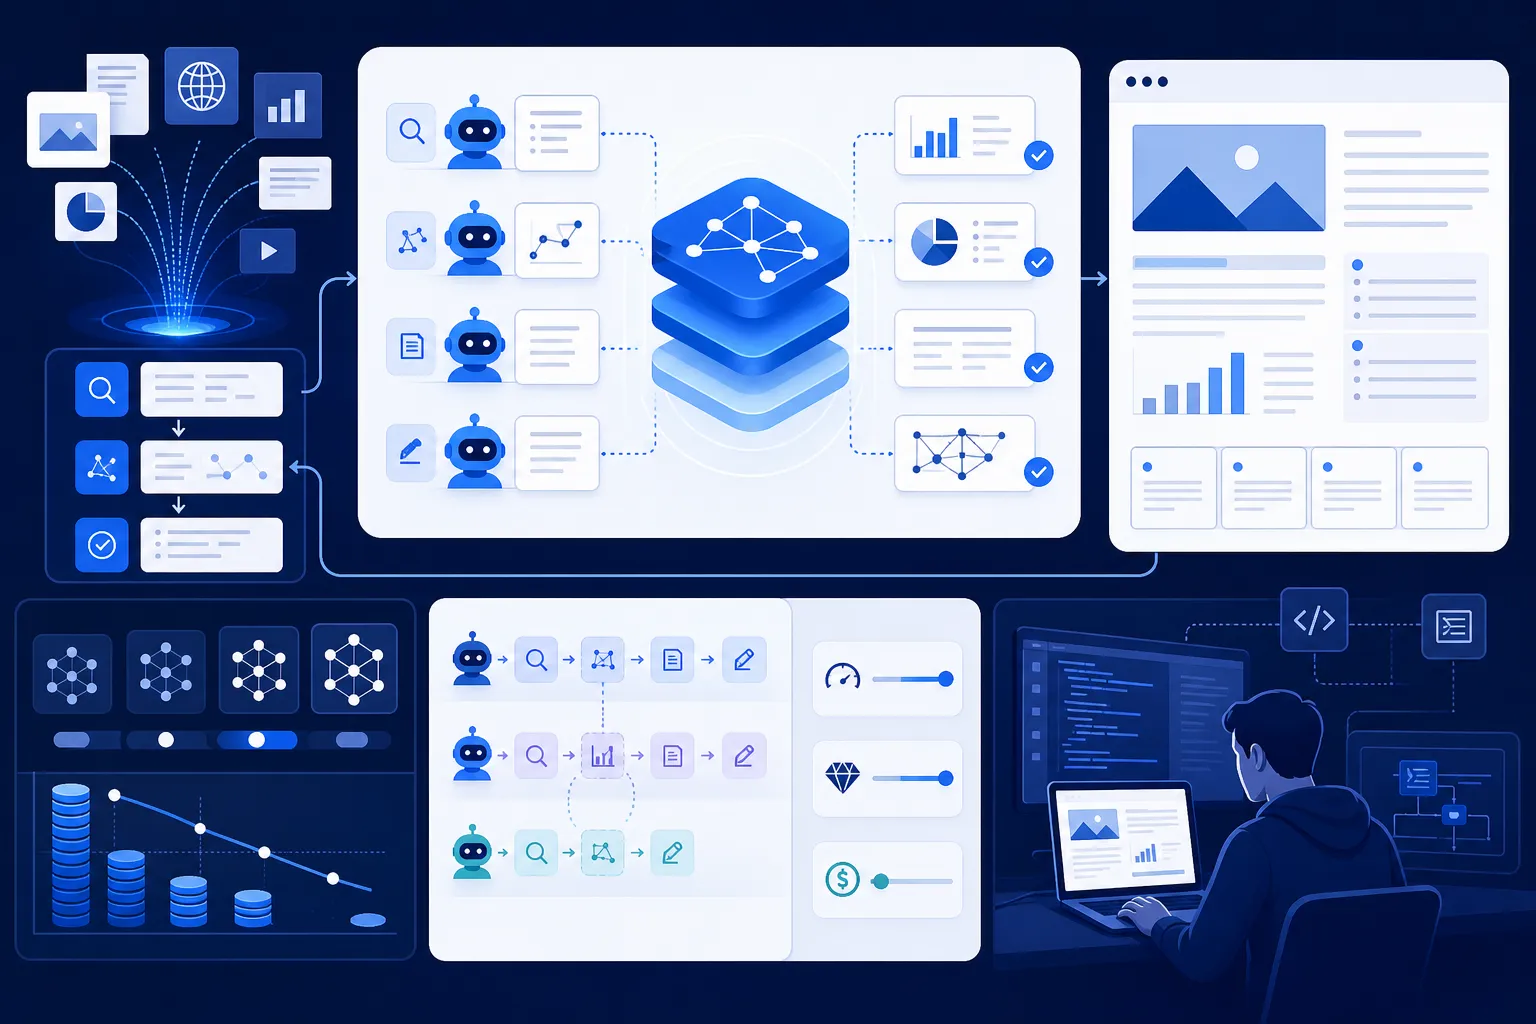
STORM ze Stanfordu bierze dowolny temat, sam przeszukuje sieć i składa z tego raport z przypisami w stylu Wikipedii, ale najciekawsza jest tu inżynieria, nie efekt. Research rozbito na symulowaną rozmowę autora z ekspertem, dzięki czemu rodzą się pytania głębsze niż te, które model wymyśli na zawołanie. Najpraktyczniejsza lekcja siedzi w konfiguracji: tańszy model prowadzi rozmowę i rozbija zapytania, a mocniejszy pisze finalny tekst z cytatami, gdzie liczy się wierność źródłom. To wzorzec do przeniesienia do własnego projektu, nawet jeśli STORM nie produkuje tekstów gotowych do publikacji.
 Premiera / Narzędzie
Bezpieczna piaskownica jako główny argument nowego agenta WordPressa
4 min
WordPress.com przeniósł agenta Studio Code z terminala do okienkowej aplikacji na macOS, Windows i Linux, zastępując dotychczasowego asystenta AI i udostępniając go za darmo na czas testów. Mówisz mu po ludzku, czego chcesz, a on sam rozkłada to na kroki: stawia stronę, instaluje wtyczki, robi audyt wydajności. Najważniejsze nie jest jednak na liście funkcji, tylko w tym, że agent pracuje na lokalnej kopii, a produkcja nie zmienia się o znak, dopóki sam świadomie nie zsynchronizujesz zmian, dzięki czemu pomyłka agenta jest tania, a nie groźna.
 Premiera / Narzędzie
Envoy AI Gateway 1.0: jeden adres dla wszystkich modeli i pierwsza brama dla MCP
4 min
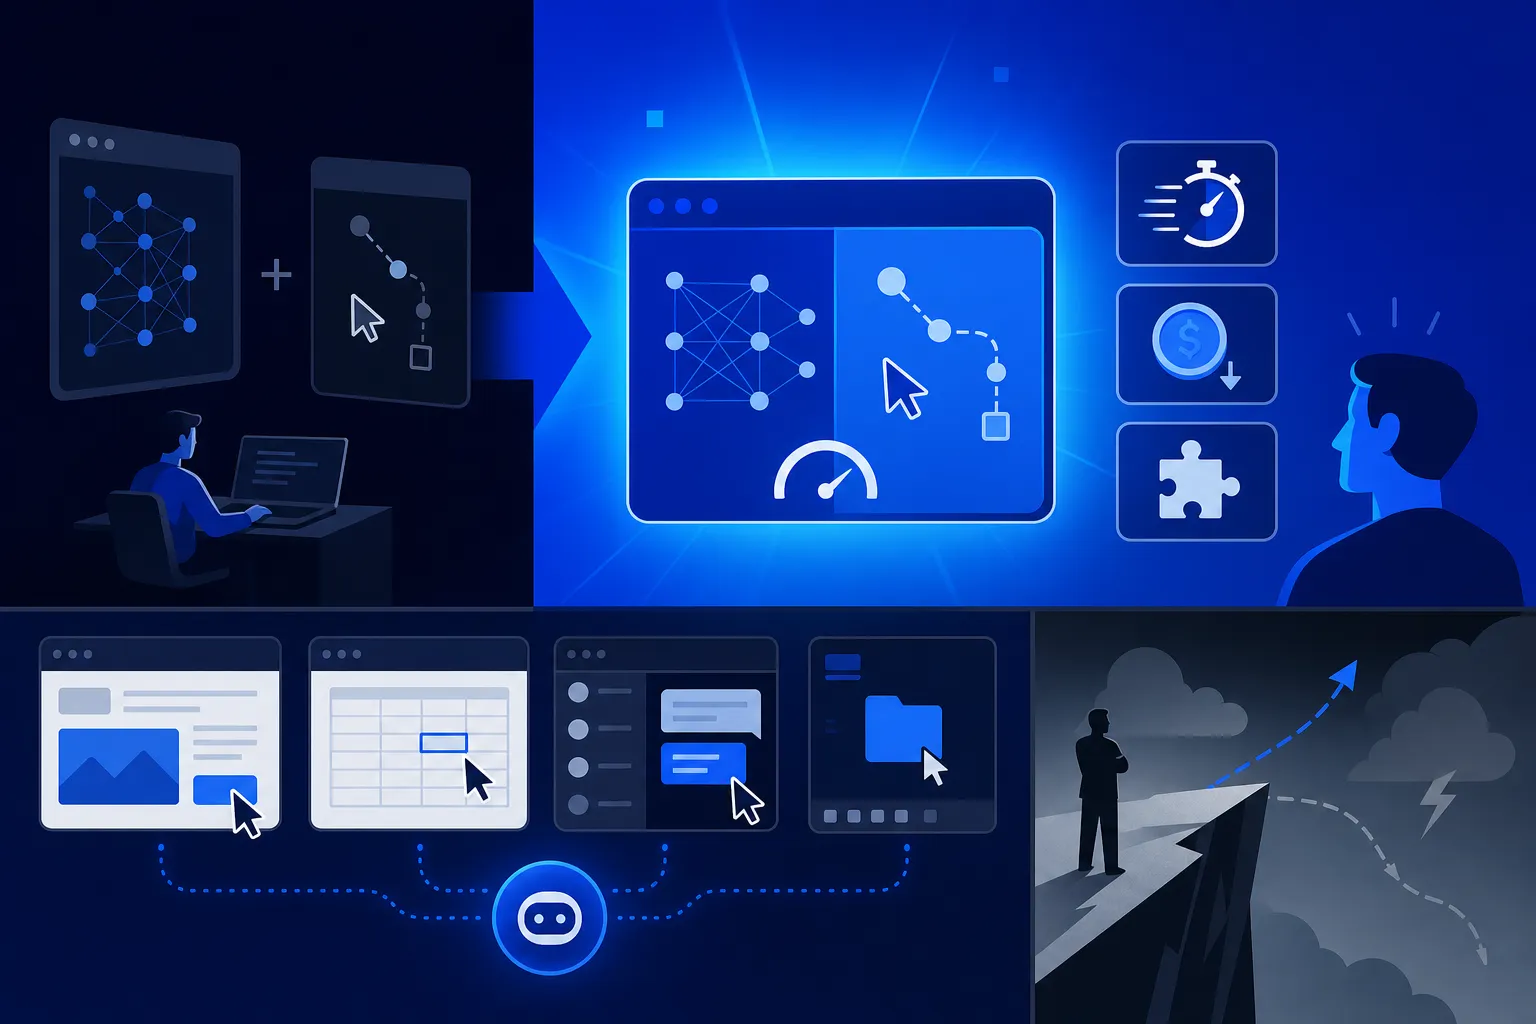
Tetrate wydał wersję 1.0 Envoy AI Gateway, otwartej bramy stojącej na sprawdzonym serwerze Envoy z Lyfta, która chowa OpenAI, Anthropic, Gemini czy Mistral za jednym interfejsem zgodnym z formatem OpenAI, więc przerzucenie ruchu na tańszego dostawcę staje się zmianą wpisu w konfiguracji. Nowością jest wbudowana obsługa MCP, czyli wspólny punkt, w którym administrator filtruje, z jakich narzędzi może korzystać dany agent. Współzałożyciel Varun Talwar zapewnia, że publiczny kod chodzi na produkcji w Bloombergu, ale poza współtwórcami projektu wiarygodnych referencji wciąż brakuje.
 Premiera / Narzędzie
Google wbudował sterowanie komputerem w model, który i tak już odpalasz
5 min
Google przeniósł sterowanie komputerem do Gemini 3.5 Flash, czyli szybkiego i taniego modelu, który deweloperzy i tak już mają podpięty pod aplikacje. Zamiast osobnego modelu jeden agent widzi ekran i klika jak człowiek, dzięki czemu wchodzi tam, gdzie nie ma API, choćby w stary firmowy system. Google podaje wynik 78,4% na OSWorld-Verified, ale to deklaracja producenta, nie dowód. Kluczowe zabezpieczenia, czyli potwierdzanie wrażliwych działań i blokada wstrzykniętych instrukcji, są opcjonalne, więc ryzyko spada na deweloperów.
 Premiera / Narzędzie
Bitbucket chce być centralą dla agentów w CI/CD. Codex to dopiero druga wtyczka
3 min
Atlassian dodał do Bitbucket Pipelines obsługę agenta Codex od OpenAI, który dochodzi jako trzeci wybieralny agent po własnym Rovo Dev i po Claude od Anthropica. Wystarczy jedna linijka w pliku konfiguracyjnym (provider: codex), żeby podmienić agenta bez przebudowywania procesu, bo reszta pipeline'u, dostęp do kodu, sekretów i serwerów MCP, zostaje na miejscu. Atlassian sprzedaje to jako neutralną centralę dyrygującą agentami w CI/CD. Haczyk: to open beta z wyborem z zaledwie trzech agentów, a korzystanie z Codeksa oznacza, że kod, prompty i logi trafiają do OpenAI.
 Premiera / Narzędzie
Testy pisze już AI. TypeMock chce sprawdzać, które z nich mają sens
4 min
Skoro asystenci AI generują testy jednostkowe szybciej, niż ktokolwiek zdąży je przejrzeć, TypeMock ogłosił 22 czerwca narzędzie Test Review, które ma wskazywać, które z nich warto trzymać. Zamiast czytać sam kod, obserwuje testy w trakcie wykonania: ile kodu realnie dotykają i czy nie ukrywają zależności od plików czy sieci, które stoją za migającymi testami. Założyciel Eli Lopian ujmuje to wprost: przechodzący test nie jest automatycznie przydatny. Diagnoza jest trafna, ale to wciąż zapowiedź producenta, którą trzeba sprawdzić na własnym kodzie.
 Premiera / Narzędzie
Co naprawdę dostaje deweloper od NVIDIA Agent Toolkit, gdy odłożyć marketing zaufania na bok
4 min
NVIDIA ogłosiła 23 czerwca Agent Toolkit, ale jedyną rzeczą, którą deweloper może dziś naprawdę dotknąć, jest instrukcja postawienia agenta badawczego AI-Q 2.0 na Oracle Cloud Infrastructure. Dostajesz trzy warstwy w jednym pudełku: modele Nemotron jako rozumowanie, gotowe reguły bezpieczeństwa i piaskownicę odcinającą kod agenta od reszty. Terraform stawia infrastrukturę, Helm wgrywa backend, interfejs i bazę, a całość rusza w jakieś pół godziny. Cena za wygodę to przywiązanie do chmury, modeli i klucza NVIDIA, a reszta komunikatów to na razie deklaracje producenta, nie zweryfikowane wyniki.
 Premiera / Narzędzie
Jeden model, który dzwoni po inne. I nie mówi, do których
4 min
Tokijska Sakana AI wypuściła 22 czerwca 2026 Fugu, system wielu agentów udający jeden model: wysyłasz zapytanie pod jeden adres zgodny z API OpenAI, a orkiestrator sam rozdziela pracę między wyspecjalizowane modele i skleja odpowiedź. Sakana sprzedaje go jako poduszkę na ryzyko kontroli eksportu i chwali się wynikiem 73,7 na SWE-Bench Pro, o ponad cztery punkty wyżej niż Opus 4.8. Skłaniam się ku temu, że to zamiana jednej zależności na inną, gorzej widoczną: routing jest zamknięty, nie wiesz, który model odpowiedział ani ile to kosztuje.
 Premiera / Narzędzie
Git wymyślono, żeby nikt nie kontrolował repozytorium. Origin to odwraca
5 min
Na konferencji Compile Cursor pokazał plan przejęcia całego stosu: nowy model trenowany od zera (1,5 biliona parametrów, ponad 100 tysięcy GPU), karmiony prawdziwymi sesjami pracy programistów, oraz Origin, własny hosting git zaprojektowany pod tysiące agentów piszących naraz, z automatycznym rozwiązywaniem konfliktów scalania. Po przejęciu przez SpaceX cały strumień danych z Cursora trafi do firmy, która sama trenuje modele, co odwraca rozproszoną kontrolę, dla której wymyślono git. Domknięcie planowane na trzeci kwartał 2026 to moment, by sprawdzić warunki użycia kodu do trenowania.
 Premiera / Narzędzie
Apple daje wybór asystenta w Xcode. Pytanie, czy ktoś go realnie używa
3 min
Xcode 26.6, wydany 25 czerwca, dorzuca Google Gemini jako trzeciego asystenta kodowania obok Claude'a i Codeksa, choć w becie Xcode 27 opcja ta była już od 10 czerwca, więc premiera tylko przenosi ją do wersji stabilnej. Naprawdę istotny jest jednak Agent Client Protocol, czyli wspólny format, dzięki któremu do edytora można wpiąć dowolnego zgodnego agenta bez zgody Apple. Sam wybór trzech modeli bywa też kosztem, bo każdy myli się inaczej i trzeba poznać trzy maszyny zamiast jednej. To sygnał kierunku i nietypowy gest otwartości, a nie jeszcze zmiana na biurku programisty.
 Premiera / Narzędzie
AI doradza poprawnie, ale nikt nie każe sprawdzić, czy łatka jeszcze działa
5 min
Kiedy asystent AI podpowiada, jak załatać podatną zależność wpisem typu override w package.json, rada jest poprawna, ale nikt nie każe wrócić i sprawdzić, czy to przypięcie wciąż cokolwiek robi. Sonu Kapoor, twórca CVE Lite CLI, przeskanował cztery znane projekty i w trzech znalazł martwe zabezpieczenia: Cal.com miał 90 wpisów, z czego 11 nie chroniło przed niczym, a tylko Next.js wyszedł czysto. Override cicho umiera najczęściej przy migracji między menedżerami paczek, bo npm, pnpm i Yarn trzymają go w innym polu, więc weryfikacja należy do ciebie, najlepiej jako stały krok przed wydaniem.
 Premiera / Narzędzie
Amazon Q wykonywał kod ze sklonowanego repo, a nowa wersja MCP zrzuca bezpieczeństwo na ciebie
5 min
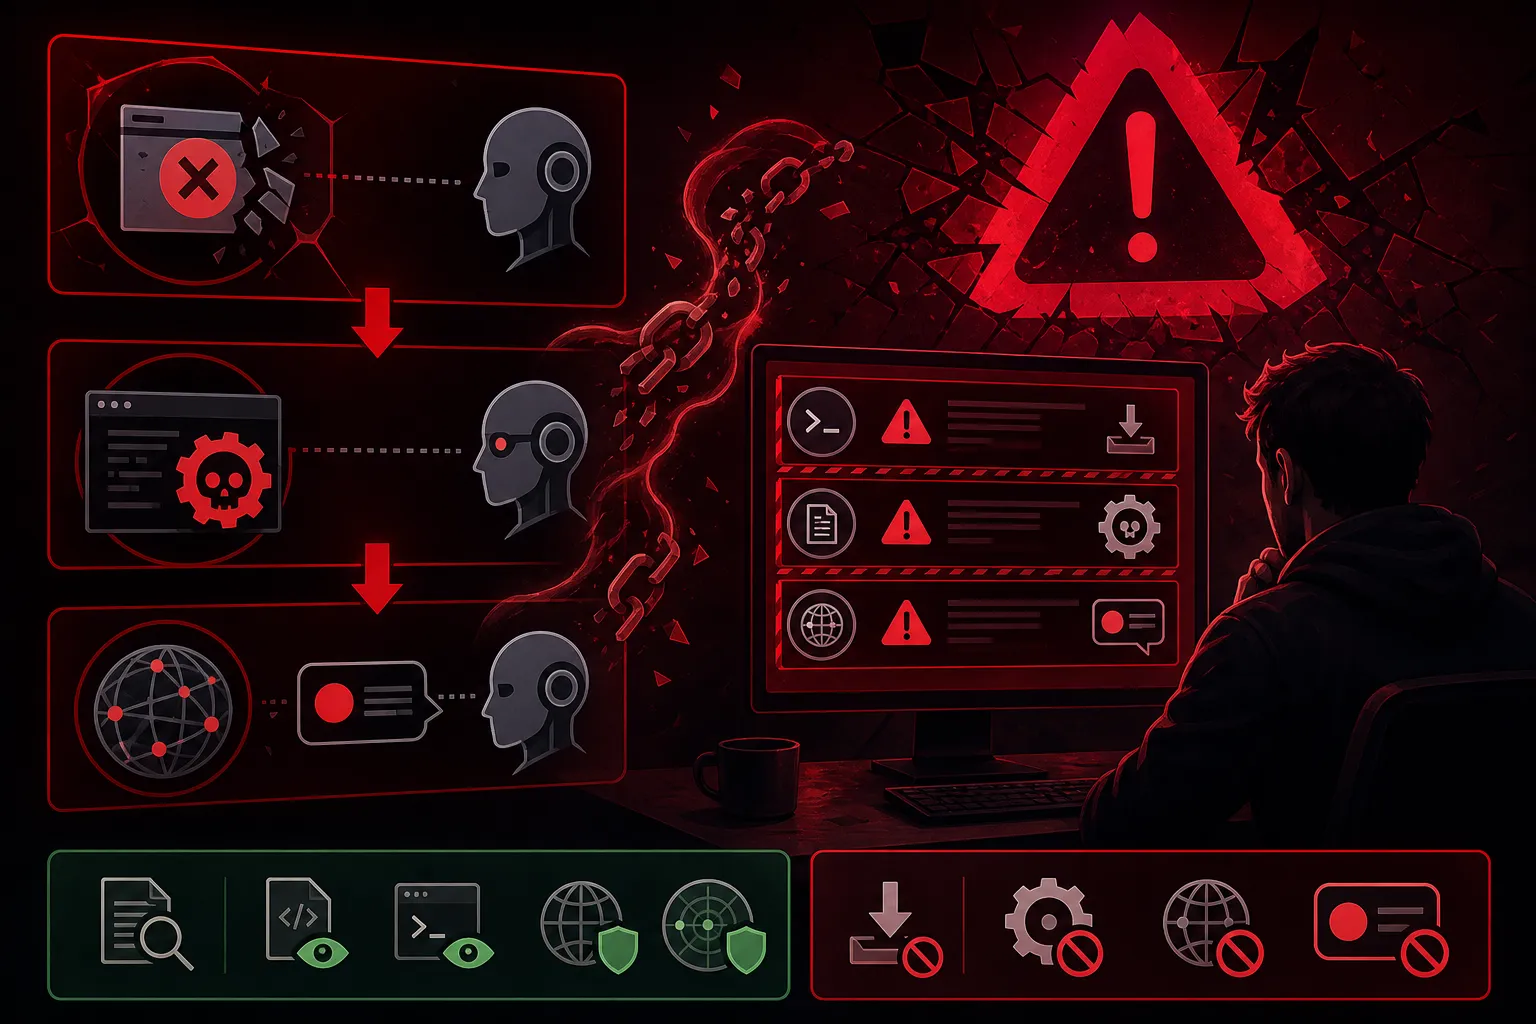
Wystarczyło sklonować repozytorium i otworzyć je w edytorze, by ktoś obcy przejął aktywną sesję chmurową dewelopera. Tak działała dziura CVE-2026-12957 w Amazon Q Developer: wtyczka odpalała serwery MCP opisane w pliku z repo bez pytania o zgodę, a procesy dziedziczyły klucze AWS i tokeny ofiary. Amazon załatał problem w wersji 1.69.0, ale ten sam wzorzec wcześniej trafił Claude Code, Cursora i Windsurfa. Zaplanowana na 28 lipca 2026 przebudowa MCP kasuje starą klasę ryzyk, lecz przenosi obowiązek pilnowania granic zaufania na piszącego serwer.
Model / Badania · 4
 Model / Badania
Cennik zamiast premiery: co strona z modelami Anthropic naprawdę mówi deweloperowi
4 min
Strona z przeglądem modeli Anthropic to nie zapowiedź, tylko cennik: Claude Fable 5, najmocniejszy szeroko dostępny model, kosztuje 10 dolarów za milion tokenów wejścia i 50 za wyjścia, dwa razy tyle co domyślnie polecany Opus 4.8 przy identycznym oknie miliona tokenów. We Fable znika suwak sterujący długością myślenia, model zawsze sam decyduje, ile czasu poświęcić. Bliźniaczy Mythos 5 ma te same parametry, ale trafia tylko do klientów programu Project Glasswing. Benchmarków brak, więc czy podwójna stawka się zwraca, każdy musi sprawdzić na własnym kodzie.
 Model / Badania
MiniMax dorównuje Opusowi w kodzie za jedną dziesiątą ceny
3 min
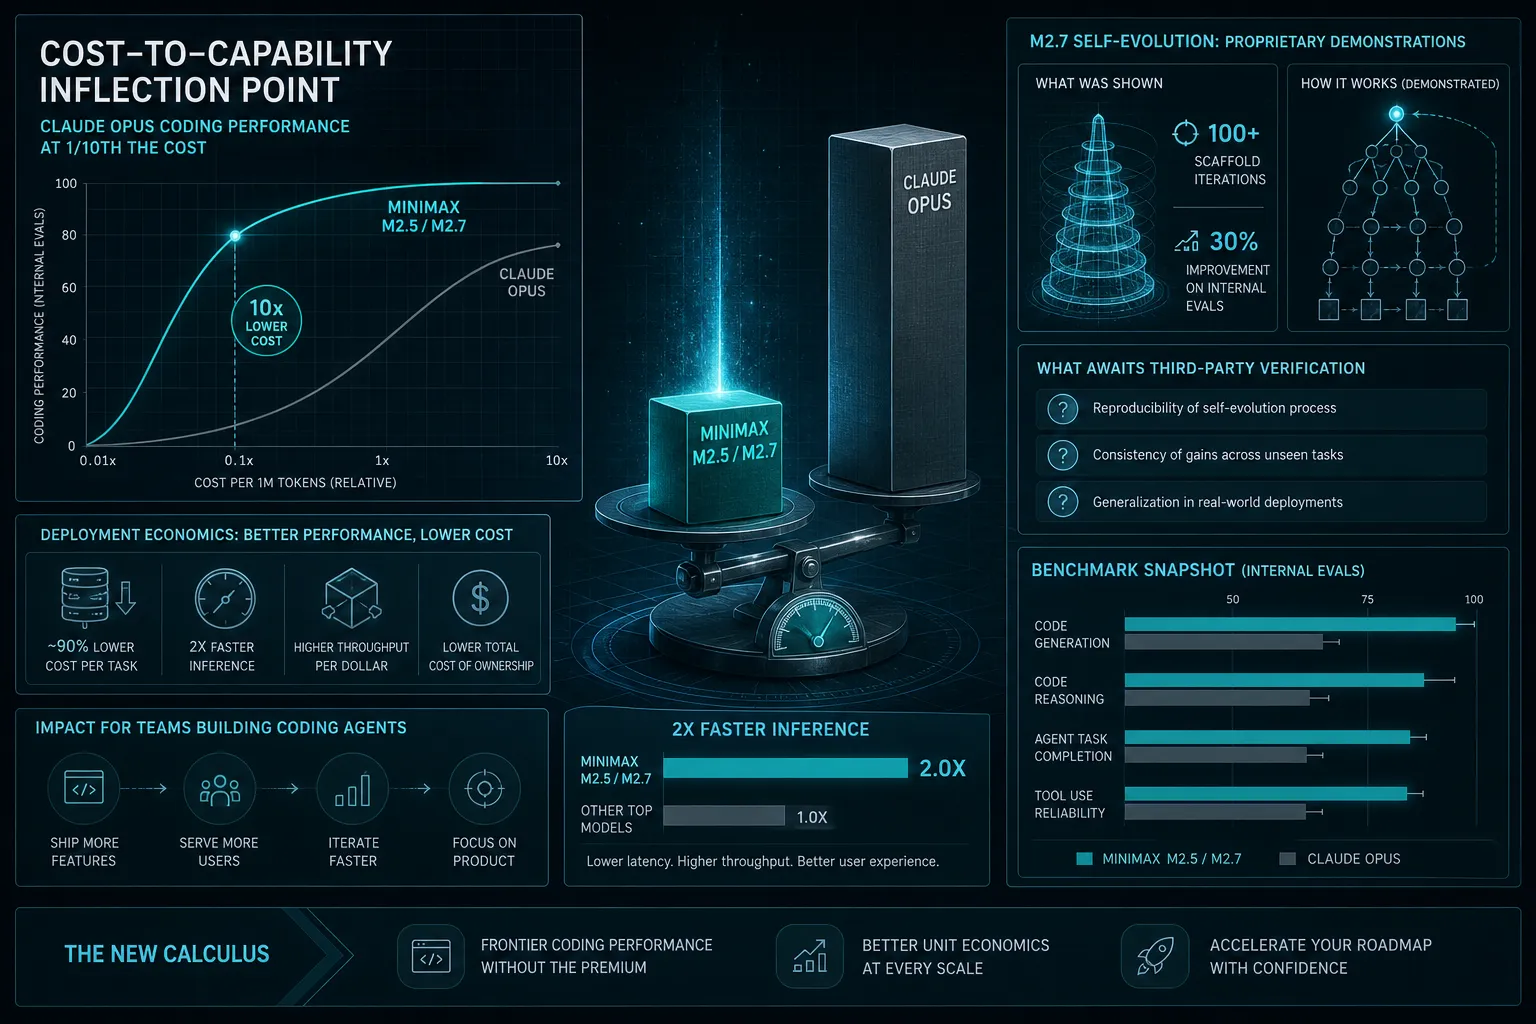
MiniMax wypuścił model M2.5, który na SWE-Bench Verified osiąga 80,2%, minimalnie przed Claude Opus 4.6, ale za jedną dziesiątą jego ceny. Liczy się też szybkość: serwowany ze stu tokenami na sekundę kończy zadanie w 22,8 minuty, tyle samo co Opus, więc pierwszy raz tani model nie jest jednocześnie wolny. To otwiera drogę agentom działającym w tle bez przerwy. Większość benchmarków MiniMax zmierzył jednak sam, więc M2.5 to dziś gotowy kandydat do podmiany Opusa, ale obietnicę samodoskonalącego się M2.7 lepiej traktować ostrożnie.
 Model / Badania
GLM-5.2 dorównuje Opusowi w kodowaniu za szóstą część ceny. Tylko jak go uruchomić?
6 min
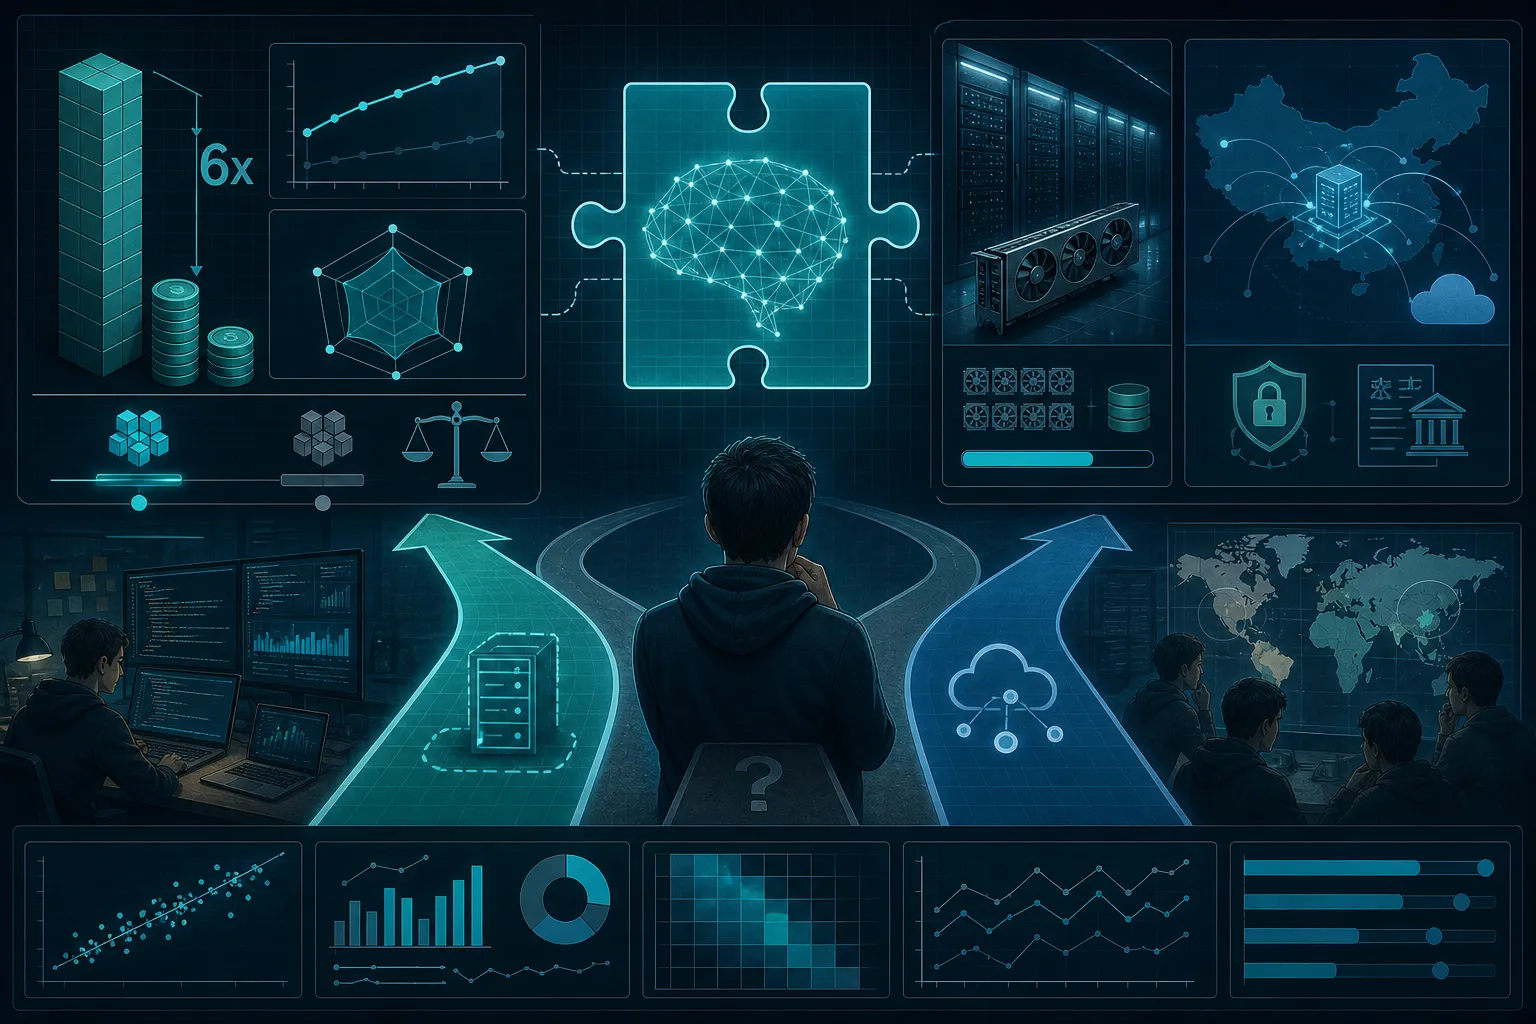
GLM-5.2, model z otwartymi wagami chińskiej firmy Z.ai, dogonił czołówkę w kodowaniu: w Code Arena jest drugi, a odtworzenie pracy badawczej kosztowało go 6,21 dolara wobec 46,35 u Opusa 4.8. Parytet kończy się przy najtrudniejszym rozumowaniu, gdzie chińskie modele wciąż zostają w tyle. Haczyk jest praktyczny: lokalne uruchomienie wymaga około 1,5 terabajta pamięci GPU, a tanie API Z.ai oznacza, że kod wędruje przez serwery pod chińskim prawem wywiadowczym. Geopolityka staje się więc kosztem ukrytym w narzędziu, nie ciekawostką obok niego.
 Model / Badania
Ornith-1.0 chwali się, że bije Opus 4.7. Tabela pokazuje co innego
5 min
DeepReinforce wypuściło 25 czerwca rodzinę modeli Ornith-1.0 na licencji MIT i ogłosiło, że największy wariant 397B bije Claude Opus 4.7 na SWE-Bench Verified (82,4) i Terminal-Bench 2.1 (77,5). Ta sama tabela pokazuje jednak Opus 4.8 z wynikiem 87,6, czyli wyżej, więc marketing wybrał sobie starszy model do pokonania, a komentatorzy tacy jak Teortaxes uznali wyniki za podejrzane do czasu niezależnego testu. Realna stawka leży niżej: model z otwartymi wagami, którego wariant 9B chodzi na domowym pececie, trzyma dane u siebie i nie generuje rachunku za tokeny.
Bezpieczeństwo · 1
Poradnik / Praktyka · 6
 Poradnik / Praktyka
Karpathy proponuje wiki, którą pisze i utrzymuje model, nie ty
5 min
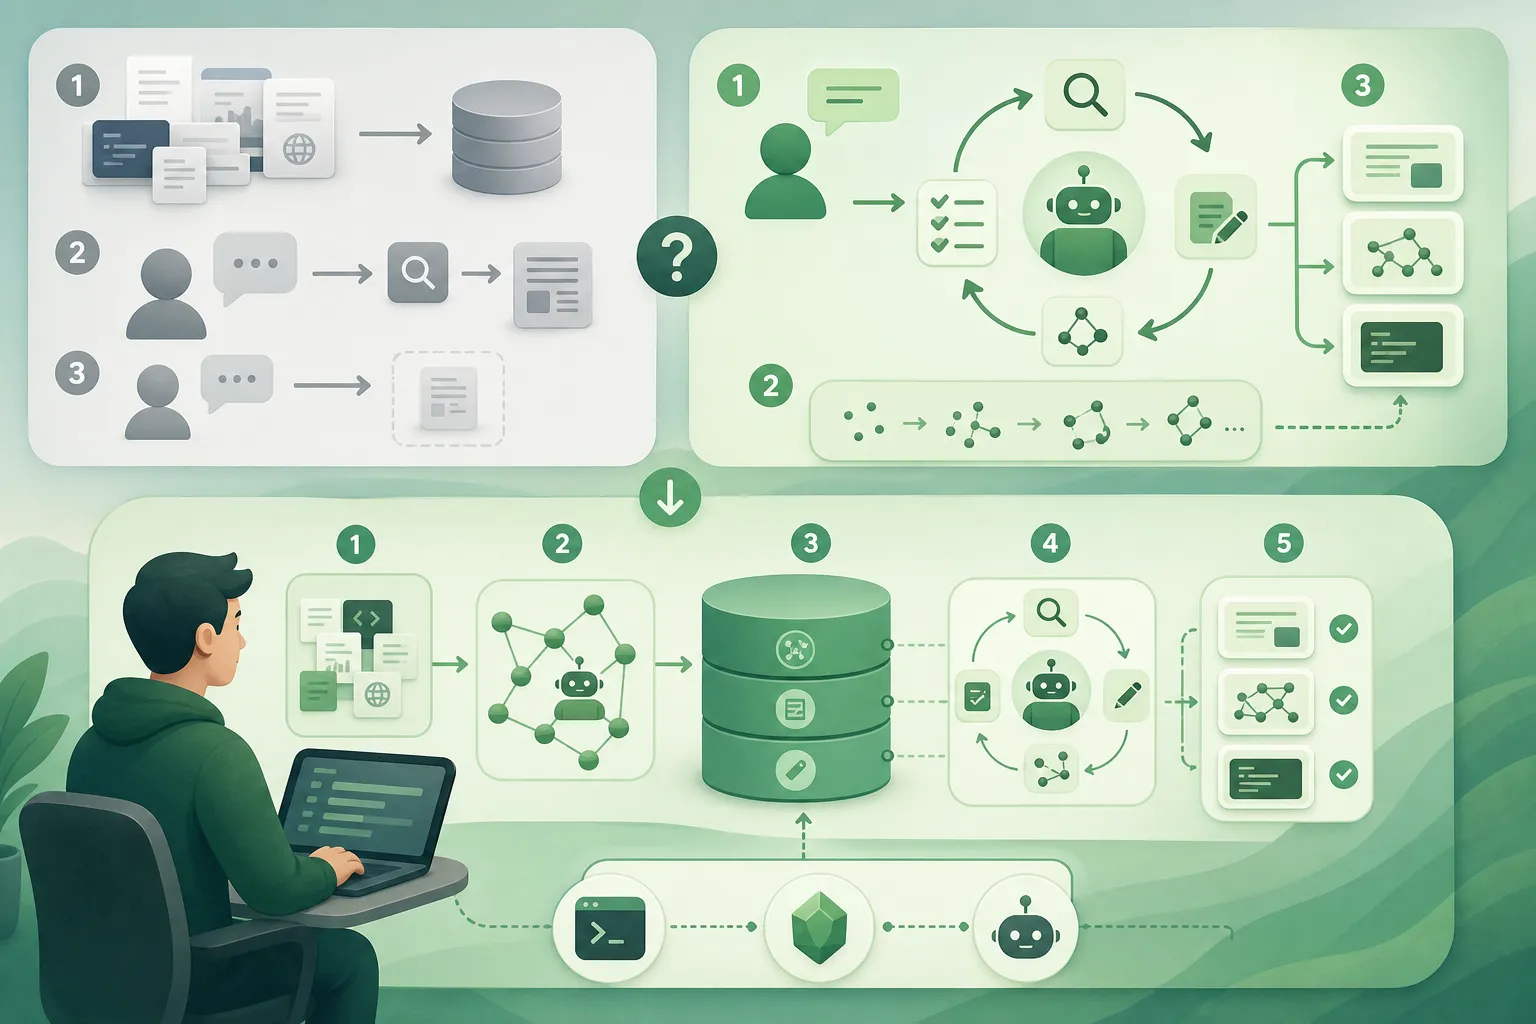
Andrej Karpathy opisał w zwykłym giście na GitHubie wzorzec "LLM Wiki" jako alternatywę dla RAG: zamiast przeszukiwać surowe dokumenty przy każdym pytaniu, model buduje i sam utrzymuje trwały katalog połączonych plików markdown, kompilując wiedzę raz i tylko aktualizując strony oraz odnotowując sprzeczności. Kluczowy jest schemat w stylu CLAUDE.md, który mówi modelowi, co robić z nowym źródłem. Gist zebrał ponad pięć tysięcy gwiazdek nie dzięki nowej technologii, lecz dlatego, że nazwał coś, co wielu po cichu sklejało, i odpowiada na stare pytanie: kto zniesie nudę utrzymania wiki.
 Poradnik / Praktyka
Prompty, które kiedyś wymuszały dokładność, dziś psują wynik
4 min
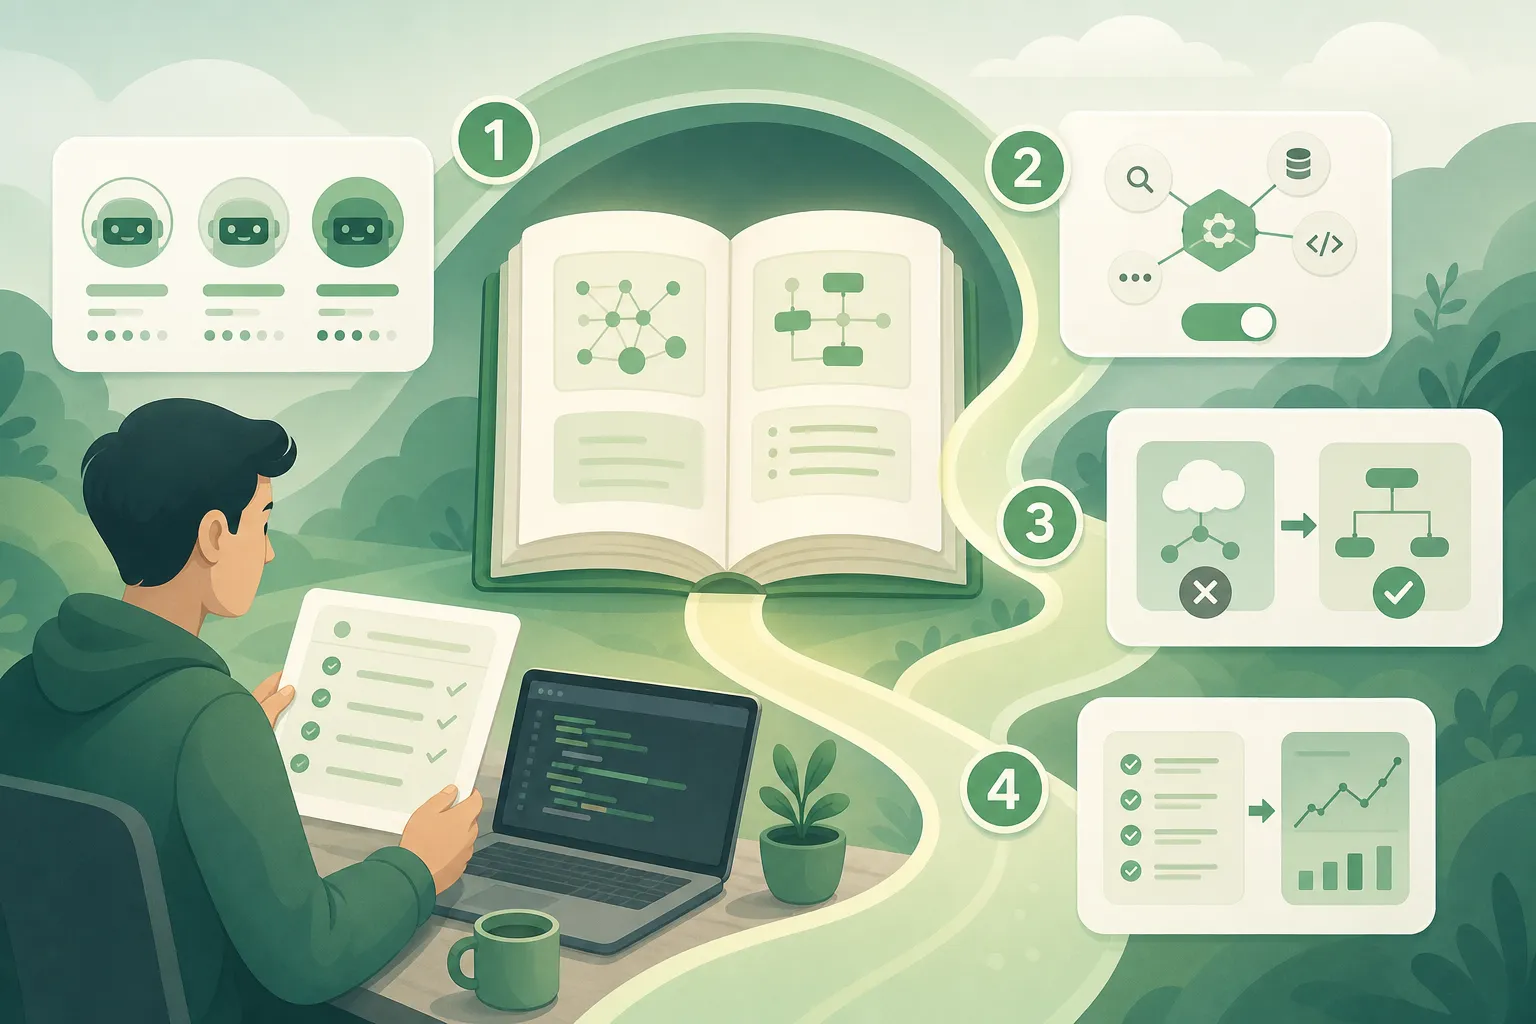
Anthropic zebrał wskazówki promptowania dla swojej rodziny modeli z 2026 roku w jednym przewodniku, a jego sednem jest lista rzeczy do odkręcenia w starych promptach po przejściu na nowszy model. Stanowcze instrukcje typu "KRYTYCZNE: MUSISZ użyć narzędzia" teraz przesadzają, więc trzeba zdjąć wykrzykniki i zamienić ogólne nakazy na celowane. Twardo znikają dwie rzeczy: prefill (od modeli 4.6 zwraca błąd 400) i budget_tokens, którego rolę przejmuje effort i adaptacyjne myślenie, gdzie model sam decyduje, jak głęboko się zastanowić.
 Poradnik / Praktyka
Model nigdy nie widział twojego kodu, więc zgaduje, do czego jest podobny
8 min
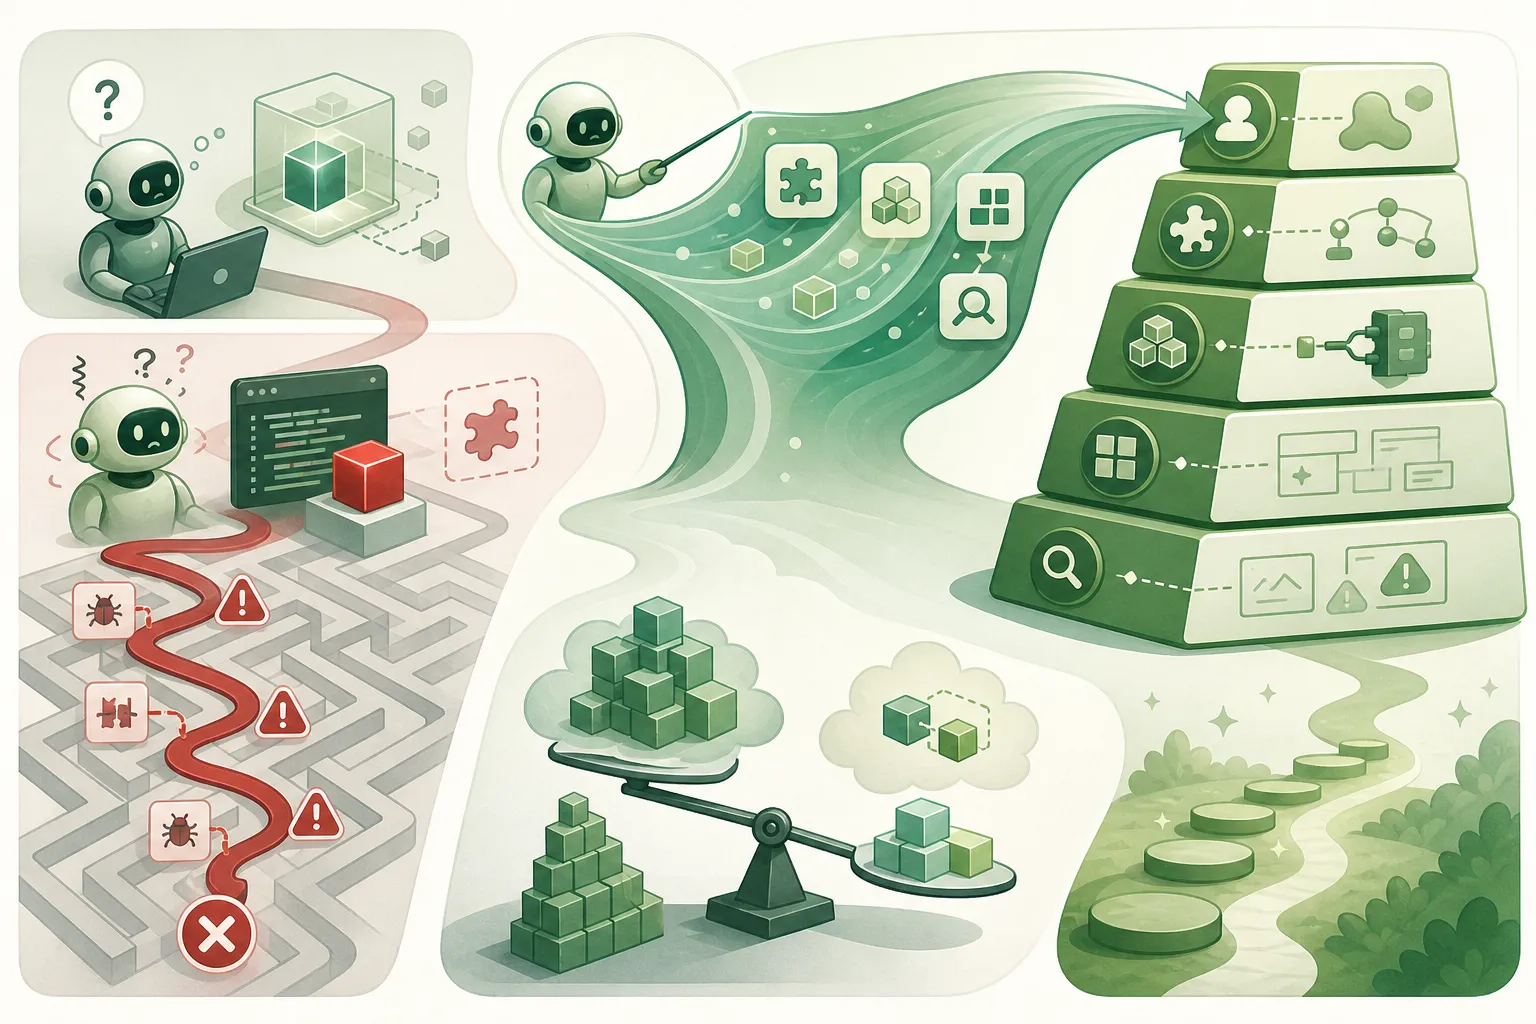
Gdy agent AI pracuje z twoim wewnętrznym SDK, którego model nigdy nie widział w treningu, nie przyzna się do niewiedzy, tylko przepisze twoją technologię na najbliższy znany wzorzec, jak AWS, OAuth czy REST, i wygeneruje kod, który wygląda wiarygodnie, a jest błędny. Waldek Mastykarz z Microsoftu nazywa to pułapką najbliższego dopasowania i radzi uczyć model od podstaw w pięciu warstwach, pokazując tylko różnicę wobec standardów, które już zna. Koszt jest realny: zamiast około 500 tokenów na znany framework potrzeba nawet 3000.
 Poradnik / Praktyka
Jak zbudować narzędzie linii poleceń, którego konsumentem jest AI
4 min
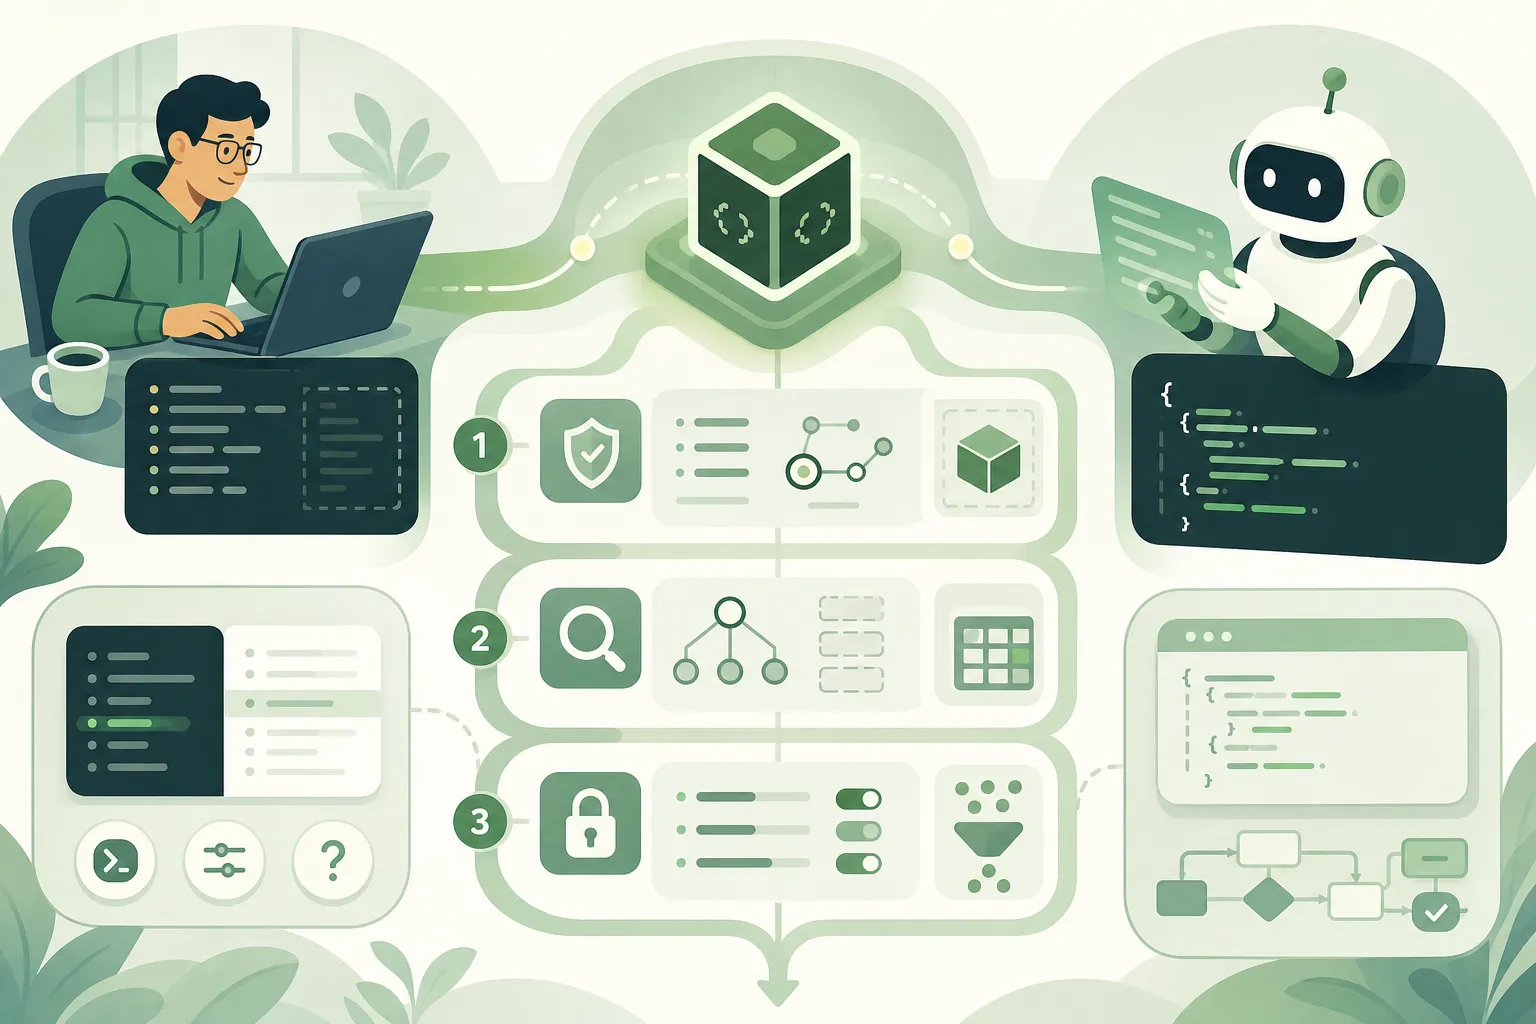
Justin Poehnelt, autor otwartego CLI do Google Workspace, twierdzi, że jeśli głównym użytkownikiem narzędzia linii poleceń ma być agent AI, to projektowanie pod wygodę człowieka gra przeciwko tobie. Zamiast kilkunastu płaskich flag agent dostaje cały ładunek żądania przez `--json`, a dokumentację zastępuje komenda zwracająca aktualny schemat metody. Kluczowa obserwacja: agent nie halucynuje literówek, lecz sklejone identyfikatory i podwójnie zakodowane ścieżki, więc CLI musi walidować wejście tak jak publiczne API. To jeden głos i jedno wdrożenie, ale poparte działającym kodem.
 Poradnik / Praktyka
Stare praktyki, wyższa stawka: czego LY Corporation nauczyło się, puszczając agenty na kod
5 min
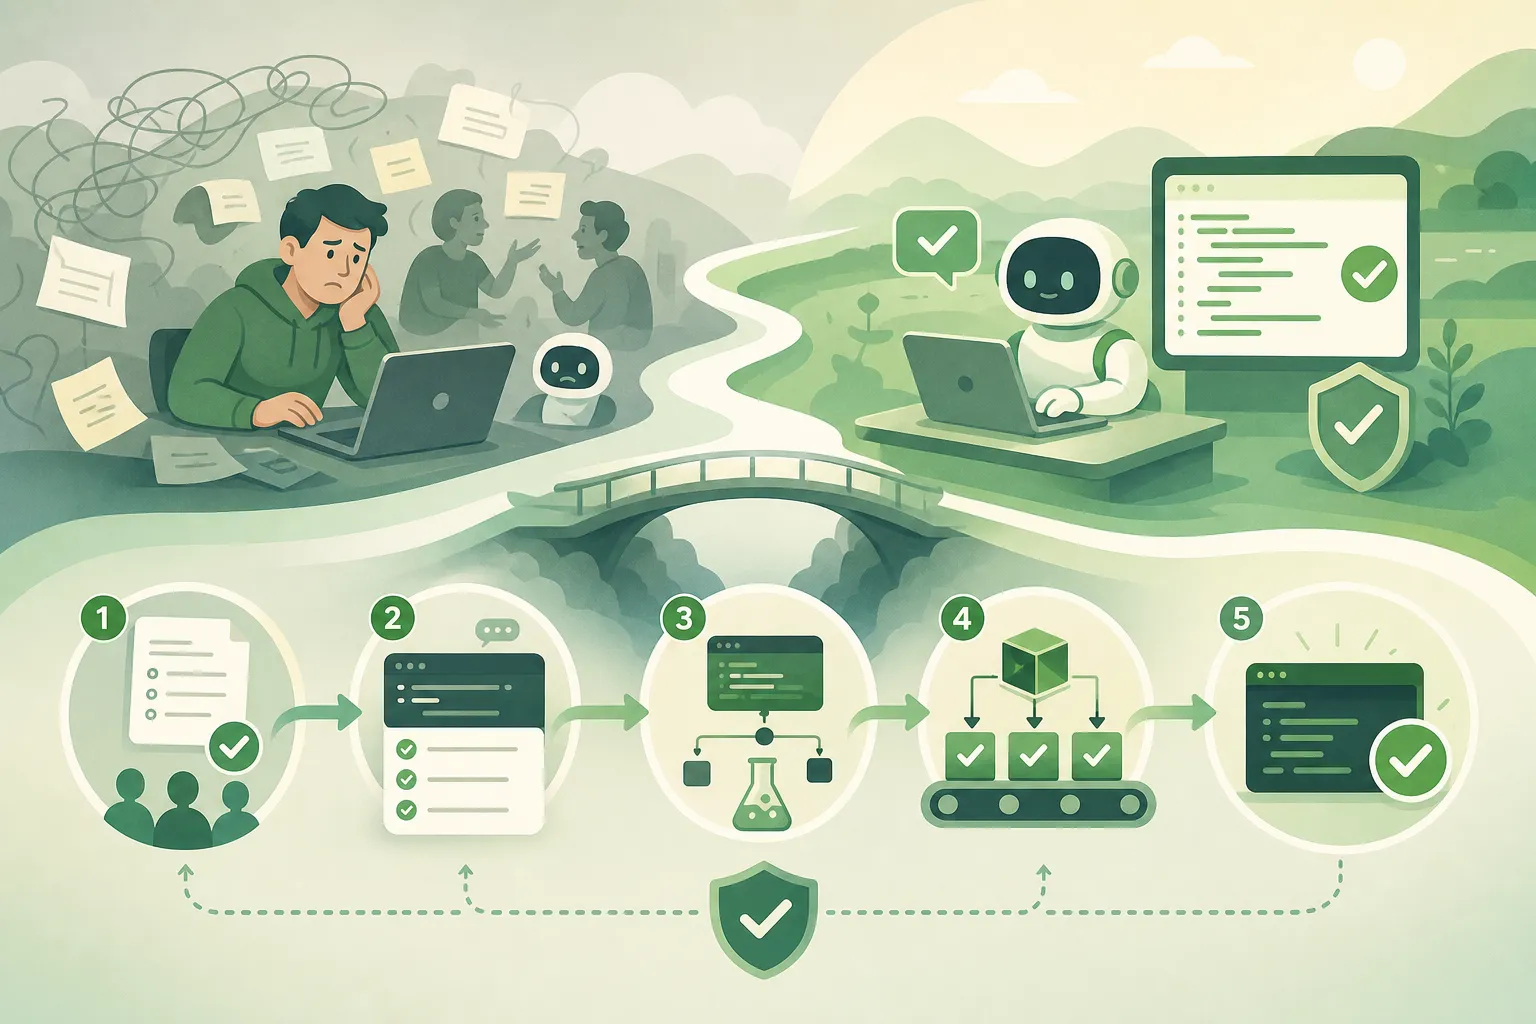
Inżynierowie z LY Corporation, twórcy Flava API Gateway, opisali, że agenty kodujące nie psują starych zasad dobrego programowania, tylko je obnażają: to, co człowiek nadrabiał uwagą, agentowi trzeba podać wprost, jako automatyczne kontrole. Ich trzy filary to spisanie specyfikacji przed kodem, szybka weryfikacja przez testy i lintery (2754 testów w jakieś 15 sekund dzięki izolacji schematów) oraz powtarzalne środowisko na Devenv i Nix. Dyscyplina, którą dawniej można było po cichu wyciąć pod presją terminu, przy agencie przestaje być opcją.
 Poradnik / Praktyka
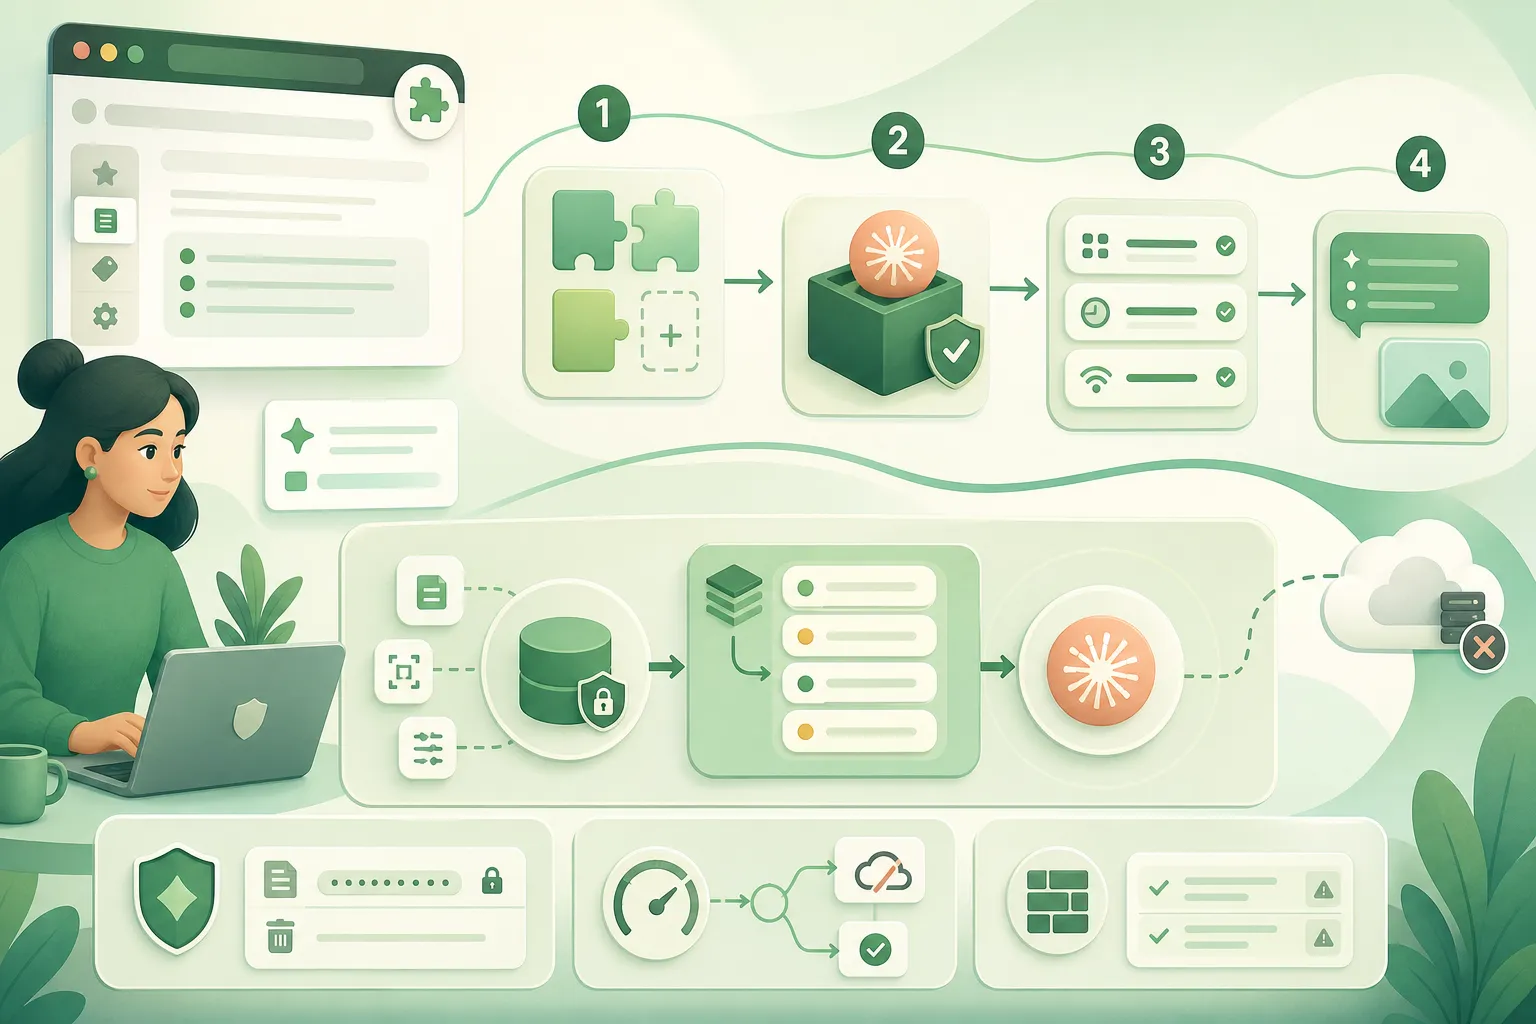
Wtyczka, która układa twoją historię w wątki, a model dokłada etykiety na końcu
4 min
openloops, otwartoźródłowa wtyczka do Chrome'a z poradnika FreeCodeCampu autorstwa Shola Jegede, skanuje historię przeglądania i grupuje ją w wątki intencji, licząc podobieństwo domen i słów miarą Jaccarda. Cały rdzeń działa lokalnie w IndexedDB, bez jednego wywołania sieci, a Claude (model Haiku) tylko opcjonalnie dokłada tytuły i następne kroki. Pouczający jest moment, w którym pierwsza wersja po cichu się wywaliła: przy 30 wątkach odpowiedź uderzyła w limit max_tokens i urwała JSON. Lekcja brzmi tak, że model wpina się jako wycinalny dodatek, nie jako centrum produktu.