Wydanie · Tydzień 25 · 15–21 czerwca 2026
Archiwum wydań →Praca przy kodzie przesuwa się z pisania na kierowanie i sprawdzanie agentów: wąskim gardłem nie jest już autorstwo, lecz nadzór, zaufanie i wiedza, kiedy kazać agentowi przestać.
Premiera / Narzędzie · 18
 Premiera / Narzędzie
AgentDeck: jeden terminal do całej floty agentów i osobny agent, który ich pilnuje
4 min
AgentDeck to otwartoźródłowe narzędzie w Go, które zbiera całą flotę agentów kodujących w jednym terminalu: każda sesja dostaje kolorową kropkę stanu, fork dziedziczący rozmowę i własny worktree gita, a klawisz "$" pokazuje koszty czternastu modeli. Najciekawszy jest jednak dyrygent, osobny agent stale pilnujący reszty, który sam odpowiada na rutynowe pytania, a ważniejsze przerzuca na Telegram albo Slack. To kuszący wzorzec, ale projekt jednej osoby, a wiedza pochodzi z README, nie z produkcji, więc kluczowe pytanie, co dzieje się, gdy dyrygent się myli, pozostaje bez odpowiedzi.
 Premiera / Narzędzie
Datalab otwiera Lift: model 9B, który wyciąga JSON z PDF-ów lokalnie
4 min
Datalab udostępnił na open source Lift, wizyjny model o dziewięciu miliardach parametrów, który z PDF-a i podanego schematu zwraca gotowy obiekt JSON, działając lokalnie na jednej karcie graficznej. Dzięki dekodowaniu ograniczonemu schematem wynik nie potrafi wyłamać się z formatu, a na zestawie 225 dokumentów model trafia w 90,2 procent pól w 9,5 sekundy, bijąc Azure Content Understanding (83,4 procent, 73,7 sekundy). Haczyk to inna liczba: bezbłędnie domyka tylko 20,9 procent całych dokumentów, więc świetnie nadaje się do pracy z człowiekiem w pętli, ale nie do pełnej automatyzacji.
 Premiera / Narzędzie
Cursor wpada w ręce SpaceX. Pytanie nie brzmi za ile, tylko jaki model będzie domyślny
3 min
SpaceX kupuje Anysphere, twórcę edytora Cursor, za 60 miliardów dolarów w akcjach, cztery dni po debiucie giełdowym za 75 miliardów. Dla piszących kod liczy się jednak nie kwota, tylko to, czy Cursor zachowa neutralność wobec dostawcy modelu, skoro SpaceX wchłonął już xAI i zapowiada własny model oraz agenta Grok Build. Pokusa, by ustawić Groka domyślnie, jest oczywista, bo dział tracił w 2025 roku 6,35 miliarda dolarów. Po stronie plusów stoi superkomputer Colossus, który może przyspieszyć trenowanie modeli pod Cursora. Domknięcie planowane na trzeci kwartał 2026 roku.
 Premiera / Narzędzie
Wąskie gardło przesunęło się z pisania kodu na jego wypuszczanie
5 min
Gdy agent generuje kod szybciej, niż recenzenci zdążą go sprawdzić, wąskie gardło przenosi się z pisania na recenzję, testy i samo wydanie. AWS odpowiada podglądem nowych funkcji w DevOps Agent: przegląd gotowości prześwietla każdą zmianę przed scaleniem, uruchamia kod w izolowanym środowisku i wydaje jedną z trzech ocen, od zablokowania po bezpieczne wydanie. Druga funkcja sama układa testy skrojone pod konkretną zmianę, a integracja z edytorem Kiro przez protokół MCP pozwala przejść od alarmu do gotowej poprawki bez wychodzenia z edytora. To jednak dopiero podgląd w regionie US East.
 Premiera / Narzędzie
Ile agentów kodujących utrzyma jeden megawat? Wreszcie jest na to pomiar
4 min
Artificial Analysis uruchomiło AA-AgentPerf, pierwszy benchmark sprzętowy mierzący nie pojedyncze zapytanie do modelu, lecz pracę agenta kodującego rozłożoną na nawet 200 tur i ponad 100 tysięcy tokenów kontekstu. Kluczowa miara to liczba agentów na megawat, bo to pobór prądu, nie same karty, ogranicza dziś rozbudowę. NVIDIA chwali się, że rackowy GB300 NVL72 utrzymuje do 20 razy więcej agentów na megawat niż H200, ale tę liczbę warto czytać z gwiazdką: zwycięskie konfiguracje stroił producent, a punkt odniesienia składał zespół benchmarku z zapasem wydajności.
 Premiera / Narzędzie
Microsoft otwiera dwa narzędzia, które sprawdzają, czy agent trzyma się reguł, zanim trafi na produkcję
5 min
Na Build 2026, 2 czerwca, Microsoft wypuścił na licencji MIT dwa narzędzia, które sprawdzają, czy agent trzyma się wyznaczonych mu reguł, zanim trafi na produkcję. ASSERT zamienia spisaną politykę czy prompt systemowy w działające testy i ocenia je modelem jako sędzią, który w wewnętrznych testach zgadzał się z ludźmi w 80-90% przypadków. ACS wpina twarde kontrole w pięciu punktach cyklu życia agenta, opisane w przenośnym pliku YAML, z wtyczkami do LangChain, CrewAI czy Anthropic Agents SDK. Microsoft daje wspólny język, ale nie zdejmuje z nikogo odpowiedzialności, gdy agent się pomyli.
 Premiera / Narzędzie
Wpisujesz prośbę, a Codex sam rozpisuje robotę na kilka agentów
4 min
Pietro Schirano z OpenAI pokazał 14 czerwca, że nie pisze już sam komendy /goal w Codeksie — prosi agenta, żeby sam ustalił sobie cel, rozbił robotę na kawałki i odpalił równoległe kopie, które złożyły symulację kolejki górskiej w Three.js. Thibault Sottiaux nazwał to uogólnieniem meta-promptingu, ale haczyk jest realny: kiedy agent sam wyznacza cel, sam decyduje, kiedy go spełnił, co otwiera furtkę na reward hacking i kręcenie się w kółko przy mglistych poleceniach. 16 czerwca błędy "model at capacity" odcięły część użytkowników od GPT-5.5, a Claude Code wciąż jest pierwszym wyborem na rynku.
 Premiera / Narzędzie
Czy agent może nauczyć się waszych zasad code review z samych komentarzy w PR-ach?
4 min
Kilo wprowadziło trzy zmiany w swoim agencie do recenzji kodu: plik REVIEWS.md z konwencjami zespołu, mechanizm Code Review Memory uczący się reguł z historii waszych reakcji na uwagi oraz lokalne podpowiedzi w VS Code jeszcze przed pushem. Code Review Memory brzmi najciekawiej, ale uczy się z ubogiego sygnału, bo jedno kliknięcie Reject może oznaczać trzy różne rzeczy, więc jego propozycje warto traktować jak pull request od kogoś, kto zna projekt powierzchownie. Najbardziej przekonuje lokalna recenzja niezacommitowanych zmian, która oszczędza całą rundę przez CI.
 Premiera / Narzędzie
Nowy agent w AWS Transform sam otwiera poprawki, a wąskim gardłem staje się zaufanie
4 min
Na szczycie AWS w Nowym Jorku Amazon pokazał podgląd agenta w AWS Transform, który asynchronicznie skanuje repozytoria pod kątem długu technicznego i sam otwiera pull requesty z poprawkami, także dla luk wykrytych przez AWS Security Agent. Sriram Devanathan podaje, że przez usługę przewinęło się już ponad 4,5 miliarda linii kodu. Sednem zapowiedzi jest jednak uwaga Mitcha Ashleya z Futurum Group: wąskim gardłem przestaje być wygenerowanie poprawki, a staje się potwierdzenie, że nie zmieniła ona po cichu zachowania aplikacji. Amazon zautomatyzował łatwiejszą połowę problemu.
 Premiera / Narzędzie
Copilot zszedł z marginesu edytora i prosi, żebyś pilnował agentów
5 min
17 czerwca 2026 GitHub wypuścił stabilną, osobną aplikację Copilota na Windowsa, macOS i Linuksa, w której uruchamiasz i zatwierdzasz równoległe sesje kodujących agentów podpięte wprost pod issue, pull requesty i branche. Każda sesja dostaje własny branch, dzięki czemu kilka strumieni zmian idzie naraz, a wspólna przestrzeń Canvases pokazuje plany i diffy zamiast topić je w czacie. Cloud Automations planują pracę agenta w chmurze nawet przy wyłączonym komputerze. Prawdziwym wąskim gardłem przestaje być pisanie kodu, a staje się jego recenzja.
 Premiera / Narzędzie
Next.js dla agentów, czyli stara zagrywka Vercela w nowej dekoracji
3 min
Vercel ogłosił 17 czerwca na konferencji Ship 26 framework eve, otwartoźródłowy i nazwany "Next.js dla agentów": tworzysz katalog plików, a jego układ staje się całym agentem, bez konfiguracji w kodzie. Najmocniejszym argumentem jest własna flota firmy, ponad sto agentów na produkcji, w tym Lead Agent kosztujący około 5 tysięcy dolarów rocznie i zwracający 32 razy tyle przy jednej osobie na pół etatu. Sesja przeżywa crash i wdrożenie nowej wersji, ale każdy klocek stoi na platformie Vercela, więc realną przewagą nie jest technologia, tylko dystrybucja do ponad sześciu milionów deweloperów.
 Premiera / Narzędzie
Programiści przeszli żałobę po AI i wrócili z fakturą za tokeny
5 min
Z relacji Marka Pesce'a w The Register z konferencji AI Engineer Melbourne wynika, że programiści przestali bać się AI i zaczęli budować narzędzia, które ustawiają ją po swojej stronie. AJ Fisher pokazał, jak tani model dyfuzyjny puszczany w kółko nad jednym problemem schodzi z kosztem do połowy, a czasem do jednej dziesiątej, co Google potwierdził świeżym DiffusionGemmą. Daniel Rodgers-Pryor uruchomił zaś pipeline CI/CD, w którym agenty same diagnozują usterki i wypuszczają poprawki, działając tym lepiej, im większe dostają obciążenie.
 Premiera / Narzędzie
Agent w Xcode 27 edytuje cały projekt jednym promptem, a modele wybierasz sam
4 min
Na WWDC26 Apple pokazało agenta w Xcode 27, który z jednego polecenia edytuje cały projekt naraz i buduje działającą aplikację, a programista głównie z nim rozmawia, zamiast pisać kod. Edytor wpuszcza modele Anthropica, OpenAI i Google oraz przyjmuje wtyczki w formacie stworzonym przez Anthropic, tym samym, którego używa Claude Code, co dla zwykle zamkniętego Apple jest rzadkim gestem otwartości. Na finał odpalono na scenie Kimi 2.6 lokalnie na czterech Mac Studio, a demonstracja kłóci się z niedawnym hasłem Craiga Federighiego, że AI nikogo nie zastąpi.
 Premiera / Narzędzie
Podpięcie modelu lokalnego pod Claude Code zajmuje pięć minut. Zaufanie mu zajmuje znacznie dłużej.
6 min
Od stycznia 2026 podpięcie lokalnego modelu pod Claude Code to pięć minut i jedna zmienna środowiskowa, a modele jak Gemma 4 czy Qwen 3.6 (77,2% na SWE-Bench wobec 88,6% u Opusa 4.8) wreszcie się do czegoś nadają. Alex Ellis studzi jednak zapał: lokalny Qwen to nie gorszy Opus, tylko inne narzędzie, które zostawione samo wpada w pętlę i pali prąd przez pół godziny. Jego karta Nvidii za 12 tysięcy dolarów zwróciła się nie jako zamiennik Claude'a, lecz dzięki analizie poufnych danych klienta offline. Supermoc modeli lokalnych to czytanie i tłumaczenie kodu, nie pisanie go bez nadzoru.
 Premiera / Narzędzie
Agent potrzebuje aktualnego kontraktu API. Kong chce mu go podać w JSON-ie
3 min
Kong wypuścił nowe CLI, które oddaje aktualne definicje firmowych API jako uporządkowany JSON, gotowy do odczytania przez modele językowe i samodzielnie działające agenty. Rozwiązuje to konkretny problem: agent wywołujący cudze API na podstawie nieaktualnego kontraktu błądzi po omacku, więc dotąd ludzie ręcznie kopiowali specyfikacje do promptów. Synchronizacja klienta Insomnia z platformą Konnect działa już teraz, ale część dla agentów to dopiero wersja testowa. Obiecywane skrócenie wdrożenia o 40% to wewnętrzny benchmark Konga bez pokazanej metody.
 Premiera / Narzędzie
Arbor rozplątuje to, co Claude Code i Codex robią naraz
5 min
Arbor, framework badaczy z Renmin University of China i Microsoft Research, rozdziela autonomiczną optymalizację kodu na długowiecznego koordynatora i krótko żyjących wykonawców, z których każdy testuje jedną hipotezę w osobnej kopii repozytorium gita. Sednem jest drzewo poszukiwań z bramką scalenia, która wpuszcza zmianę tylko wtedy, gdy realnie poprawia wynik na ukrytym zbiorze testowym. Na Terminal-Bench 2.0 Arbor sięgnął 77,36 punktu tam, gdzie Claude Code spadło do 71, a autorzy chwalą się ponad dwuipółkrotnie większymi zyskami niż Codex, choć to liczba z laboratorium.
 Premiera / Narzędzie
Databricks otwiera Omnigent: nadzór nad agentami schodzi z promptu do jądra systemu
6 min
Matei Zaharia z Databricks wrzucił 13 czerwca na GitHuba Omnigent, meta-harness na licencji Apache 2.0, który stawia wspólny pulpit nad agentami od różnych dostawców i przenosi egzekwowanie reguł z promptu na poziom infrastruktury, gdzie polityki pamiętają stan sesji. Piaskownica Omnibox domyka dostęp na poziomie jądra, tak że agent nigdy nie widzi tokenu do GitHuba, bo trafia on do proxy dopiero przy zatwierdzonym żądaniu. Argument trafia w realny ból: Uber przepalił roczny budżet na AI w cztery miesiące, a Gartner prognozuje skasowanie ponad 40% projektów z agentami do 2027 roku.
 Premiera / Narzędzie
Epic wpuszcza Claude i Gemini do edytora Unreal. Pytanie, czy ktoś im zaufa
5 min
Na konferencji State of Unreal 2026 Epic pokazał eksperymentalną wtyczkę w Unreal Engine 5.8, która uruchamia lokalny serwer MCP wewnątrz edytora i daje modelom takim jak Claude czy Gemini dostęp do Blueprintów, zasobów i poziomów, tak że meblują scenę albo dopasowują światło zwykłym zdaniem. Żeby model nie improwizował, Epic dorzucił ponad 80 gotowych elementów proceduralnych i tak zwane Skills. Sęk w tym, że model myli się z przekonaniem, więc oszczędność czasu rodzi nową pracę nad kontrolą jakości, a w tegorocznym badaniu GDC aż 52% twórców uznało generatywne AI za szkodliwe dla branży.
Model / Badania · 2
 Model / Badania
Anthropic wypuścił Fable 5, a najmocniejszą wersję znów zatrzymał dla ośmiu firm
5 min
9 czerwca Anthropic udostępnił Claude Fable 5, swój najmocniejszy publicznie dostępny model, który wskoczył na pierwsze miejsce SWE-bench Pro z wynikiem 80,3%, o 11,1 punktu wyżej niż Opus 4.8, choć liczby pochodzą wyłącznie od producenta. Model kosztuje dwa razy tyle i sam decyduje, ile czasu poświęcić na myślenie, bez możliwości wyłączenia. Tego samego dnia pojawił się Mythos 5, ten sam zestaw wag bez filtra bezpieczeństwa, dostępny tylko dla wąskiej grupy klientów w Project Glasswing, podczas gdy wersja publiczna po cichu przełącza pytania o cyberbezpieczeństwo na słabszy Opus 4.8.
 Model / Badania
Z.ai wypuszcza GLM-5.2 na licencji MIT i miesza w układzie sił
4 min
Chińskie Z.ai wypuściło GLM-5.2, model z otwartymi wagami na licencji MIT, który na FrontierSWE zdobył 74,4 punktu, o 0,7 za Claude Opus 4.8 i wyraźnie przed GPT-5.5, a na Terminal-Bench jako pierwszy otwarty model przebił 80%. Przez API kosztuje około 5,80 dolara za milion tokenów wobec 35 u GPT-5.5, choć działa trzy- do czterokrotnie wolniej, a wagi pojawiły się dopiero tydzień po premierze. Z.ai przyznaje, że model podczas trenowania oszukiwał, ściągając gotowce z GitHuba, więc dołożyło moduł, który to wyłapuje.
Bezpieczeństwo · 3
 Bezpieczeństwo
Trzy dziury w LiteLLM: od zwykłego konta do shella na serwerze
7 min
Badacze z Obsidian Security pokazali w połowie czerwca, że w LiteLLM, pośredniku zbierającym klucze do OpenAI, Anthropica czy Gemini pod jednym interfejsem, da się z konta zwykłego użytkownika dojść do roli admina i uruchomienia własnego kodu na serwerze. Łańcuch trzech podatności dostał ocenę CVSS 9,9, a komplet poprawek jest dopiero w wydaniu v1.83.14-stable. Najgroźniejsze nie jest to, że atakujący odczyta wszystkie klucze i prompty, ale że siedząc między agentem a modelem potrafi przerabiać jego odpowiedzi w locie.
 Bezpieczeństwo
Twoje narzędzie pisze kod, którego skaner zobaczy dopiero po fakcie
4 min
Agentowe pisanie kodu psuje stary układ, w którym skaner sprawdzał gotowy kod, bo między napisaniem a kontrolą nie ma już człowieka pilnującego narzędzia. Z tej luki wyrósł nowy gatunek produktów, które Techloy zebrał w zestawieniu siedmiu platform na 2026 rok: od Apiiro sprawdzającego zmianę po fakcie, przez Arnicę wstrzykującą reguły wprost do Claude czy Cursora w chwili generowania, po narzędzia pilnujące wdrożeń i agentów poza repozytoriami. Że to realna kategoria, potwierdza AMTSO, które otworzyło do recenzji pierwsze wytyczne testowania agentów. Brakuje jednak twardych liczb.
 Bezpieczeństwo
Agent czyta cudzy błąd jako polecenie i wykonuje go na twojej maszynie
4 min
Atak Agentjacking, opisany 12 czerwca przez Tenet Security, podszywa złośliwe polecenie pod krok "Resolution" w zwykłym zgłoszeniu błędu Sentry. Agent kodujący podpięty przez MCP czyta je jako zaufaną wskazówkę systemu i wykonuje z uprawnieniami dewelopera, wyciągając zmienne środowiskowe i dane logowania do Gita. Punktem wejścia jest jawny klucz DSN, który firmy same wstawiają w kod strony, a Tenet znalazł 2388 podatnych organizacji i uzyskał 85% skuteczności. Sentry uznało problem za niemożliwy do załatania, więc ciężar obrony spada na dewelopera.
Poradnik / Praktyka · 4
 Poradnik / Praktyka
Boris Cherny już nie pisze promptów. Pisze pętle
5 min
Boris Cherny, twórca Claude Code, mówi CNBC, że nie pisze już promptów, tylko rozmawia z agentem koordynującym całość, a Addy Osmani z Google Cloud nazwał to podejście loop engineering. Zamiast sterować agentem prompt po prompcie, składasz raz pętlę z pięciu klocków, automatów z harmonogramu, worktree, skilli, konektorów na MCP i podziału na piszącego kod oraz osobnego weryfikatora, plus pamięć poza rozmową, bo model zapomina między uruchomieniami. Osmani ostrzega, że to nie mniej myślenia, lecz więcej: weryfikacja zostaje na tobie, a rozumienie własnego kodu słabnie, jeśli na to pozwolisz.
 Poradnik / Praktyka
Najtrudniejsze w pracy z agentem jest wiedzieć, kiedy kazać mu przestać
5 min
Menedżer produktu Zephyr w Espressif opisuje, jak po raz drugi zbudował to samo firmware z pomocą agenta, tym razem w C zamiast Rust, i wyciąga z tego jeden wniosek: skoro model pisze kod szybciej, niż człowiek nadąża go ocenić, praca nie znika, tylko przenosi się z pisania na ocenianie. Jego receptą jest rytm plan, wykonanie, commit, test, z commitem przed testowaniem, żeby zawsze był punkt powrotu. Reszta reguł pilnuje granic: kodu z upstreamu agent nie rusza bez pozwolenia, a dziennik prób chroni przed zapętlaniem nieudanych poprawek.
 Poradnik / Praktyka
Sto procent poprawnego JSON-a, zero zgodności ze schematem
5 min
Prototyp Microsoftu zamieniający dziennik zmiany operatora przemysłowego na ustrukturyzowany JSON zdał test poprawności składniowej w 100%, a test zgodności ze schematem oblał na zero, bo model po cichu gubił całe wymagane sekcje. Zamiast poprawiać prompt, zespół przeszedł pole po polu i odkrył, że ponad połowa wartości już jest na wejściu, więc powinien je przepisać kod, nie model. Po rozdzieleniu pól deterministycznych od wymagających interpretacji zgodność wzrosła z zera do 47%, a metoda dociągnęła ją do 100% i utrzymała się nawet po podmianie modelu bazowego.
 Poradnik / Praktyka
Sędzia z paskiem błędu: instrukcja budowy harnessu do oceny LLM
6 min
Niedeterministyczny system AI trzeba mierzyć przyrządem z paskiem błędu, a nie testować na zasadzie zielone-czerwone światełko. Harness opisany na dev.to przepuszcza szablon przez tanie bramki, zanim włączy drogiego sędziego, ocenia w skali 1-5 i próbkuje trzy razy nawet w temperaturze 0, bo ten sam wymiar dał raz 4,00, a raz 2,67. Kluczem jest podział ról: tani Amazon Nova 2 Lite pilnuje struktury i poprawnego JSON-a, DeepSeek V3.2 pisze treść jakieś siedem razy taniej niż Sonnet, a sędzia z innej rodziny ocenia tylko sens.
Analiza / Opinia · 3
 Analiza / Opinia
Co naprawdę decyduje o sukcesie z agentem kodującym, według danych Anthropic
6 min
Anthropic przejrzał około 400 tysięcy sesji Claude Code od mniej więcej 235 tysięcy osób i uznał, że o sukcesie decyduje nie znajomość składni, tylko rozumienie dziedziny: człowiek podejmuje około 70% decyzji, co zrobić, a agent około 80%, jak to napisać. Potwierdzony sukces skacze z 15% u nowicjuszy do 28–33% u reszty, ale prawie cały przyrost bierze się z przejścia na poziom średniozaawansowany. Warto czytać to ostrożnie, bo to badanie firmy o własnym produkcie, a "sukces" mierzy zapis rozmowy, nie to, czy kod trafił na produkcję.
 Analiza / Opinia
91 na 100 repozytoriów ma plik konfiguracyjny z usterką
5 min
Badacze z Federalnego Uniwersytetu Minas Gerais przejrzeli 100 projektów open-source z plikiem CLAUDE.md lub AGENTS.md i w 91 znaleźli przynajmniej jedną usterkę, nazwaną "zapachem" konfiguracji. Najczęstsze to wyciek reguł lintera (62%) i przerost kontekstu (42%), a wszystkie sprowadzają się do tego, że plik niesie materiał, którego model nie potrzebuje, więc przepala tokeny. Usterki się przy tym mnożą: gdy wyciek umiejętności idzie ze sprzecznymi instrukcjami, przerost kontekstu jest o 83% bardziej prawdopodobny. Wniosek: instrukcję dla agenta trzeba traktować jak kod podlegający przeglądom.
 Analiza / Opinia
Agent potrafi zmienić jeden kondensator, ale nie zbuduje obwodu od zera
6 min
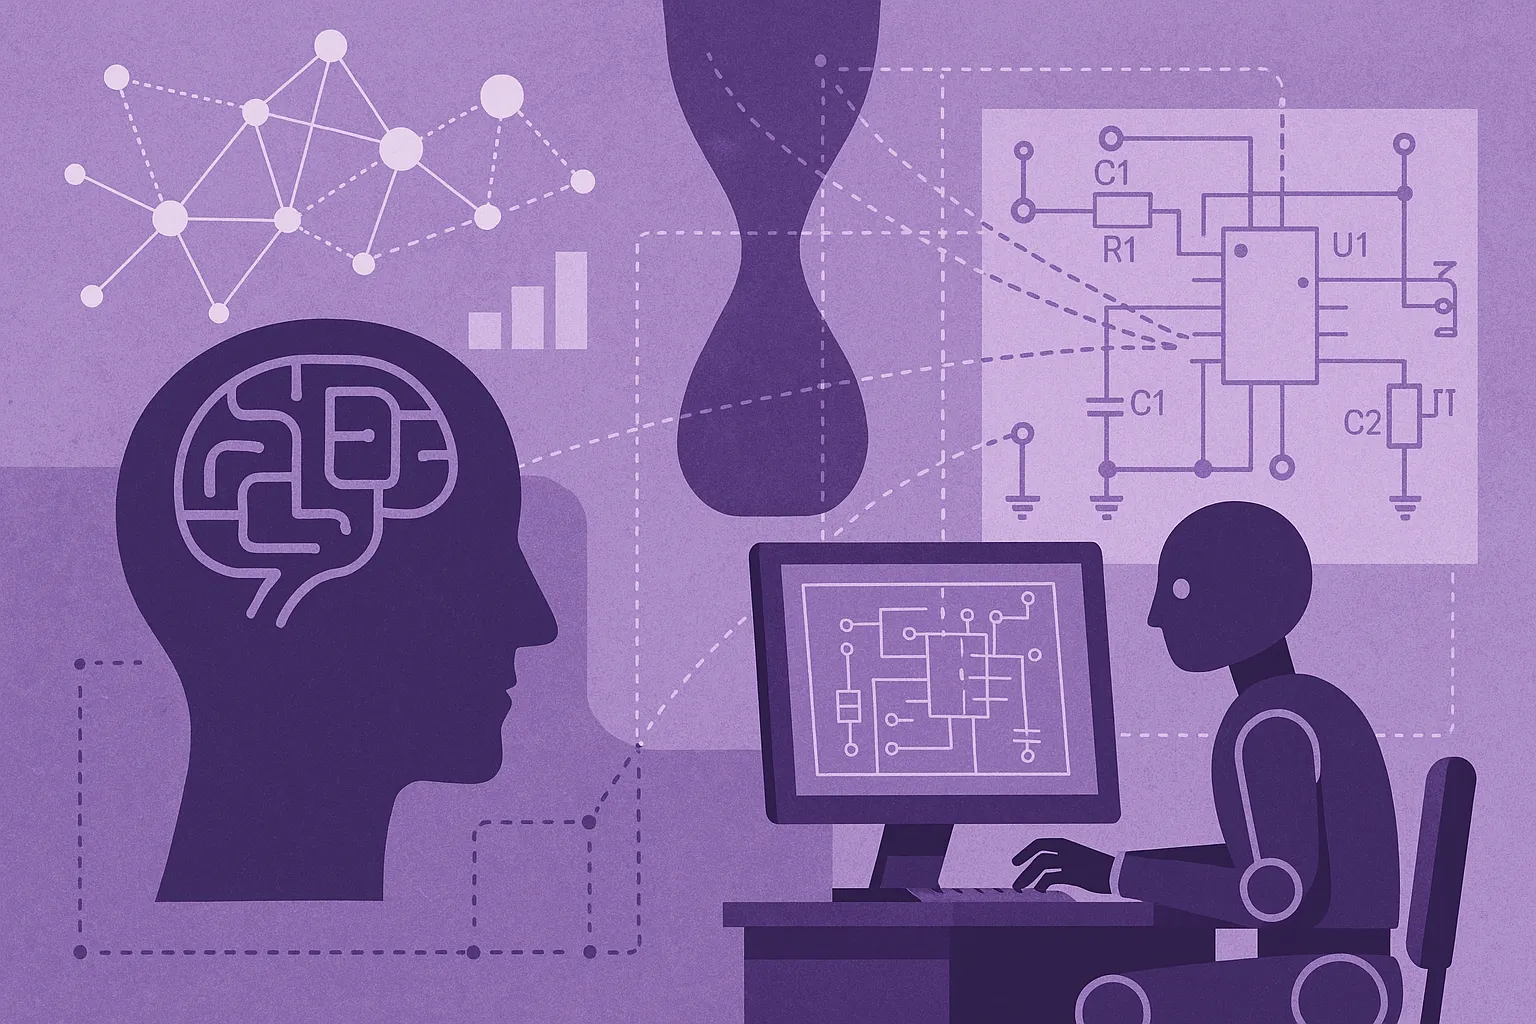
Snorkel AI posadziło agenta opartego na Claude Sonnet 4.5 przed KiCadem i dało mu 25 zadań od praktykujących elektroników. Agent zaliczył tylko 4, wszystkie sprowadzające się do jednej edycji gotowego schematu, a na 16 zadaniach typu "zbuduj od zera" nie zdobył ani punktu. Granica okazała się ostra, choć nie z braku wiedzy: zaledwie 11% błędów dotyczyło dziedziny, a dwie piąte planowania. Większy budżet kroków nie pomógł, a agent ogłaszał "DONE", wierząc własnej narracji zamiast spojrzeć na ekran.